3.3 一致性模型:从线性一致到最终一致
3.3 一致性模型:从线性一致到最终一致
"最终一致"不是一个开关而是一把尺子,本节把这把尺子的刻度画出来:从最强到最弱的一致性档位阶梯、每档给业务的读写保证,以及副本读写配额(W、R、N)这一可操作的控制手段。它是 3.2 的精细化,也是第 4、5 章配置项(读写关注、读写偏好)的理论依据。
一致性阶梯
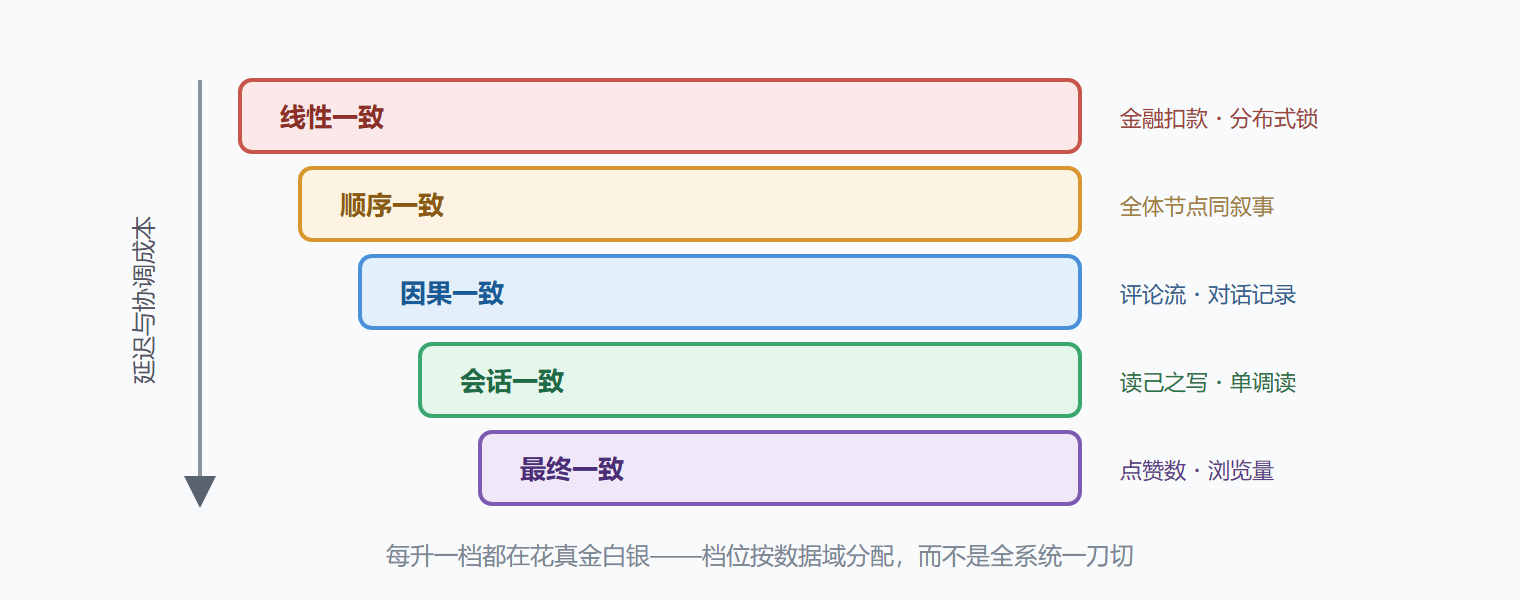
从强到弱,工程中最常用的五个档位:
线性一致(最强):所有操作表现得像在单一副本上按全局顺序执行,写入完成后任何读取立刻可见。代价是每次操作都要协调多数副本,延迟最高。金融扣款、分布式锁适合这一档。
顺序一致:所有节点看到的所有操作顺序一致(但不一定等于真实时间顺序),单客户端的读写顺序保持。"所有副本对事件的叙事相同"是它的关键性质。
因果一致:有因果关系的操作(先发帖、再评论)在所有节点上顺序一致,无关操作不保证。适合评论流、对话记录这类强依赖因果的社交数据。
会话一致(含读己之写、单调读等):同一会话(用户连接)内保证读写顺序合理——读己之写保证你刚提交的内容自己立刻可见;单调读保证同一会话不会读到"倒退"的数据。这是很多系统的默认档位,成本极低而体验价值极高。
最终一致(最弱):只承诺收敛,过程中的任何读都可能看到旧值。
为什么需要这么多档位?因为每升一档都在花真金白银:协调的副本更多、等待更久、故障时可用性更低。成熟系统的做法是把档位按数据域分配——会话资料用会话一致即可,库存计数升到线性一致,资讯 feed 用最终一致。
图:一致性档位阶梯——越往上越强,也越贵
读己之写:一个小而致命的保证
用一个反例说明会话一致的价值。用户改完昵称,页面刷新却显示旧昵称——数据其实没错(最终会收敛),但用户认定系统坏了。根因是"写主节点、读从节点"的常见架构:写入去了 A 节点,刷新读取被负载均衡到尚未同步的 B 节点。
解法通常有三种,按成本递增:读己之写路由——同一会话的读在写入后的短窗口内强制走主节点;版本戳——客户端记录上次写入的版本号,读取时若副本版本过旧则换节点重试;会话粘滞——同一会话固定路由到同一副本(副本故障时例外)。多数产品的"读写偏好 + 会话"配置组合就是这三招的参数化。
演练:用读写配额控制一致性档位
Dynamo 风格的系统(如 Cassandra)提供了一套把档位变成参数的机制:N 为副本总数,W 为写入需确认的副本数,R 为读取需确认的副本数。只要满足 W + R 大于 N,读与写必有交集,读到的至少是最新版本——这就是可调仲裁。
背景:短视频点赞计数,写多读极多,允许偶尔计数偏差,但绝不允许服务不可用。
操作:设 N=3。第一档配置 W=1、R=1:读写都只碰一个副本,延迟最低吞吐最高,但 W+R=2 小于 3,读可能拿到旧计数;第二档配置 W=2、R=2:满足仲裁,读取保证最新,延迟上升;第三档 W=3、R=1:写入最稳(任一副本活着的写入都不会丢),读最快但可能旧。
结果:该业务选第一档,前端展示容忍短暂偏差,同时定期用离线任务校正计数。
解读:三档配置对应三个真实业务答案,没有最优解。注意两个隐藏陷阱——读修复:R 个副本比较时若发现版本不一致,顺便把旧副本修好,这是最终一致收敛的重要推手;时钟依赖:副本用时间戳判定新旧,节点时钟漂移可能造成数据覆盖,NTP 同步与逻辑时钟是常见防御。
易错点
第一个陷阱是把最终一致读配上仲裁就当线性一致用:W+R>N 只保证"读到至少一个最新副本",若系统时钟不一致或读到了已回滚的写入,仍可能异常;真正的线性一致需要更严格的协议。第二个是忽视写冲突:两个客户端并发写同一键(W=1 时尤其常见),后写者胜出的裁决在副本间可能不一致,需要应用层提供不可变的键或版本号来避免冲突语义。第三个是一致性档位选完就忘:业务演变后档位不复审,强一致档的延迟成本悄悄变成性能瓶颈。
六种一致性档位速查表
一致性不是"有或没有",而是一组可选择的档位。下表从强到弱排列,配上一句话判据。
| 档位 | 一句话定义 | 典型实现 | 代价 |
|---|---|---|---|
| 线性一致 | 写入完成后的任何读都看到新值,如同单机 | 共识算法(Raft、Paxos) | 每次写入都要多数派确认,延迟高 |
| 顺序一致 | 所有节点看到相同的操作顺序,但不保证实时 | 全局有序日志 | 比线性一致略弱,延迟略低 |
| 因果一致 | 有因果关系的操作保序,无因果关系可乱序 | 版本向量、会话跟踪 | 需要跟踪因果依赖,元数据有开销 |
| 会话一致(读己之写) | 同一会话内保证读到自己的写入 | 会话粘滞 / 写后读主库 | 实现简单,跨会话仍可能读旧 |
| 单调读 | 同一客户端不会看到时间倒退 | 客户端持有已读版本号 | 需要版本信息传递 |
| 最终一致 | 停止写入后,副本终将收敛 | 异步复制 + 读修复/反熵 | 存在不一致窗口 |
演练:社交时间线上各档位的表现
用一个具体场景把档位差异跑出来:用户 A 发布一条动态,随后刷新自己的主页,用户 B 在另一个城市刷新关注流。
- 线性一致:A 刷新必然看到自己的动态;B 刷新也必然看到。代价是每次写入都要等多数派确认,写入延迟显著上升——对于每秒数十万条动态的场景,这个代价难以承受;
- 读己之写:A 刷新必然看到(写入路由到同一副本或主库),B 可能延迟几百毫秒才看到。这是社交产品最常见的选择,成本低且符合用户直觉——"我发的东西我自己能看到",别人晚一点看到无感;
- 单调读:A 刷新时如果看到过某条动态,再刷新不会"消失"。若没有这个保证,用户会看到时间线来回跳动,体验极差。实现上是客户端记住已读到的最大版本号,读取时要求副本至少追上该版本;
- 最终一致:什么都不保证,A 也可能短暂看不到自己的动态。多数产品不会接受这个档位——它通常只用于点赞数、浏览数这类"错了也无感"的数据。
因果一致值得单独提一句:在评论场景里,"评论"必须晚于"被评论的动态"出现,否则用户会看到一条指向不存在内容的评论。这就是因果关系,它需要被显式保证,而单调读与最终一致都保证不了。
选型结论:不要全局追求最强档位,而要为每类数据分别定义档位。同一系统里,账务走线性一致,动态走读己之写加单调读,计数走最终一致——这才是工程上可持续的做法。
本节要点回顾
- 五档阶梯:线性、顺序、因果、会话、最终,每升一档都在花延迟与可用性。
- 读己之写是最小可行保证:改完即见,成本极低,体验价值极高。
- 读写配额 W + R 大于 N 是把档位变成参数的手段,三档配置对应三类业务。
- 读修复与时钟问题是最终一致系统的两大工程细节。
- 档位按数据域分配并定期复审,不要一个配置用十年。
哲学与档位都有了,但业务规则要跨多个数据单元时,档位救不了——那就是事务的领地。