3.6 水平扩展:分片的艺术
3.6 水平扩展:分片的艺术
内功最后一节回到 1.2 节立下的承诺:水平扩展让容量成为加法。把承诺兑现的机制就是分片(Sharding)——按什么规则把数据切到不同节点、切错了怎么办、集群怎么再平衡。本节是通用内功的收官,第 4.6 节 MongoDB 分片与第 5.8 节 Redis 集群都是它的具体实现。
学习目标
阅读完本节,你应当能够:
- 说出范围、哈希、一致性哈希三种分片策略的原理与各自的长短板;
- 为一个具体业务选择分片键,论证热点与查询覆盖两头的平衡;
- 解释数据再平衡的触发条件与代价;
- 识别"该不该分片"这个前置问题,避免过早优化。
三种分片策略
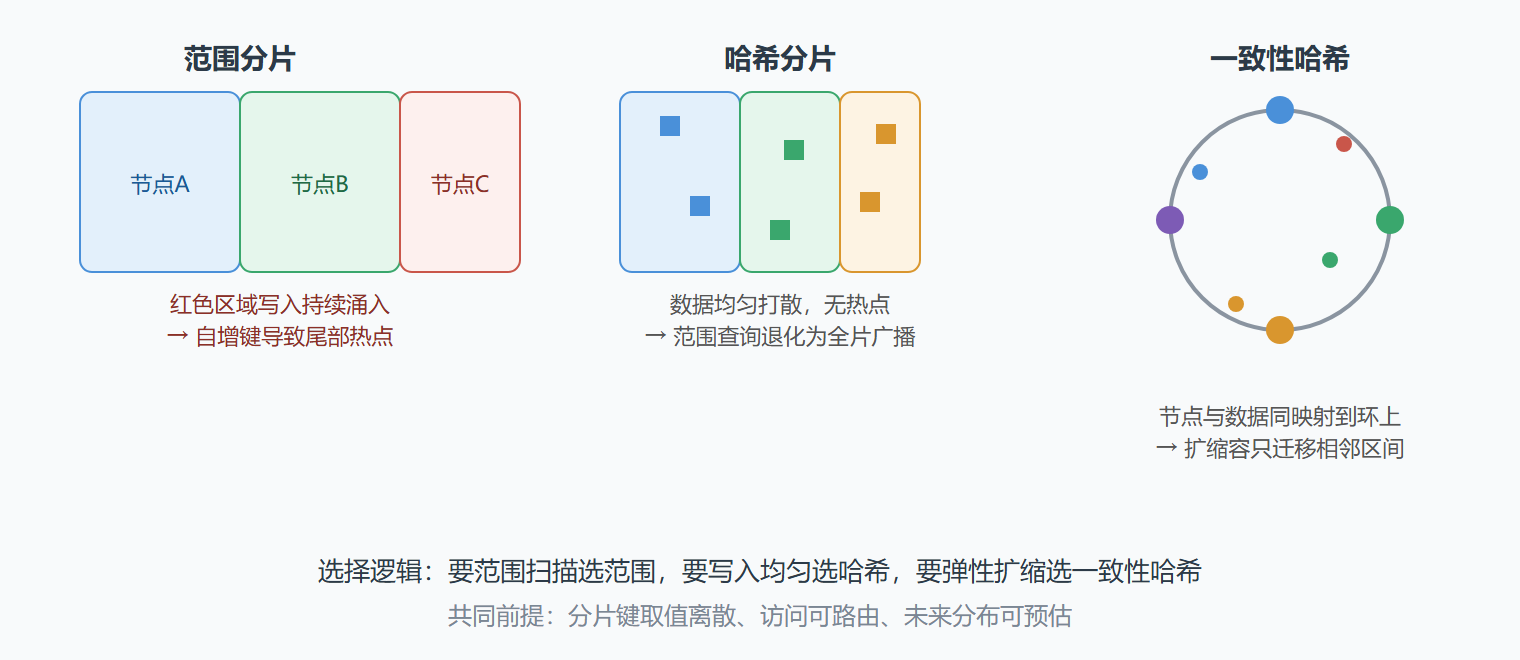
范围分片(Range):按分片键的值域切分——ID 1 到 100 万在节点 A,100 万到 200 万在节点 B。优点是范围查询友好("某时间段数据"落在连续区间);缺点是天然热点:按自增 ID 分片,所有新写入永远砸向最后一个节点。
哈希分片(Hash):对分片键做哈希后按哈希值域切分。优点是写入均匀打散,热点消失;缺点是范围查询变成全分片广播——原本"读一个用户的所有订单"变成"问遍所有节点"。
一致性哈希(Consistent Hashing):把哈希空间排成一个环,节点与数据都映射到环上,数据归属顺时针遇到的第一个节点。它的杀手锏在扩缩容:增删一个节点只迁移相邻区间的数据(普通哈希分片要迁移几乎全部数据)。Dynamo 系产品与多数分布式缓存采用此法。
图:三种分片策略的数据分布示意
分片键:一选定终身
无论哪种策略,真正的难点是选分片键,因为多数系统(MongoDB、Cassandra)的分片键建表后不可更换。选择标准是两头的平衡:
- 写入与读取要离散:分片键取值分布均匀,不出现"全网流量打一个节点"。
- 查询要可路由:最高频查询的条件里应包含分片键,否则查询退化为广播。
- 分布要可预估:业务增长不把某个值变成新的超级热点。
三个标准常常打架——用户 ID 均匀但按时间查询就广播,时间键范围友好但尾部写入热点。解法通常是复合分片键(如"用户 ID + 月份"):主维度保离散,次维度控分区大小。
演练:社交应用私信表分片设计的完整推演
背景:私信表预计三年内 50 亿行,查询模式两种——会话视图(某两人之间的消息,按时间倒序)与未读提醒(按接收者聚合未读数)。
操作:第一种候选,按消息 ID 哈希分片:写入均匀,但会话视图需要遍历所有分片,否决。第二种候选,按发送者 ID 分片:会话视图里接收方消息在另一个分片,一次会话要读两个分片再合并,勉强可用但路由复杂。最终方案:分片键取"会话 ID"(由双方用户 ID 排序拼接生成,保证同一会话双向消息同键),会话视图一次定位;未读提醒用独立的按接收者分片的统计表,发消息时同步更新(写入双份)。
结果:会话视图毫秒级;统计表承担高频未读检查;两个表各自服务一种查询,符合 3.5 节"查询清单驱动建模"的思路。
解读:注意最终方案里分片键设计解决的是路由问题,冗余表解决的是第二查询模式问题,两者分工明确。还要预判一个问题:以"会话"为分片单位,重度用户的会话更多,但单会话数据量可控(消息按时间归档),分区不会无限膨胀——分片键的粒度选择同样重要。
变式:如果三年后数据远超预期,要加节点怎么办?范围分片需要迁移区间并更新路由表(协调服务承担);一致性哈希只搬相邻区间;MongoDB 的均衡器会在后台自动搬迁块(第 4.6 节)。无论哪种,再平衡期间的性能抖动与双写窗口都要提前演练——分片方案上线前,先在测试环境模拟一次加节点。
易错点
第一个错误是过早分片:单机明明还能扛两年,团队急着上分片架构,运维复杂度先涨、收益为零;常见判断是单机写入持续超过阈值、或数据量已让备份与迁移窗口不可接受。第二个是自增键直接分片:尾部热点让集群退化为单机性能,哈希化或复合键是必修课。第三个是跨分片事务依赖:设计时放任业务做跨分片的多步写入,后期被 3.4 节的种种限制反噬;分片设计应尽量让强相关数据同片(co-location)。
三种分片策略对照
水平扩展的动作是"把数据切成多份放到多个节点",怎么切决定了后续所有的运维特性。
| 策略 | 怎么切 | 优点 | 缺点 | 适用 |
|---|---|---|---|---|
| 范围分片 | 按分片键的区间(如时间、ID 段) | 范围查询高效;扩容只加新片 | 热点集中(最新区间最热) | 日志、时序、按时间查询为主 |
| 哈希分片 | 对分片键取哈希后取模 | 数据分布均匀 | 范围查询变广播;扩容需大量搬迁 | 用户数据、订单、KV 缓存 |
| 一致性哈希 / 虚拟节点 | 哈希环 + 虚拟节点 | 扩容只搬少量数据 | 实现复杂;仍不擅长范围查询 | 分布式缓存、对象存储 |
还有一种常被忽略的维度:地理或业务分区。按地区或租户把数据固定到特定分片(如欧盟用户的数据留在欧盟节点),这不是性能优化,而是合规与数据主权要求。这类约束会直接否决掉某些分片策略,选型时必须先确认合规要求。
演练:一次再平衡(Rebalancing)
假设 4 个节点存 1024 个逻辑槽位,现在要加到 5 个节点。
- 规划迁移:按目标分布计算每个节点最终应持有约 205 个槽位,多出的槽位作为迁出候选。逻辑槽位与物理节点解耦,迁移的单位是槽位而非行;
- 逐槽迁移:一次搬一个槽位——先在目标节点建立副本并同步增量,追平后短暂锁定该槽位的写入,切换归属,解锁。单次锁定时间通常控制在毫秒级,业务几乎无感;
- 限流与观察:迁移本身消耗网络与磁盘 IO,必须限流,并观察源节点与目标节点的延迟指标。不限流的迁移常常把生产延迟打高一个量级;
- 校验与清理:迁移完成后核对槽位归属与数据条数,确认无误后删除源节点的副本,释放空间。
过程中最容易出问题的两处:一是迁移期间客户端路由信息过期,请求仍打到旧节点——需要节点返回重定向响应、客户端重试,这要求客户端协议支持;二是迁移中断(网络抖动、节点重启)后状态不一致,需要迁移任务可重入、可回滚。
扩展能力的三条边界
水平扩展不是无限的,三类负载很难靠加机器解决:跨分片的强一致事务(协调成本随节点数增长)、不带分片键的全局查询(广播代价随节点数线性增长)、以及单点写入的全局计数器(热点无法分散)。遇到这三类需求,正确做法不是继续加机器,而是改设计——加缓存层、加异构索引、或者干脆把这类负载挪到专用引擎。
本节要点回顾
- 三策略:范围(范围友好、尾部热点)、哈希(均匀、广播查询)、一致性哈希(弹性扩缩、迁移最小)。
- 分片键两标准:离散保负载均衡,可路由保查询高效;复合键是常规解。
- 分片键通常不可更换,选型前先模拟未来分布。
- 第二查询模式用冗余表/倒排表服务,别让一个分片方案背两种查询。
- 先确认必须分片再分片;上线前演练加节点的再平衡流程。
通用内功修炼完毕。下一章把镜头推近,深访文档门派的代表 MongoDB——你会看到本章所有法则的产品化长相。