4.2 数据模型:文档、集合与数据库
4.2 数据模型:文档、集合与数据库
从本节起进入操作层。先拆 MongoDB 的三级容器——数据库、集合、文档,再拆文档本身的结构单元,最后回答文档建模里最日常的问题:这个字段该嵌进来还是引用出去。3.5 节的非范式化方法论在这里落地成具体的判断规则。
三级容器
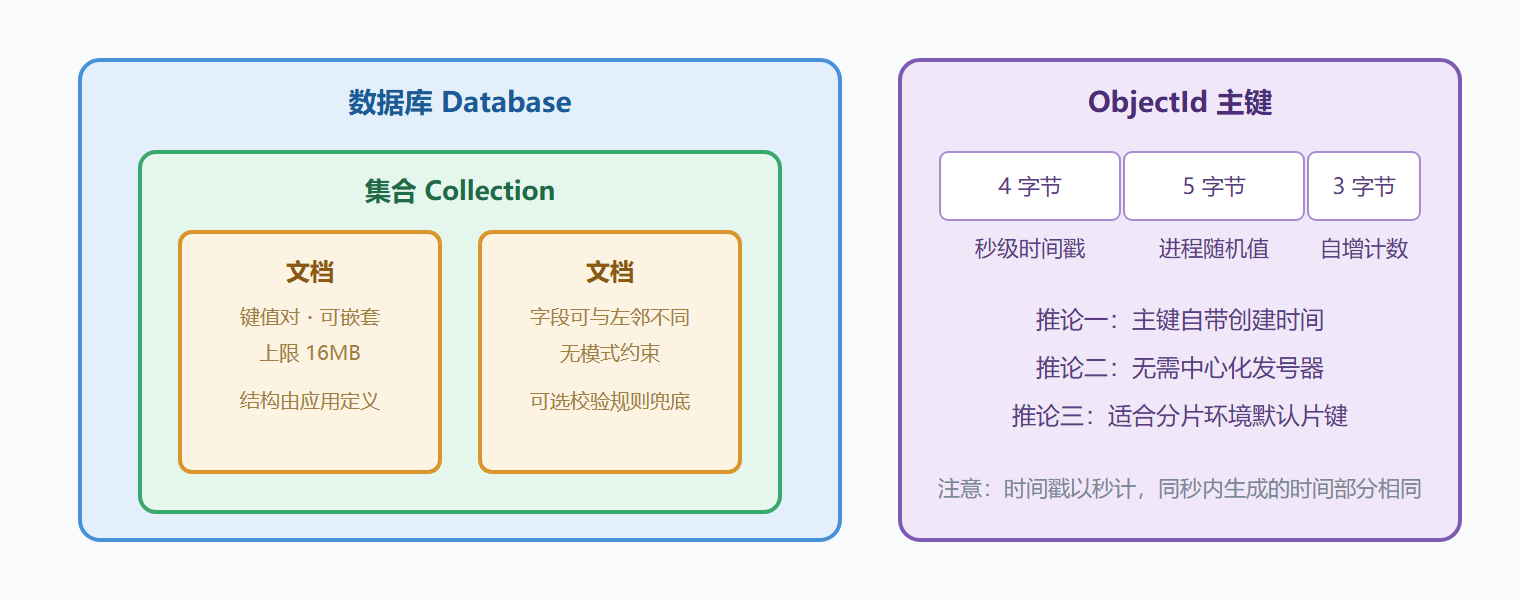
**文档(Document)**是最小单元:一组键值对,BSON 编码,上限 16MB。键是字符串(UTF-8,不能含空字符,不能以下划线外的方式与系统字段冲突——确切说 _id 是保留键);值可以是标量、嵌套文档、数组。
**集合(Collection)**装文档:无模式约束(同一集合内文档字段可异构),可挂可选的校验规则(Schema Validation)兜底结构漂移。自动创建是个双刃剑——写错集合名的插入不会报错而是静默新建集合,生产环境建议打开校验或至少走命名评审。
**数据库(Database)**装集合:一个 MongoDB 实例可承载多个数据库,权限按库划分。经验法则是按"业务域"分库、按"实体与读写模式"分集合,而不是按"模块"机械映射。
文档解剖与 ObjectId
一份文档的骨架值得逐层认识:
{ _id: ObjectId("665f1a2b3c4d5e6f7a8b9c0d"), // 12 字节主键,默认自动生成 sku: "SKU-88312", name: "轻量冲锋衣", attrs: { size: ["M","L"], waterproof: true }, // 嵌套文档 suppliers: [ { id: 1, name: "华东工厂" } ], // 文档数组 updated: ISODate("2026-08-30T10:20:00Z") }
_id 的默认值 ObjectId 值得拆开:12 字节 = 4 字节秒级时间戳 + 5 字节随机值(每进程一次)+ 3 字节自增计数。两个推论:主键自带创建时间(不用额外存 createdAt 的粗粒度版本);无需中心化发号器(随机值防多机碰撞),这正是它在分片环境里作为默认片键来源的原因之一。注意 4 字节时间戳以秒计,同秒内多个 ObjectId 的时间部分相同,用它做精确排序要小心。
图:三级容器与 ObjectId 的 12 字节结构
嵌入与引用:三问决策法
3.5 节的方法论在这里变成三问,按序自问:
一问访问模式:两者是否总被一起读?一起读是嵌入的强信号。二问增长曲线:被嵌入方的数量是否有业务上限?无上限(评论、日志、点赞流)必须引用。三问更新归属:它是否被多方独立更新?是则引用(否则写入互相干扰,1.1 演练里评论数嵌入引发的冲突就是实例)。
三问的答案组合成决策:一起读 + 有上限 + 更新少 → 嵌入;否则引用。中间地带(一起读但更新频繁)可以用"受控冗余":主数据引用、热字段冗余并明确同步责任人。
演练:从需求到集合结构的完整设计
背景:在线课程平台,实体有课程、章节、讲师、学员、学习记录。核心查询:课程详情页(课程 + 章节 + 讲师卡片)、学员课程列表(我报的课 + 进度)、课程学习页(章节内容 + 我的学习记录)。
操作:套三问。章节:只属于一门课程、一起读、数量可控(几十个内)→ 嵌入课程文档。讲师:多方共享(多门课)→ 独立集合,课程文档冗余讲师名与头像(最新语义,讲师服务负责同步)。学习记录:无限增长、只属于单个学员、更新频繁 → 独立集合,按"学员 + 课程"复合键查询;课程学习页需要的是"单学员单课程"的记录切片,记录文档按课程再分组(学员文档内嵌各课程的进度指针)。
结果:三个核心查询分别一次读取(课程详情)、一次读取(学员列表)、两次读取(学习页:课程 + 记录)命中;课程文档体积稳定(章节有限、讲师仅冗余两字段);学习记录自由增长无压力。
解读:同一实体集里,章节被嵌入而学习记录被引用——嵌入与否取决于访问模式而非实体类型。还有个细节值得回味:学员文档里的"进度指针"是第三种形态——不嵌全量数据、只嵌聚合摘要,它是嵌入与引用之间的实用折中。
变式:若产品要做"全平台学习时长排行榜",按 2.5 与 3.5 的结论,新开一张按时间窗口聚合的统计集合(定时任务写入),别在课程或学员文档里硬算。
易错点
第一个是数组无界嵌入:课程文档里嵌全部学员评价,热门课直接撞 16MB 上限;评价必须引用。第二个是滥用无限层级嵌套:嵌套超过两三层后查询路径冗长、更新复杂,扁平化到一两个嵌套层级是好习惯。第三个是依赖自动创建不建约束:字段名手滑(status 写成 stauts)静默产生脏数据;用可选校验规则兜底低级错误,成本极低。
嵌入与引用的决策表与演练
建模问题在 MongoDB 里几乎都收敛成同一个问题:这条子数据,嵌进父文档,还是单独放一个集合?
| 判据 | 倾向嵌入 | 倾向引用 |
|---|---|---|
| 子数据是否总与父数据一起读 | 是 | 否,常被单独访问 |
| 子数据数量是否有上限 | 有(几十条以内) | 无上限,会持续增长 |
| 子数据更新频率 | 低 | 高 |
| 子数据是否被多个父文档共享 | 否 | 是 |
| 是否需要对子数据单独分页/排序 | 否 | 是 |
命中任意一条"倾向引用"就该认真考虑拆出去,尤其是"数量无上限"这一条——无上限的数组会让文档无限膨胀,最终撞上 16MB 的单文档上限。
演练:博客系统的三种建模
方案一,评论全嵌入文章:文章文档里带一个 comments 数组。读文章一次拿到全部,写评论要更新整个文章文档。适合评论数稳定在几十条、且不需要单独分页的场景。风险是热门文章文档膨胀、并发评论时更新冲突。
方案二,评论独立集合 + 引用:评论集合存 article_id。查询灵活(可按用户查、可分页)、写入只改小文档。代价是读文章页需要两次查询,且"按时间倒序取最新 20 条"要靠索引支撑。
方案三,混合:文章文档内嵌最新若干条评论摘要(列表页用),完整评论放独立集合(详情页用)。
// 方案一:嵌入 { _id: "post-01", title: "建模取舍", comments: [ { user: "阿澈", text: "这段讲得很清楚", ts: ISODate("2026-09-01T09:00:00Z") }, { user: "小满", text: "我们线上就是这么踩坑的", ts: ISODate("2026-09-01T09:12:00Z") } ] } // 方案二:引用(评论集合独立,靠索引服务分页) { _id: "c-01", post_id: "post-01", user: "阿澈", text: "这段讲得很清楚", ts: ISODate("2026-09-01T09:00:00Z") } // 配套索引:按文章查评论并按时间倒序 db.comments.createIndex({ post_id: 1, ts: -1 })
三条建模经验
第一,先列查询清单再定结构。 把系统的核心查询一条条写下来(按什么条件查、查多少、要不要排序分页),结构自然就出来了。反过来做——先定结构再想查询——几乎必然返工。
第二,警惕无界数组。 评论、日志、消息、读数这类会持续增长的数据,一律不嵌。历史上大量"文档超过 16MB"的报错都源于此。
第三,冗余字段要想清楚更新路径。 冗余能换查询性能,但每加一个冗余字段,就多一处可能不同步的地方。要么放进同一事务,要么接受短暂不一致并配定时对账——不能什么都不做。
本节要点回顾
- 三级容器:数据库按业务域、集合按实体与读写模式、文档为最小单元(16MB 上限)。
- ObjectId = 时间戳 + 随机值 + 自增:自带粗粒度时间、无需发号器、适配分片。
- 嵌入引用三问决策:一起读吗?有上限吗?多方更新吗?
- 折中形态:冗余热字段(明确同步责任)与内嵌聚合摘要(进度指针)。
- 打开集合校验兜底字段手滑,是低成本高回报的纪律。
结构定了,下一节把增删改查四类操作逐个过手。