4.4 索引与查询优化
4.4 索引与查询优化
会写查询(4.3)与会把查询调快是两种能力。本节先讲索引的存储原理(为什么 B 树快、为什么排序能省内存),再给出复合索引的字段顺序法则(ESR),最后走一个完整的慢查询诊断流程。这是 MongoDB 实战性价比最高的一节——多数"MongoDB 慢"的问题,答案都在这一节里。
索引原理:有序结构换检索速度
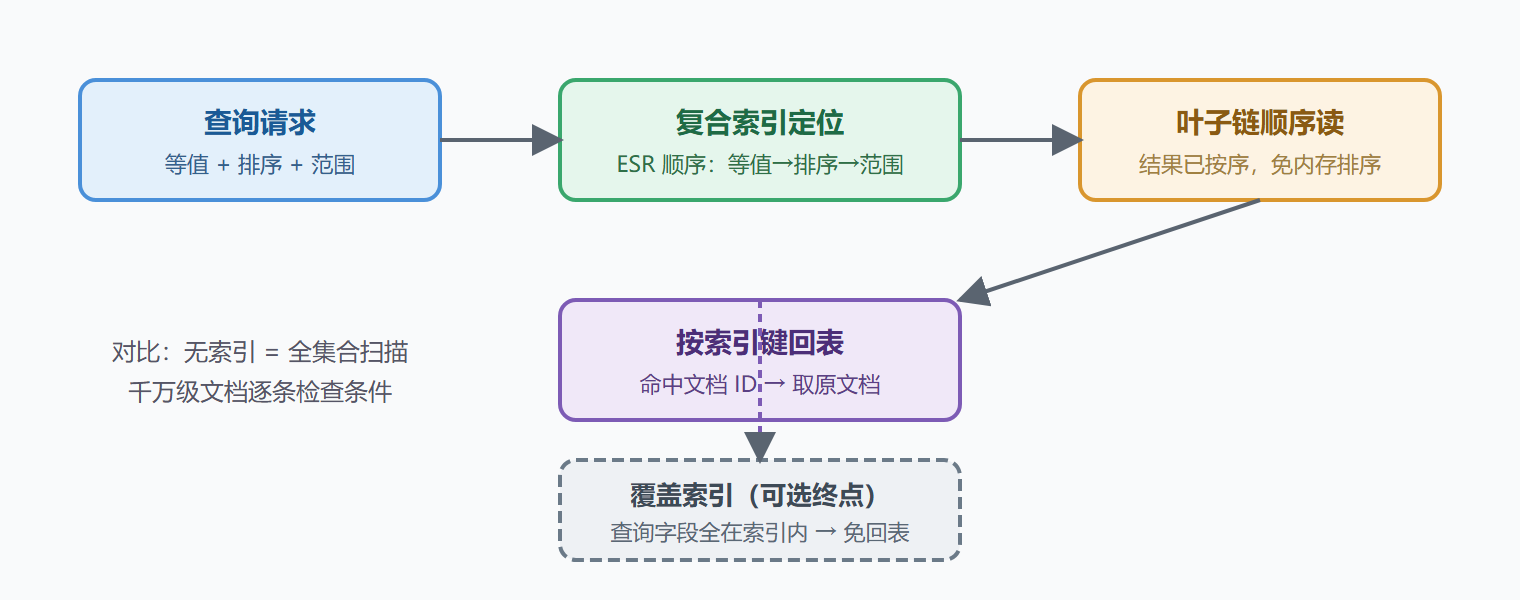
没有索引时,查询只能全集合扫描:逐个文档检查条件,数据量千万级时每次查询都是灾难。索引是把指定字段排序后单独存储的数据结构(WiredTiger 引擎下是 B+ 树变体),查询沿有序结构定位,复杂度从线性降到对数。
B+ 树的两个性质解释了很多现象。叶子节点有序且链式相连:范围查询(时间区间)与排序(sort)沿叶子链顺序读取即可,这正是"前缀正则能走索引、中缀不能"的原因——中缀匹配破坏了字典序。索引条目体积小:扫描索引比扫描全文档便宜得多,但仍然要扫——所以"低选择性字段上的索引"(如性别)效率有限,组合使用才有价值。
复合索引是重点:多个字段按声明顺序联合排序,效果像字典的"先按姓氏、再按名"。由此推出前缀规则:索引 {a:1, b:1} 可以服务"等值 a"、"等值 a + 范围 b"、"排序 a,b",但服务不了"单独查 b"。
ESR 法则:复合索引字段顺序
等值(Equality)、排序(Sort)、范围(Range)三类条件同时出现时,字段顺序按 E → S → R 排列。原因可以推出来:等值条件先把候选集砍到最小,排序字段放在等值之后可以让结果直接按索引顺序输出(省去内存排序),范围字段放最后(范围会让后续字段的有序性失效)。反过来把范围字段放中间,排序就要在内存里现做,数据量大时直接慢查询。
图:一次索引查询的执行路径
演练:一条慢查询的完整诊断
背景:订单集合 3000 万行,运营后台"按状态筛选 + 按下单时间倒序"的列表页经常 10 秒超时,其余页面正常。
操作:第一步用执行计划确认病灶——explain 的执行模式输出 COLLSCAN(全集合扫描)与 SORT 阶段(内存排序),索引缺失实锤;第二步按 ESR 建复合索引,等值字段 status 在前,排序字段 createdAt 在后:
// 诊断:确认全集合扫描与内存排序 db.orders.find({ status: "PAID" }).sort({ createdAt: -1 }) .explain("executionStats") // 输出关键字段:totalDocsExamined 高达 3000 万,executionTimeMillis 数千 // 建复合索引:等值在前,排序在后 db.orders.createIndex({ status: 1, createdAt: -1 }) // 复跑 explain:IXSCAN + totalDocsExamined 降到约 5 万,毫秒级返回
结果:查询从 10 秒级降到 10 毫秒级;explain 中 totalKeysExamined 与 totalDocsExamined 接近,返回条数与前两者比值健康。
解读:诊断三指标值得记牢——检查文档数(越接近返回数越好)、执行阶段(IXSCAN 对 COLLSCAN、无 SORT 内存阶段)、执行时间。另外这次优化后要立刻反问:这个索引服务了几个查询?若列表页有三种状态筛选组合,一个 {status, createdAt} 索引可以全部覆盖(status 等值在前),不必一查询一索引。
变式:若查询还要返回 createdAt 之外的大字段(商品快照),索引无法覆盖、必须回表,性能仍取决于返回条数——分页控制返回量永远是第一优化,索引是第二优化。
易错点
第一个是索引越多越好的错觉:每个索引都要随写入维护,写多读少的集合上索引是纯负担;定期清理零命中的索引(利用服务器的索引使用统计)。第二个是建了索引却不复核:explain 的执行模式还是 COLLSCAN,常见原因包括字段类型不匹配(字符串与数字比较)、隐式类型转换、$or 各分支字段不同。第三个是前台建索引锁业务:大集合建索引要显式后台执行(新版本默认后台行为),高峰期操作前先评估。
索引类型速查表
| 索引类型 | 用途 | 典型场景 | 注意点 |
|---|---|---|---|
| 单字段 | 最基础的等值/范围查询 | 按 customer_id 查订单 | 几乎必建 |
| 复合 | 多条件与排序组合 | 按状态+时间排序 | 字段顺序决定能否服务排序 |
| 多键 | 数组字段的元素 | 按标签查文章 | 一个文档的多个元素各占一条索引项 |
| 文本 | 全文检索 | 商品名模糊搜索 | 有分词与语言限制,复杂检索仍建议专用引擎 |
| 地理(2dsphere) | 位置查询与距离排序 | 附近的门店 | 坐标要用 GeoJSON 格式 |
| 部分(partial) | 只为满足条件的文档建索引 | 只为未取消订单建索引 | 索引体积小,但查询条件必须匹配过滤条件 |
| TTL | 到期自动删除 | 会话、验证码 | 只能用于日期字段,删除有延迟 |
演练:用 explain 判读一条慢查询
// 原始查询:按客户查已支付订单,按时间倒序取 20 条 db.orders.find({ customer_id: 90001, status: "PAID" }) .sort({ created_at: -1 }).limit(20) .explain("executionStats")
判读执行计划时只看四个数字,其余都是细节:
| 关注项 | 含义 | 健康标准 |
|---|---|---|
| totalKeysExamined | 扫了多少条索引项 | 接近返回条数 |
| totalDocsExamined | 扫了多少篇文档 | 最好为 0(覆盖查询)或接近返回条数 |
| nReturned | 返回了多少条 | 与 totalDocsExamined 的比值越大越高效 |
| executionTimeMillis | 实际耗时 | 与业务可接受阈值比较 |
若 totalDocsExamined 远大于 nReturned,说明大量文档被扫了又丢掉——要么缺索引,要么索引顺序与排序不匹配。本例的正确索引是 { customer_id: 1, status: 1, created_at: -1 }:等值条件字段在前,排序字段在后,这样索引本身有序,排序无需额外代价。
覆盖查询:把 totalDocsExamined 压到 0
如果查询只需要索引里的字段,MongoDB 可以完全不读文档,只扫索引。做法是在投影里只保留索引字段,并显式排除 _id(它默认不在复合索引里)。
// 覆盖查询:只取索引内的字段,并排除 _id db.orders.find( { customer_id: 90001, status: "PAID" }, { status: 1, created_at: 1, _id: 0 } ).sort({ created_at: -1 }).limit(20) // 期望:totalDocsExamined = 0,executionStats 显示仅扫描索引
三个常见的优化顺序建议:先让索引覆盖排序(消除内存排序)→ 再考虑覆盖查询(消除文档读取)→ 最后才加冗余字段(为覆盖查询补列)。每一步都有代价,按需前推,不要一步做到底。
本节要点回顾
- 索引 = 字段的有序副本,把线性扫描换成对数定位;叶子链让范围与排序免费。
- 复合索引前缀规则决定它能服务哪些查询;一索引多查询是设计目标。
- 字段顺序记 ESR:等值 → 排序 → 范围;顺序错了排序进内存,秒级劣化。
- 诊断三指标:检查文档数、执行阶段、执行时间,explain 是唯一裁判。
- 索引是写入税:建一个要养一个,定期清理零使用索引。
单机性能到顶后就是分布式的天下——下一节复制集,MongoDB 高可用的基石。