2.3 标准库与第三方库
2.3 标准库与第三方库
本节摘要:写任何功能之前先问一句:这轮子是不是早有人造好了?本节先逛标准库——随解释器自带的官方零件库,重点演示轻记账马上要用的 datetime、csv、os 三个模块;再讲第三方库与标准库的分界:什么时候直接用官方的,什么时候值得引入外部依赖。轮子意识决定开发效率,也决定项目的依赖体积。
先把目标钉住
阅读完本节,你应当能够:
- 用 datetime 获取与格式化日期时间,给账目自动打上日期
- 用 csv 模块把账目导出成表格文件
- 说出标准库与第三方库的取舍标准
- 养成"先查标准库再找第三方"的动手顺序
为什么这一节放在持久化之后
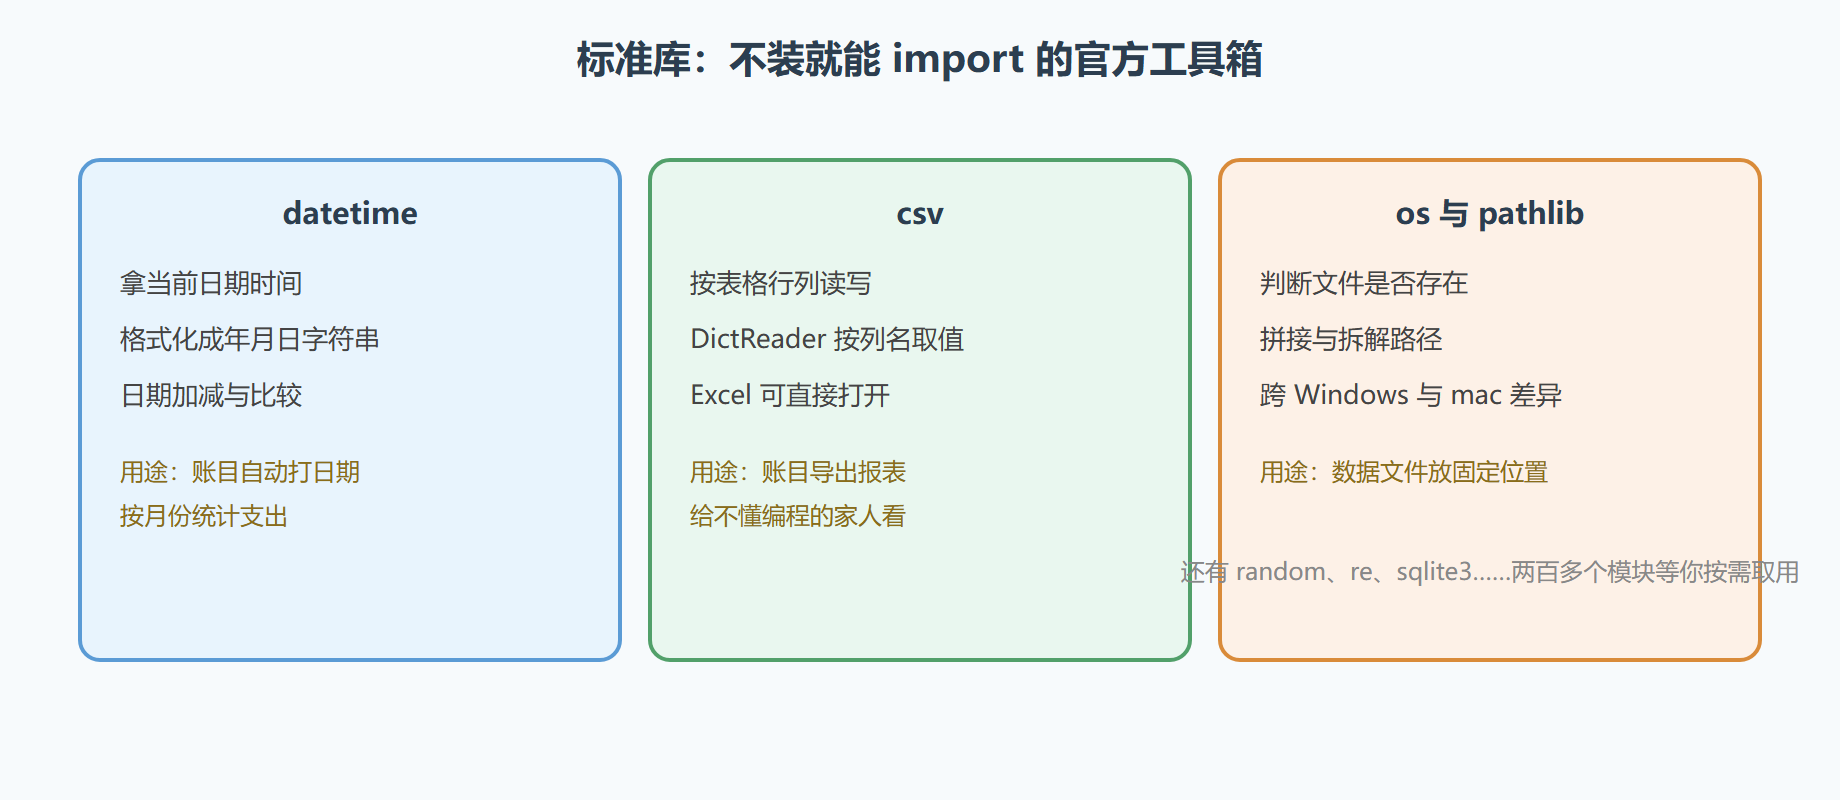
轻记账刚学会把数据存进 JSON 文件(2.1),马上冒出三个新需求:每笔账自动记日期、能导出成 Excel 能开的表格、数据文件最好放在固定位置而不是脚本旁边。这三件事 if 分支和 while 循环帮不上忙——它们属于系统交互:日期、文件系统、数据格式。而这些恰是标准库的主场。Python 一贯的哲学"自带电池"在本节具象化:不装任何东西,import 就能用两百多个模块。
图 2-3 轻记账用到的标准库零件
datetime:给每笔账自动打日期
from datetime import date, datetime today = date.today() print(today) # 2026-09-02 print(today.strftime("%Y年%m月%d日")) # 2026年09月02日 now = datetime.now() print(now.isoformat()) # 2026-09-02T14:30:05.123456 —— 存库常用
strftime 里的占位符记三个就够日常用:%Y 四位年、%m 两位月、%d 两位日。日期对象之间能直接比较和相减,"算这个月花了多少"就是比较月份前缀或做日期范围过滤:
record_date = date(2026, 9, 1) print(record_date < today) # True print((today - record_date).days) # 1 —— 相差一天
csv:账目导出成表格
JSON 是给程序读的,csv 是给人读的——Excel 双击就能打开:
import csv ledger = [ {"item": "早饭", "amount": 12.5, "date": "2026-09-01"}, {"item": "地铁", "amount": 4.0, "date": "2026-09-01"}, ] with open("export.csv", "w", newline="", encoding="utf-8-sig") as f: writer = csv.DictWriter(f, fieldnames=["date", "item", "amount"]) writer.writeheader() writer.writerows(ledger)
两个不写就出事的细节:newline="" 防止 Windows 下出现空行;编码用 utf-8-sig 让 Excel 正确识别中文。导出的表格第一行是 date、item、amount 三列标题,下面每行一笔账——这就是给家人看的"报表"。
标准库还是第三方库:一把尺子
轻记账将来要用 Web 框架、数据库连接池,这些标准库没有或不好用,得引入第三方库(下一节讲怎么装)。取舍的尺子有三条:
- 看覆盖:标准库有够用的实现就先用它,datetime、csv、json、os 这类基础需求别引依赖
- 看成熟度:标准库方案不满足时,选社区久经考验的库(第 4 章的 Flask、第 5 章的 SQLAlchemy 都是),别为了小需求拉进没人维护的包
- 看传染性:每加一个第三方库,就多一份"安装、升级、漏洞公告"的长期成本。依赖是负债不是资产,够用就好
演练:给轻记账补上日期与导出
from datetime import date import csv def add_record(ledger, item, amount): ledger.append({ "item": item, "amount": amount, "date": date.today().isoformat(), # 自动打上当天日期 }) def export_csv(ledger): with open("export.csv", "w", newline="", encoding="utf-8-sig") as f: writer = csv.DictWriter(f, fieldnames=["date", "item", "amount"]) writer.writeheader() writer.writerows(ledger) print("已导出 export.csv") def month_total(ledger, month): # month 形如 "2026-09" return sum(r["amount"] for r in ledger if r["date"].startswith(month)) ledger = [] add_record(ledger, "早饭", 12.5) print(month_total(ledger, "2026-09")) # 12.5
变式一:加"统计"指令,输入月份输出该月总额与笔数。变式二:用 os.path.join 把数据文件定位到用户目录下的专属文件夹,体会"路径交给库拼,不手工拼字符串"的稳健。
易错点清单
- strftime 与 strptime 混淆:前者格式化输出,后者把字符串解析成日期对象,方向相反
- csv 忘了 newline="":Windows 下每行之间多一个空行
- Excel 打开中文乱码:编码写成 utf-8-sig 而不是 utf-8
- 重复造轮子:手写日期计算、手拼路径、手拆 csv 字符串——先搜标准库文档再动手
本节要点回顾
- 先查标准库再找第三方:datetime、csv、os 是轻记账的三大件
- strftime 控制格式,isoformat 是存档首选
- csv 导出三细节:DictWriter、newline、utf-8-sig
- 依赖是负债:覆盖、成熟度、传染性三条尺子量一量再引入
- 轮子意识:动手写通用逻辑前,默认答案已经存在
官方零件用上了,第三方零件怎么装、怎么不让多个项目打架?下一节讲 pip 与虚拟环境。