6.4 Docker 容器化
6.4 Docker 容器化
本节摘要:"在我电脑上是好的"是协作史上最著名的扯皮开场白——环境差异是根因。Docker 把应用连同解释器、依赖、配置打成一只标准集装箱:本机构建、处处一致。本节讲镜像与容器的核心概念,给轻记账写出第一个 Dockerfile,用一条命令在陌生机器上拉起完整服务。
动手前先定目标
阅读完本节,你应当能够:
- 区分镜像与容器,说出容器与虚拟机的差异
- 读懂并编写一个 Dockerfile
- 构建、运行轻记账容器,映射端口与注入环境变量
- 解释"一次构建,处处运行"的工程价值
- 描述镜像分层与缓存对构建速度的影响
问题:环境漂移是协作的宿敌
6.3 的部署流程走通了,但回头看它有多脆:新服务器要重演六步;Python 小版本不同可能报怪错;系统库缺一个,服务起不来;同事本机跑不通你的项目,排查半天发现是系统差异。这些问题的共性是:代码与它的运行环境是分离的,靠文档和纪律缝合,缝不严就漂移。Docker 的思路釜底抽薪:把环境本身也做成"构建产物"——一个包含操作系统层、Python、全部依赖、你的代码的镜像。镜像在任何装了 Docker 的机器上行为完全一致。
图 6-4 镜像、容器与分层的全景
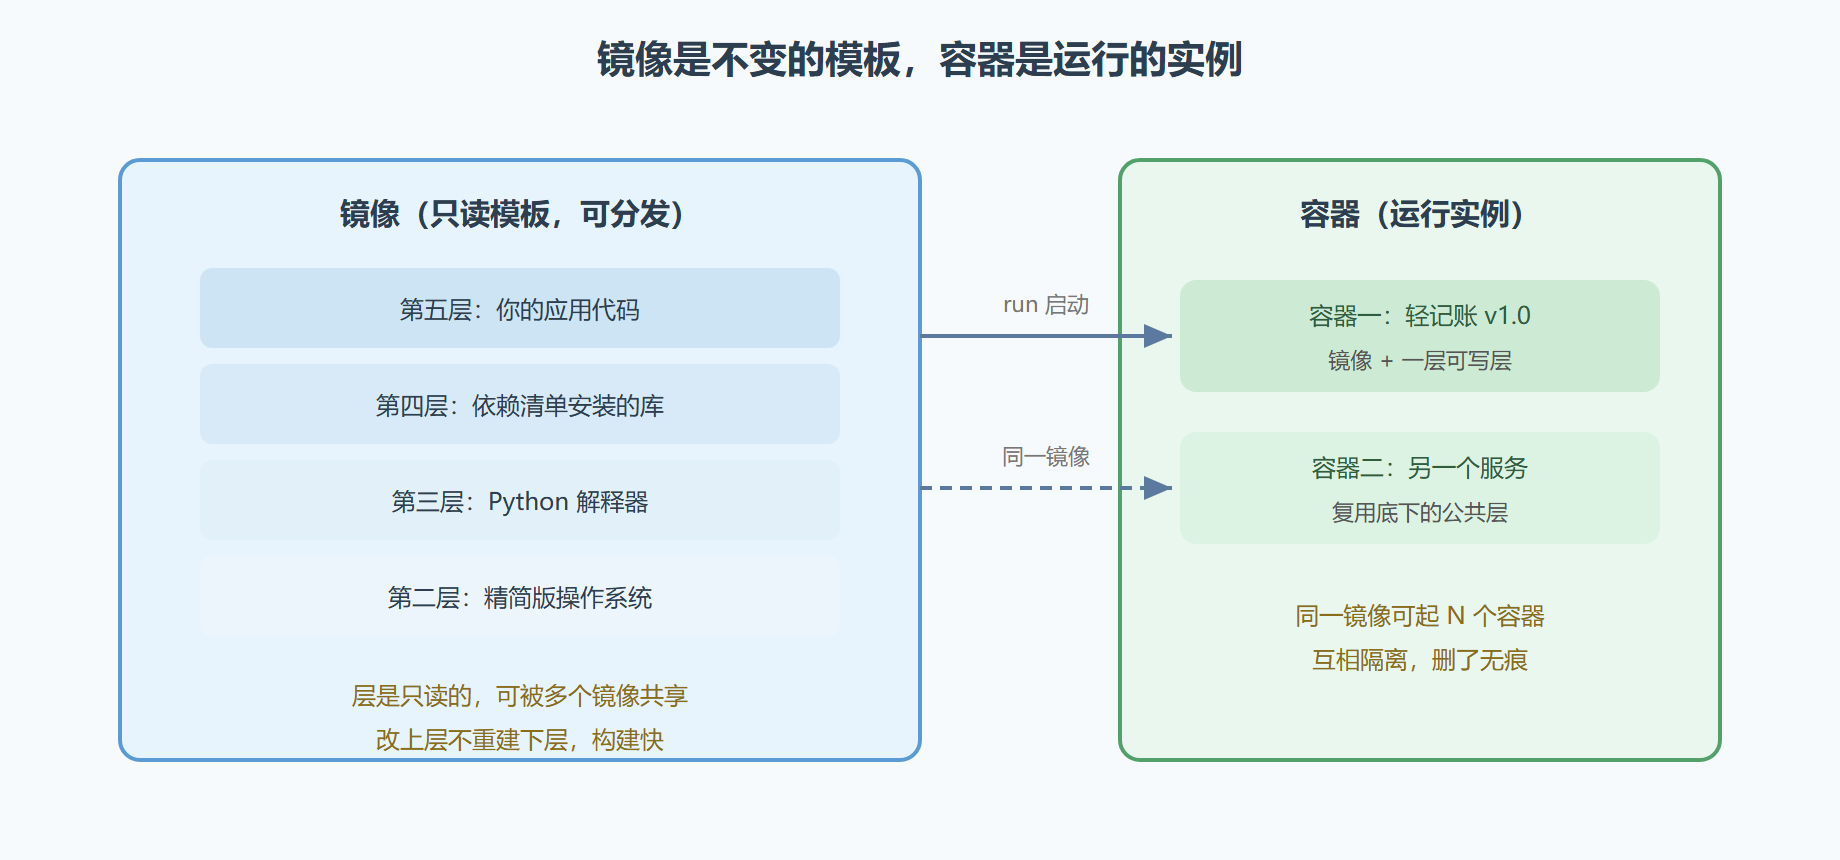
容器与虚拟机的区别一句话:虚拟机连操作系统一起虚拟,一只"箱子"以 GB 计;容器共享宿主内核,只封装应用层,MB 级、秒启动——轻量是它席卷全行业的根本原因。
Dockerfile:镜像的配方
项目根目录写一个描述文件,声明怎么一层层搭出镜像:
FROM python:3.12-slim # 基础:官方精简 Python 镜像 WORKDIR /app # 容器内的工作目录 COPY requirements.txt . # 先只拷依赖清单 RUN pip install -r requirements.txt # 装依赖(独立成层,配合缓存) COPY . . # 再拷全部代码 EXPOSE 8000 # 声明服务端口(文档性质) CMD ["gunicorn", "--workers", "4", "--bind", "0.0.0.0:8000", "应用包:create_app()"]
两个讲究。其一,依赖清单先于代码拷贝:层有缓存,代码天天改但依赖很少变——先装依赖的层被缓存命中,改代码后的重建只重做最后一层,从几分钟缩到几秒。倒过来写(先 COPY 全部再装依赖),改一行注释都要全量重装。其二,CMD 绑 0.0.0.0:容器内的服务要对容器外可见,必须监听所有网卡——6.3 里绑 127.0.0.1 是"只对宿主机",容器里语义变了,这是容器化最高频的翻车点。
构建、运行、验收
docker build -t ledger:1.0 . # 构建镜像,打上名字与版本标签 docker run -d --name ledger \ -p 80:8000 \ --env-file .env \ ledger:1.0 # 后台运行:端口映射 + 环境注入 docker ps # 查看运行中的容器 docker logs ledger # 看日志 docker stop ledger && docker rm ledger # 停止并移除
-d 后台运行;-p 把宿主机 80 端口映射到容器 8000——外部访问 80,流量进容器;--env-file 把 6.2 的环境文件注入容器,配置分离的纪律在容器时代无缝延续。验收一条龙:浏览器访问服务器 80 端口,轻记账响应;docker logs 里看到 Gunicorn 的访问日志;删容器、重启容器,服务如初——环境不可漂移,因为环境已是一只只可抛弃的集装箱。
演练与变式
把镜像搬到"陌生机器"验证核心卖点:把镜像导出成文件(docker save),拷到另一台装了 Docker 的机器导入(docker load),一条 run 命令,服务立起——全程没有装 Python、没有装依赖。变式一:往代码里加一行注释,重新 build,观察构建输出里哪些层显示"已缓存"——亲眼确认分层缓存的威力。变式二:把数据库文件放进挂载卷(volume)再删容器重建,数据仍在——思考为什么不能把有状态数据留在容器可写层里(答:容器随时可弃,数据必须住在容器外)。
易错点清单
- 依赖安装不独立成层:缓存全废,每次重建全量下载
- 容器里存重要数据:容器删除即蒸发,有状态数据一律用卷挂载
- CMD 绑 127.0.0.1:容器外永远连不上,端口映射形同虚设
- 镜像里带 .env 与密钥:镜像可被任何人拉取检查,密钥运行时注入而非构建时打进去
多阶段构建:把镜像从九百兆压到九十兆
初学者的 Dockerfile 通常是"把整个开发环境塞进镜像",结果镜像动辄接近 1GB,推送慢、拉取慢、启动也慢。多阶段构建是标准解法:构建阶段负责编译,运行阶段只带走产物。
# ---------- 阶段一:构建 ---------- FROM python:3.11-slim AS builder WORKDIR /build # 先只复制依赖清单,充分利用构建缓存(改代码不会重装依赖) COPY requirements.txt . RUN pip install --no-cache-dir --prefix=/install -r requirements.txt # ---------- 阶段二:运行 ---------- FROM python:3.11-slim WORKDIR /app # 只把安装好的依赖从构建阶段拷过来,编译工具链被留在上一阶段 COPY --from=builder /install /usr/local COPY app/ ./app/ ENV PYTHONUNBUFFERED=1 # 用非 root 用户运行,缩小容器被攻破后的影响面 RUN useradd -m appuser && chown -R appuser:appuser /app USER appuser EXPOSE 8000 CMD ["gunicorn", "-w", "4", "-b", "0.0.0.0:8000", "app:create_app()"]
| 优化动作 | 典型效果 | 原理 |
|---|---|---|
| 多阶段构建 | 体积下降 60%~90% | 编译工具链不进最终镜像 |
| 基础镜像换 slim/alpine | 下降数百 MB | 去掉文档与调试工具 |
| 依赖清单先于代码复制 | 构建时间大幅缩短 | 改代码不触发依赖重装 |
| 加 .dockerignore | 体积与构建时间双降 | 虚拟环境、缓存、.git 不进构建上下文 |
| 合并 RUN 并清理缓存 | 减少层数与体积 | 镜像每层都会保留 |
.dockerignore 常被忽略却立竿见影,至少应包含这几项:.venv/、__pycache__/、.git/、.env、*.pyc、测试与文档目录。少了它,本地几百兆的虚拟环境会被整个送进构建上下文。
容器使用的三条纪律
容器里只跑一个进程。 一个容器既跑 Web 又跑定时任务,日志与生命周期都会纠缠。需要多个进程就用容器编排工具组合多个容器。
数据不放在容器里。 容器的文件系统随容器销毁而消失,数据库文件、上传的文件必须通过卷(volume)挂载到宿主机或外部存储。这条违反一次,就会以"重启后数据没了"的形式记住。
镜像要打版本标签,别只用 latest。 latest 会漂移,回滚时你无法确定要回到哪一个构建。语义化版本或 git 提交号作为标签,才能做到"哪个版本在线上一目了然"。
本节要点回顾
- 镜像是配方产物,容器是运行实例:分层只读、可共享、可缓存
- Dockerfile 七行起步:基础镜像、依赖层、代码层、启动命令
- 依赖层在前、代码层在后,缓存命中的重建以秒计
- 端口映射与 env 注入:同一镜像跑遍开发与生产
- 有状态数据住卷里,容器随时可弃
集装箱码好了,服务也稳了。用户一多、接口一慢怎么办?下一节缓存与异步,性能话题正式开场。