6.5 性能、缓存与异步
6.5 性能、缓存与异步
本节摘要:服务上线只是起点,用户一多,两件事必然发生:重复查询拖慢接口、耗时操作堵住请求。本节给出两味主药——把热点数据放进 Redis 缓存,把慢活计交给异步任务——再介绍应对超高并发的第三条路 asyncio 异步编程。性能优化的纪律是先测量再动手:不 profiling 就优化,是程序员的自我感动。
本节的能力清单
阅读完本节,你应当能够:
- 按流程做性能定位:测量、找瓶颈、优化、复测
- 判断什么数据值得缓存,用 Redis 完成读写与过期设置
- 解释缓存穿透与失效风暴,给出基础对策
- 用线程池把慢操作移出请求路径,理解异步任务的价值
- 说出 asyncio 的适用边界,避免把 CPU 密集任务写成伪异步
纪律先行:先测量,再优化
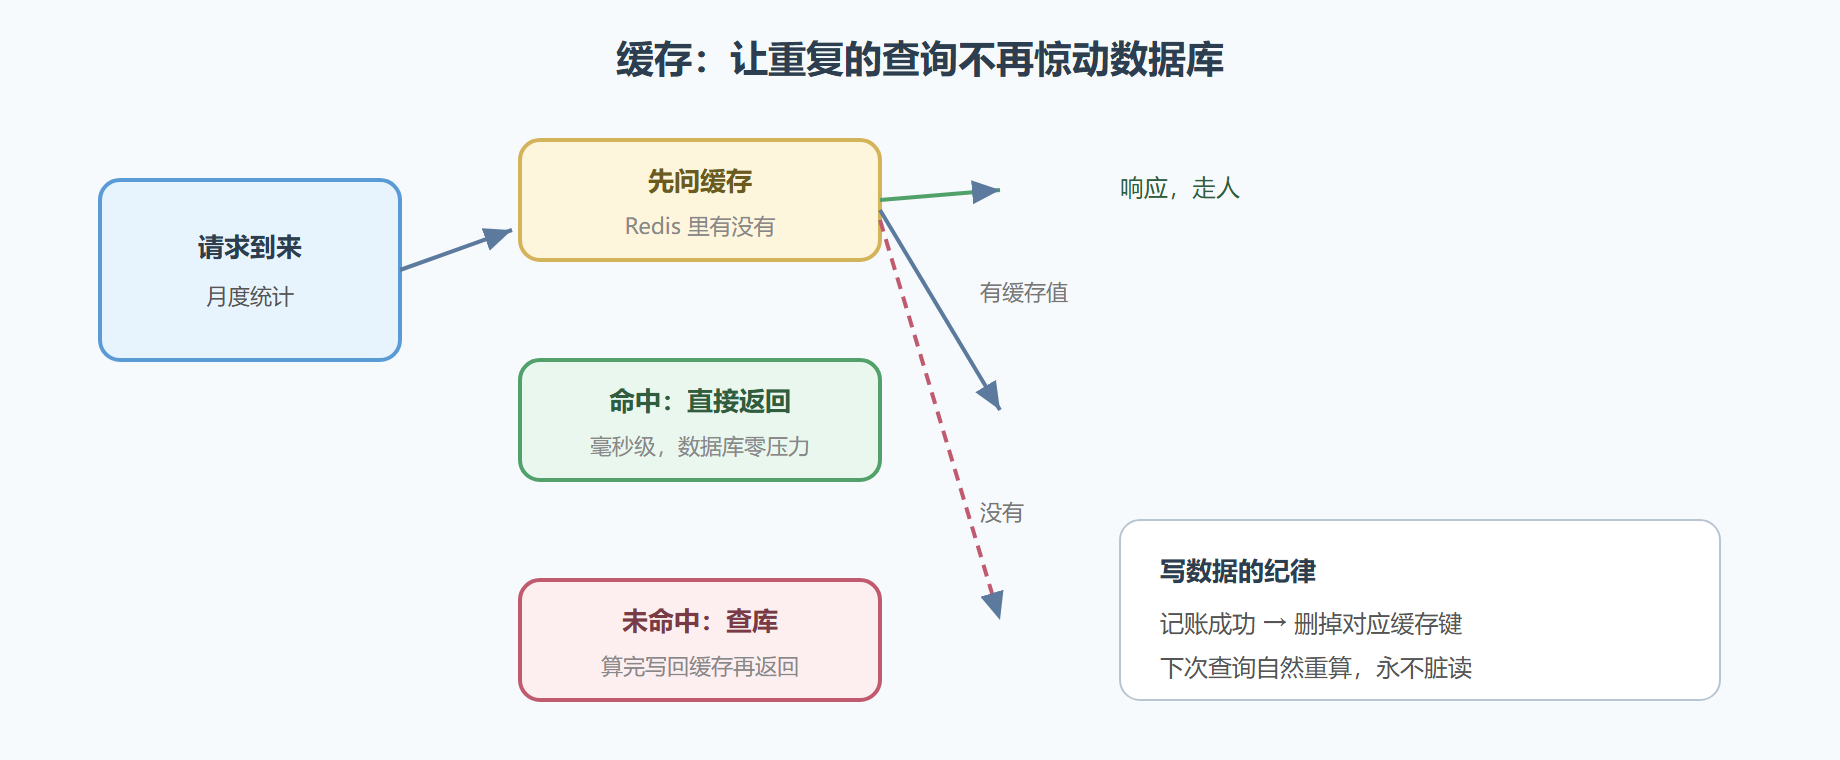
性能优化最大的坑是凭感觉动手。正确流程四拍:测量当前接口耗时(日志打点或压测工具);定位瓶颈——是数据库慢查询、还是 Python 计算、还是网络往返;优化短板一处;复测确认收益。轻记账的月度统计接口在账目上万条后明显变慢——测量发现每次请求都全表聚合,而这个"本月合计"一分钟内几乎不变。特征对上了:读多写少、结果可复用——教科书级的缓存场景。
图 6-5 加缓存前后的请求路径
Redis 缓存:键值对的闪电仓库
Redis 是内存键值数据库,读写都在内存,比关系库快几个数量级——5.1 说的"非关系型补缓存与高吞吐场景"在此兑现:
import json, redis r = redis.Redis(host="localhost", port=6379, decode_responses=True) def month_total_cached(user_id, month): key = f"total:{user_id}:{month}" cached = r.get(key) if cached is not None: # 命中 return float(cached) total = month_total_from_db(user_id, month) # 未命中,查库计算 r.set(key, total, ex=300) # 写回缓存,五分钟过期 return total def add_record(item, amount, user_id): # 写操作要"打脏"缓存 db_add_record(item, amount, user_id) r.delete(f"total:{user_id}:{date.today().strftime('%Y-%m')}")
三个设计决定。键带用户与月份:粒度精细,别人记账不影响你的缓存。过期时间兜底:即便忘了打脏,五分钟后缓存自然失效——过期是防脏读的保险丝。写操作删除对应键:用户记一笔,本月合计的缓存立即作废,下次查询重算。读改写之间永远存在一瞬间的旧值窗口,"写后删键"是把窗口压到最小的实用折衷,一致性要求极高的场景要换成更复杂的方案(先更新库再双删等),此处建立概念即可。
异步任务:慢活别在请求里干
导出全年账目报表要十几秒——用户点完按钮干等十秒白屏?把慢活从请求路径上摘下来:
from concurrent.futures import ThreadPoolExecutor pool = ThreadPoolExecutor(max_workers=4) @app.post("/api/export") def export(): task_id = new_task_id() pool.submit(export_job, current_user_id(), task_id) # 丢给后台线程 return jsonify({"task_id": task_id}), 202 # 立刻受理 @app.get("/api/export/status") def status(): return jsonify(check_task(current_task_id())) # 前端轮询进度
请求只做两件事:受理(返回 202 与任务号)和查进度。真正的工作在后台线程跑完,写文件、发通知。处理完立即返回,是接口响应速度的第一原则。生产规模下线程池换成任务队列(如 Celery 加 Redis),模型不变:提交、执行、查询三段式。
asyncio:另一把钥匙,别乱开
线程池是"开更多工人",asyncio 是"一个工人不停手":
import asyncio async def fetch_url(url): reader, writer = await asyncio.open_connection(url, 80) # await 处等待时,事件循环去服务其他任务——单线程并发上千连接 ...
它的高效来自不等:发起网络请求后不傻等回复,转身处理下一个任务,回复到了再回头。所以 asyncio 的甜区是 I/O 密集(大量网络调用、磁盘读写);CPU 密集任务(图片处理、大数据计算)它帮不上忙——计算时事件循环也被占死,"伪异步"反而添乱。另外整个调用链要全是异步写法,中途插一个同步阻塞调用就前功尽弃。本书项目并发量有限,用线程池足矣;asyncio 记住"什么时候该想到它",比现在就精通它更重要。
演练与变式
给月度统计接口装上缓存,用压测脚本对比:缓存前每秒处理请求数与缓存后差几倍(通常十倍起步)。变式一:把过期时间调成 300 秒与 3 秒各测一次命中率,体会"过期太短缓存形同虚设、太长脏读窗口拉大"的权衡。变式二:把报表导出改成异步三段式,前端加一个进度条轮询——用户体验的改善肉眼可见。
易错点清单
- 什么都缓存:缓存是负债——键管理、失效策略、内存成本全是账,只缓真热点
- 写库不打脏缓存:用户记了账,首页合计半天不变,疑难杂症排行榜常客
- 在请求线程里干慢活:一个导出拖死全部请求,慢活必摘出去
- 拿 asyncio 包治百病:CPU 密集用多进程,I/O 密集才轮到异步
本节要点回顾
- 先测量再优化:测量、定位、优化、复测,四拍循环
- 缓存三纪律:键粒度精细、过期兜底、写后删键
- Redis 是内存键值库,读多写少的数据才值得进缓存
- 慢操作三段式:受理 202、后台执行、轮询进度
- asyncio 管 I/O 密集,调用链全异步才有意义,CPU 密集请用多进程
性能有了预案,最后一课是底线:安全。下一节把全书散落的安全点收拢成一张上线自检清单。