4.1 API 技术栈选型:契约的施工队
4.1 API 技术栈选型:契约的施工队
本节摘要:技术栈是把契约翻译成可运行成品的"施工队"。选型没有统一的"最强答案",只有按场景的最优取舍:团队熟悉度、生态成熟度、性能与并发能力、治理与可运维性四把尺子。本节亮出主流语言框架的对比矩阵,并给出一个"内部 vs 对外、CPU 密集 vs IO 密集"的选型决策框架。
一个"换框架救火"的经典误判
有个团队接口频频超时,照社区惯例认定"是框架不够快",连夜把整套服务换成了当下跑分最高的语言重写。两个月后,吞吐确实上去了,人却走了一批——新框架冷门,招聘没人懂、文档稀疏、细节坑要靠翻源码填;原本熟悉的生态库也没法用,集成成本远超当初压测节省的那点时间。问题从来不是"哪个框架最能打",而是"在当前团队、当前业务、当前维护图景下,哪个最该用"。这一节就给选型配几把能量化的尺子。
学习目标
阅读完本节,你应当能够:
- 用四把尺子(熟悉度、生态、性能、治理)评估一个框架是否合适。
- 对照主流语言框架的取舍,并各说一个适合/不适合场景。
- 区分 CPU 密集与 IO 密集对选型的影响。
- 判断"追新框架" vs "守成熟栈"的权衡。
选型为什么没有标准答案
"哪门语言最适合做 REST API"在社区里能吵三天,就是因为选型没有标准答案。技术栈是施工队,施工队合不合适看的是:你们的人熟不熟这支队伍、这支队伍的建材(生态)够不够全、它能不能扛起你要的工期(并发与性能)、它好不好管(治理与运维)。
二、四把尺子先量后选
把选型落到可操作的维度,就是拿四把尺子量候选框架:
- 团队熟悉度:团队技术底色决定上手成本与长期维护难易。一个全 Java 团队让 Go 凭空组队,初始热情高,长期人效要打问号。
- 生态成熟度:认证、数据库、监控、测试的库是否齐全。生态越全,踩坑越少,集成越省力。
- 性能与并发:框架处理高并发的模型(多线程、事件驱动、协程)直接决定吞吐与延迟边界。
- 治理与可运维性:是否支持路由、校验、日志、监控、开放规范的完善工具链——这决定上线后好不好维护。
把主流框架的强项与合适场景收敛成一张"分工地图",选型时按坐标落位:
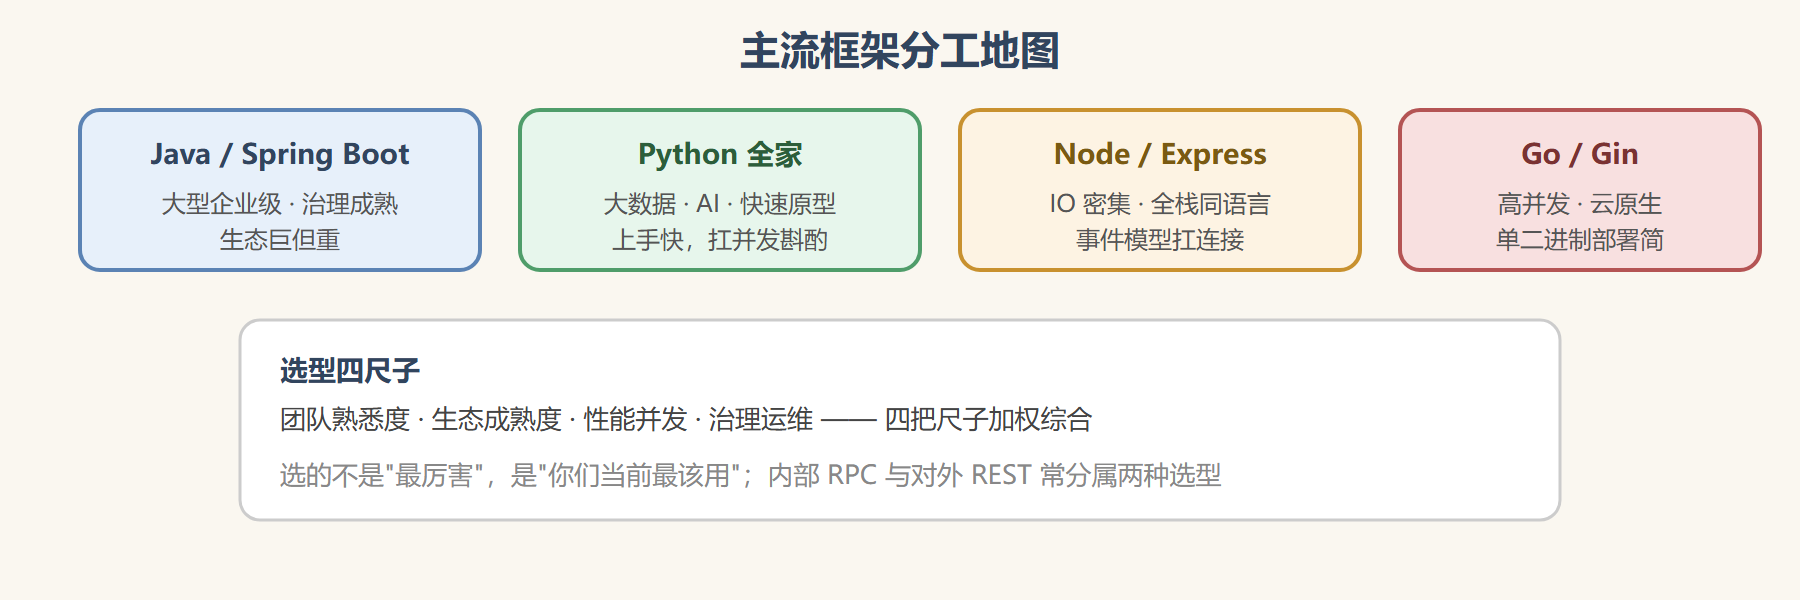
图:主流框架分工地图
三、一张主流对照矩阵
把几大主流拉上同一张表,取舍立现:
| 语言/框架 | 强项 | 相对弱势 | 适合场景 |
|---|---|---|---|
| Java / Spring Boot | 生态巨、治理成熟、企业级 | 重、上手门槛高 | 大型企业级、复杂治理 |
| Python / Django REST、FastAPI | 上手快、生态广、适合数据处理 | 高性能并发需斟酌 | 大数据、AI 服务、快速原型 |
| Node.js / Express、NestJS | IO 密集并发好、全栈同语言 | CPU 密集弱、回调心智复杂 | 前端团队、IO 密集服务 |
| Go / Gin、Echo | 高并发、单二进制、部署简单 | 起步查生态 | 高性能网关、云原生 |
| .NET / ASP.NET Core | 性能佳、工具链齐 | 生态偏向微软系 | 微软系企业 |
三个典型分流:
- CPU 密集(图像处理、加密、解析大量数据)优先带重计算优化或协程友好的语言(Go、C 系或 Node 的 worker);纯事件回调模型在 CPU 密集下容易吃亏。
- IO 密集(大量数据库与外部调用、托底型 Web 服务)恰恰是 Node、Go 等事件/协程模型的强项,单个 worker 能扛大量并发连接。
- 内部 RPC 与对外 REST:内部用高吞吐二进制协议(gRPC 一类),对外用成熟生态的 REST 框架,很多体系的真实形态。
别把"选框架"和"选语言"当作是同一件事。框架是施工队的作业方式,语言是工人会说的母语——你可能在一门语言里换掉框架(Java 里从 Spring 切到 Micronaut),但很少会因为框架换掉整门语言。选型要先定语言这层大头(它决定生态、招人、长期维护),再看框架在语言生态里是否主流、工具链是否完善。若一门语言里框架五花八门,优先挑那个"社区讨论最多、文档最全、缺编译器插件的坑已被踩掉"的主框架;小众框架再香,冷门 bug 往往要自己啃,别为了局部便利牺牲整条线的可维护性。
四、一场选型决策的回放
背景:团队要做一个对外的商品目录接口,读多写少,预估高并发,团队成员长期用 Node.js。
操作:用四尺子过一遍——熟悉度 Node 满分;生态上目录 + 缓存 + 监控库齐全;性能上 IO 密集吃 Node 事件模型红利;治理上 NestJS 提供路由校验与开放规范工具。
结果:选 Node + NestJS 落地,高并发读的缓存丢给 CDN + 框架层,超出预期地稳。
解读:如果同样的需求放在一个 Java 团队身上,答案会切向 Spring Boot——同样读多写少,但熟悉度尺子优先。选的不是一个"最厉害的框架",而是"你们当前最该用的框架"。
变式:若改成一个内部消息聚合、CPU 密集的转码服务,同样的 Node 团队也应该分出一个 Go 专队去扛,而不是硬用 Node 顶。
⚠️ 常见坑:只比"性能压测跑分"就换框架,忽视团队熟悉度与生态,结果线上能跑但没人会维护。四把尺子要加权综合,权重取决于你这支队伍和业务形态。
💡 关键直觉:选型是"当前人力 × 业务形态 × 长期维护成本"的函数,不是"技术先进度"的函数。拿四把尺子量,答案会收敛到你们的现实,而不是网上的排行榜。
最后补一句关于"守旧"的声音:成熟栈往往是被选率最高的那批——文档全、坑踩完、招人容易、出问题有据可查。一个新框架再香,踩到冷门 bug 时你大概率得自己翻源码。选型的现实铁律是:新技术要能带来"业务上看得见"的收益才值得冒险,否则让它待在实验项目里养着,别拿核心契约押注。这把尺子,比任何跑分都有长期说服力。
本节要点回顾
- 要点一:选型用四把尺子:熟悉度、生态、性能并发、治理运维。
- 要点二:CPU 密集与 IO 密集对语言选择影响分开。
- 要点三:Java 重治理、Python 快上手、Node 扛 IO 并发、Go 高并发简洁。
- 要点四:内部 RPC 与对外 REST 常分属不同技术选型。
- 要点五:不追"最能打",只选"当前最该用",四尺子加权综合。
- 要点六:选型结论是后续序列化、文档、网关工作的前提。
施工队定了,下一步定"话说成什么口音"——序列化格式,这是契约交换的共同语言。