2.1 关系模型基础
2.1 关系模型基础
本节摘要:关系模型是关系型数据库的理论基础,由 E.F. Codd 在 1970 年提出。它把数据组织成"关系"(表),用数学上的集合论支撑。本节讲清它的核心思想和几个关键术语。
阅读收获
阅读完本节,你应当能够:
- 说清关系模型的由来和核心思想
- 对应"关系/元组/属性"和"表/行/列"的术语
- 理解关系模型为什么用"表"组织数据
- 区分关系模型和层次/网状模型
概念脉络
一、关系模型的由来
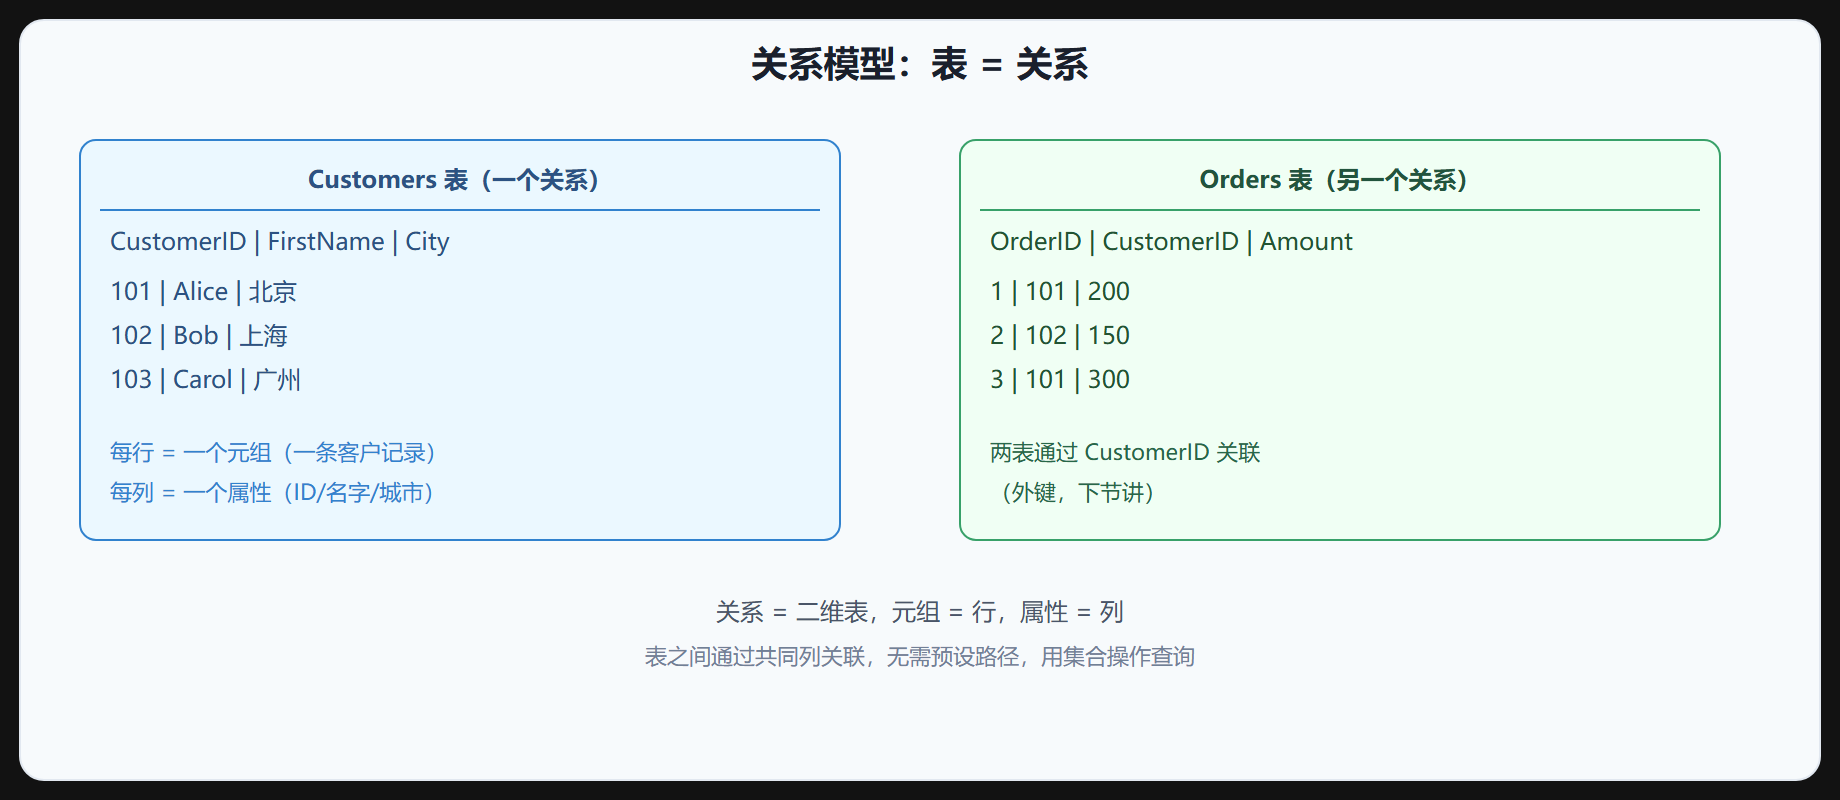
在关系模型之前,数据库主要是层次模型(树状)和网状模型(图状),查询要按预设路径走,复杂且不灵活。1970 年 IBM 的 Codd 提出关系模型:把数据组织成简单的二维表,表之间通过共同的列关联,查询不需要预设路径,用数学集合操作就行。
这个想法现在看理所当然,在当时是革命——它让数据库从"程序员按指针遍历"变成"用声明式语言描述集合"。SQL 就是基于关系模型设计的。
图 2-1 关系模型示意
二、关键术语对应
关系模型有一套数学术语,日常用一套实用术语,对应关系:
| 数学术语 | 实用术语 | 含义 |
|---|---|---|
| 关系(Relation) | 表(Table) | 二维数据结构 |
| 元组(Tuple) | 行/记录(Row/Record) | 表里一行数据 |
| 属性(Attribute) | 列/字段(Column/Field) | 表里一列 |
| 域(Domain) | 取值范围 | 某列允许的值 |
日常说"表/行/列"就行,但看到文档说"关系/元组/属性"要知道是同一回事。
三、关系模型的几个性质
关系模型有几个基本性质,理解了能解释很多 SQL 行为:
- 行的无序性:表里的行没有固定顺序,
SELECT不加ORDER BY返回顺序不保证。要顺序必须显式排序。 - 列的无序性:列也没有固定顺序,按列名引用而非位置(虽然
SELECT *按定义顺序显示)。 - 原子性:每个单元格的值是原子的(不可再分)。第一范式的要求。
- 唯一性:理论上关系里不能有完全相同的两行,实际 DBMS 允许(除非加主键约束)。
💡 关键直觉:关系模型把数据看成"无序的集合",所以 SQL 查询结果不加
ORDER BY顺序不定。想稳定顺序必须显式排,别依赖"插入顺序"。
四、和层次/网状模型的区别
| 模型 | 数据组织 | 查询方式 | 灵活性 |
|---|---|---|---|
| 层次 | 树状 | 按路径遍历 | 低 |
| 网状 | 图状 | 按指针 | 中 |
| 关系 | 二维表 | 集合操作 | 高 |
关系模型赢在"简单 + 灵活 + 有数学基础",所以成了主流。NoSQL 某种程度是层次/网状模型的回归,但在新场景(超大规模、灵活结构)有优势。
本节速览
- 由来:Codd 1970 年提出,把数据组织成二维表,用集合操作查询,取代了层次/网状模型。
- 术语对应:关系=表、元组=行、属性=列、域=取值范围。
- 性质:行无序、列无序、原子性、唯一性——解释了 SQL 很多行为。
- 优势:简单 + 灵活 + 数学基础,是主流的原因。
- 查询结果不加
ORDER BY顺序不定,想稳定顺序必须显式排。
下一节讲表的具体结构:列、行、数据类型怎么选。
关系模型如何指导 SQL 写法
关系模型的"行无序、列无序"这两条性质,直接决定了 SQL 的写法习惯。看一个例子:
-- 关系模型的集合论视角:SELECT 是对"关系"做运算 -- 不保证顺序,除非显式 ORDER BY SELECT City, COUNT(*) FROM Customers GROUP BY City; -- 关系模型要求单元格原子(不可再分) -- 所以别在单元格里存 "北京,上海" 这种逗号分隔列表 SELECT * FROM Customers WHERE City = '北京';
设计含义:正因为关系模型强调原子性和无序性,我们建表时要把每个属性拆开、一列一值;查询结果如果依赖顺序,必须显式排序。理解这些"为什么",后面写 SQL 遇到"为什么结果顺序不稳""为什么不能存列表"这类疑问时,就能回到模型层面找到答案。
常见疑问
Q1:关系模型是数学概念,不学集合论能学懂吗?
能。本书只需要你理解"集合"这个直觉:一组元素的全体,无序、不重复。关系就是"由行组成的集合"。SQL 的很多运算(UNION、JOIN)本质上就是集合运算。数学细节不是门槛,直觉才是关键。
Q2:为什么现在的数据库还遵循 1970 年的模型?
因为关系模型同时满足了三个需求:数据结构简单(二维表)、查询方式灵活(集合运算)、有坚实的数学基础。后来出现的关系扩展(对象关系、JSON 类型)都是在这个框架上加能力,核心思想没变。
Q3:日常说"关系"和数据库里的"关系"一样吗?
不一样。日常说"这两张表有关系"指业务关联;数据库术语里,"关系"特指一张表(数学概念)。文档里出现"关系"时,多数时候把它替换成"表"就对了。术语混乱正是初学者常困惑的点,把映射表记牢即可。