4.1 聚合函数与 GROUP BY 分组
4.1 聚合函数与 GROUP BY 分组
本节摘要:聚合函数把多行算成一个值(COUNT/SUM/AVG/MIN/MAX),GROUP BY 把行分组后分别聚合,HAVING 过滤分组。本节讲清三者的配合。
本节目标
阅读完本节,你应当能够:
- 用五个常用聚合函数
- 用 GROUP BY 分组统计
- 区分 WHERE 和 HAVING
- 避免聚合查询的常见错误
一、五个聚合函数
聚合函数对一组值计算返回单个值:
| 函数 | 作用 | 示例 |
|---|---|---|
| COUNT() | 计数 | COUNT(*) 总行数 |
| SUM() | 求和 | SUM(Amount) 总金额 |
| AVG() | 平均 | AVG(Amount) 平均金额 |
| MIN() | 最小 | MIN(Amount) 最小金额 |
| MAX() | 最大 | MAX(Amount) 最大金额 |
SELECT COUNT(*) FROM Customers; -- 客户总数 SELECT SUM(Amount) FROM Orders; -- 订单总金额 SELECT AVG(Amount) FROM Orders; -- 平均订单金额
注意 COUNT(*) 数所有行(含 NULL),COUNT(列) 数该列非 NULL 的行。
二、GROUP BY 分组
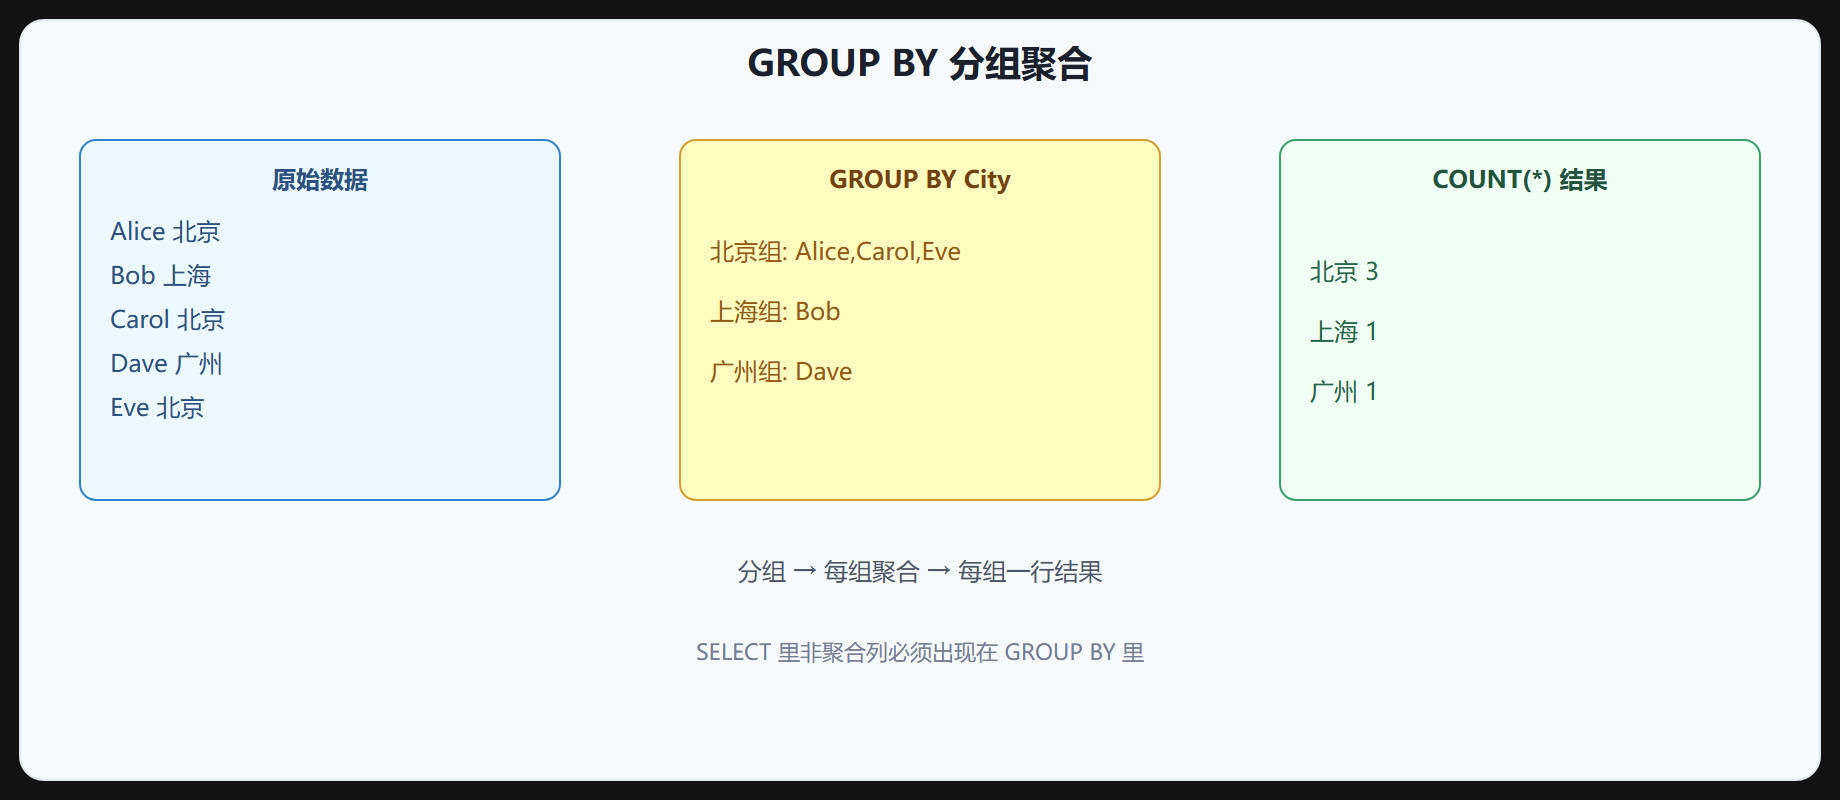
GROUP BY 把行按某列分组,聚合函数对每组分别计算:
SELECT City, COUNT(*) AS 客户数 FROM Customers GROUP BY City;
返回每个城市的客户数。GROUP BY 的列会出现在 SELECT 里(非聚合列必须在 GROUP BY 里,否则报错)。
图 4-1 分组聚合流程
多列分组:GROUP BY City, Gender 会按城市+性别组合分组。
三、HAVING 过滤分组
WHERE 在分组前过滤行,HAVING 在分组后过滤组:
SELECT City, COUNT(*) AS 客户数 FROM Customers GROUP BY City HAVING COUNT(*) > 5; -- 只要客户数大于 5 的城市
| 子句 | 时机 | 能用聚合? |
|---|---|---|
| WHERE | 分组前 | 不能 |
| HAVING | 分组后 | 能 |
四、常见错误
- SELECT 非聚合列不在 GROUP BY:
SELECT City, FirstName ... GROUP BY City报错——FirstName 在组里有多个值,不知道选哪个。 - WHERE 里用聚合:
WHERE COUNT(*) > 5报错——WHERE 时还没分组,改 HAVING。 - HAVING 用非聚合且非分组列:逻辑混乱,避免。
⚠️ 常见坑:
SELECT City, FirstName FROM Customers GROUP BY City——FirstName 怎么取?严格 DBMS 报错,宽松的(MySQL 老版)随便取一个,结果不可预期。非聚合列一定要在 GROUP BY 里。
💡 关键直觉:聚合函数把多行压成一行,GROUP BY 决定按什么分,HAVING 过滤分组后的结果。记住 SELECT 非聚合列必须在 GROUP BY 里。
重点提炼
- 五个聚合:COUNT/SUM/AVG/MIN/MAX,COUNT(*) 数全行、COUNT(列) 数非 NULL。
- GROUP BY:按列分组,聚合函数对每组算,SELECT 非聚合列必须在 GROUP BY 里。
- HAVING:分组后过滤组,能用聚合;WHERE 分组前过滤行,不能用聚合。
- 常见错:非聚合列不在 GROUP BY、WHERE 用聚合、HAVING 用非分组非聚合列。
- 分组聚合是统计查询的核心,掌握后能写大多数报表查询。
下一节讲 JOIN——把多张表连起来查。
常见疑问
Q1:COUNT(*) 和 COUNT(列) 有什么区别?
COUNT() 统计行数(包含 NULL 行);COUNT(列) 只统计该列非 NULL 的个数。比如统计"有邮箱的客户数"用 COUNT(Email),统计总客户数用 COUNT()。用错会导致数字对不上,是数据报表常见的低级错误。
Q2:GROUP BY 后 SELECT 里能写哪些列?
只能写:1) 分组列;2) 聚合函数(COUNT/SUM/AVG/MIN/MAX)。其他非分组、非聚合列在标准 SQL 里不允许(会报错)。MySQL 老版本宽松模式不报错但取的值是随机的——这是隐患,务必只写分组列和聚合结果。
Q3:WHERE 和 HAVING 到底怎么分工?
WHERE 在分组前过滤行(先剔除不要的行再分组),HAVING 在分组后过滤组(对统计结果再筛一遍)。举例:WHERE Amount > 0 GROUP BY City HAVING COUNT(*) > 5 表示只看金额为正的订单,再只要客户数超过 5 的城市。顺序理解错,结果就差很多。
Q4:能不能对聚合结果排序?
能。ORDER BY 可以用聚合结果:SELECT City, COUNT(*) AS c FROM Customers GROUP BY City ORDER BY c DESC 按客户数从多到少排。注意排序用的别名要在 SELECT 里定义过。
Q5:只聚合不分组(整个表一行结果)怎么写?
不加 GROUP BY 直接 SELECT COUNT(*), SUM(Amount) FROM Orders,整表作为一个组,返回一行。这是"总计"类报表的写法。
动手做一做
聚合分组是数据分析的核心,一定要动手跑几遍。
准备一张练习表,包含城市、性别、金额、日期几个字段,插入几十条数据。
第一个练习:分别用计数、求和、平均、最大、最小这几个聚合函数算全表统计,再看计数全部行和计数某列的结果差在哪,体会空值对计数的影响。
第二个练习:按城市分组,统计每个城市的记录数和金额合计,再尝试按城市加性别两列分组,观察分组粒度变细之后,结果行数如何变化。
第三个练习:先过滤再分组,与先分组再过滤,两种写法对比。你会发现,一个用过滤子句在分组前筛行,一个用分组过滤子句在分组后筛组,作用阶段完全不同。
第四个练习:按城市分组并排序,观察聚合结果能否排序、怎么排。
这四个练习做完,你对"聚合把多行压成一行""分组决定压成几行""过滤分组用专门子句"这几个核心概念,会有实实在在的理解。报表、统计类需求大量用到这些技能,值得反复练。
一句话记忆
聚合函数负责"把多行算成一个值",分组子句负责"按什么把行归堆",分组后的过滤则要交给专门的子句。记住"选择列表里的普通列必须来自分组列",就能避开最常见的报错。