7.2 索引 INDEX
7.2 索引 INDEX
本节摘要:索引是加速查询的额外数据结构。本节讲索引的作用、常见类型、创建使用,以及索引的代价和"建了不走"的坑。
先说结论
阅读完本节,你应当能够:
- 说清索引为什么能加速
- 区分主键索引、唯一索引、普通索引、复合索引
- 创建和使用索引
- 理解索引的代价和失效场景
概念脉络
一、为什么需要索引
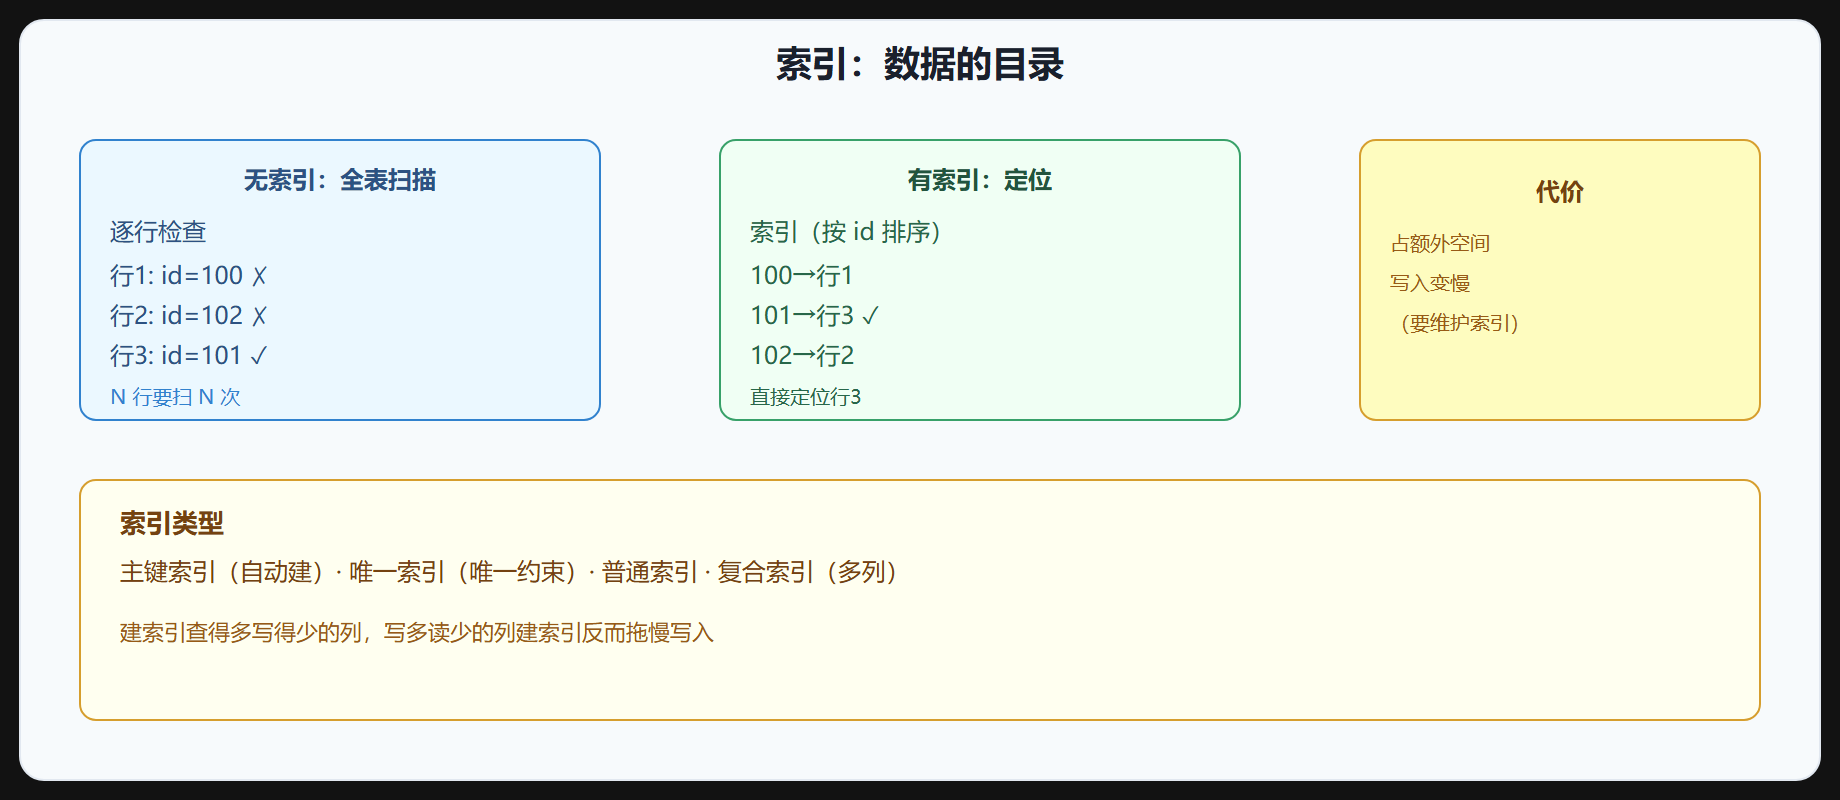
没有索引时,查询要全表扫描——逐行检查条件,表大就很慢。索引类似书的目录,按某列排序存储,查询时先查索引定位到行,再取数据,快很多。
比如 WHERE CustomerID = 101,没索引要扫全表;有索引直接定位到那一行。
图 7-2 索引结构
二、索引类型
| 类型 | 特点 | 创建 |
|---|---|---|
| 主键索引 | 自动建,唯一+非空 | 建主键时自动 |
| 唯一索引 | 保证唯一 | 建唯一约束时自动,或手动 |
| 普通索引 | 加速查询,不保证唯一 | 手动建 |
| 复合索引 | 多列组合索引 | 手动建,列顺序重要 |
三、创建索引
-- 单列普通索引 CREATE INDEX idx_city ON Customers(City); -- 唯一索引 CREATE UNIQUE INDEX idx_email ON Customers(Email); -- 复合索引(多列) CREATE INDEX idx_city_name ON Customers(City, FirstName); -- 删除 DROP INDEX idx_city ON Customers;
主键和唯一约束会自动建索引,不用手动。
四、复合索引的列顺序
复合索引 (A, B) 对 WHERE A=x、WHERE A=x AND B=y 生效,但对 WHERE B=y 不生效(要命中前缀)。所以复合索引的列顺序按"查询最常过滤的列"排,最常过滤的排前面。
| 查询 | 索引 (A,B) 是否生效 |
|---|---|
| WHERE A=x | 生效 |
| WHERE A=x AND B=y | 生效 |
| WHERE B=y | 不生效 |
五、索引的代价
索引不是越多越好:
- 占空间:每个索引一份额外数据结构。
- 拖慢写入:INSERT/UPDATE/DELETE 要同步维护索引,索引多写入慢。
- 优化器选择:索引多了优化器选错索引可能反而慢。
建索引的准则:查得多写得少的列建索引,写多查少的列建索引反而拖慢写入。
六、索引失效的常见场景
建了索引查询却没用上,常见原因:
- 函数包裹列:
WHERE UPPER(City)='BJ'不走 idx_city。 - 类型不匹配:
WHERE id='1'(id 是 INT)隐式转换可能不走索引。 - LIKE 前通配:
WHERE name LIKE '%abc'不走索引('abc%'走)。 - OR 条件:
WHERE A=x OR B=y,若只有 A 有索引,可能全表扫。 - 数据分布:某列值太集中(如性别只有男女),索引选择性差,优化器可能不走。
⚠️ 常见坑:建了一堆索引查询还是慢——可能索引没走。用
EXPLAIN看执行计划,确认是否用了索引。盲目堆索引还会拖慢写入。
💡 关键直觉:索引是"用空间换时间 + 写入换查询速度"。查多写少的列建索引,复合索引列顺序按过滤频率排,用 EXPLAIN 确认索引生效。
核心回顾
- 作用:类似书的目录,避免全表扫描,加速查询。
- 类型:主键索引(自动)、唯一索引、普通索引、复合索引。
- 创建:CREATE INDEX,主键/唯一约束自动建。
- 复合索引:列顺序按过滤频率排,命中前缀才生效。
- 代价:占空间、拖慢写入、优化器可能选错。查多写少的列才建。
- 失效场景:函数包裹列、类型不匹配、LIKE 前通配、OR、选择性差。用 EXPLAIN 确认。
下一节讲事务——把多个操作打包成原子单元。
常见疑问
Q1:为什么索引能加速查询?
索引是类似书目录的"有序结构"(B+树)。没有索引时查询要逐行扫描(全表扫);有索引时,先按条件在索引树里二分定位,再回表取数据,把 O(n) 降到 O(log n)。代价是:1) 占用额外存储;2) 插入/更新要同步维护索引,写入变慢。
Q2:哪些列适合建索引?
判据是"查得少、写得多的列不建,查得多、写得少的列建"。具体:WHERE/JOIN/ORDER BY 频繁出现的列、区分度高的列(值种类多)适合;性别这类值太集中、或者几乎不查询的列不建。别为"所有列"建索引,那是灾难。
Q3:怎么判断查询有没有走索引?
用 EXPLAIN:EXPLAIN SELECT ...,看 type 列(ALL=全表扫,index/range/ref=走索引)和 key 列。学会看执行计划是性能调优的基本功。面试常问,务必会用。
Q4:复合索引列顺序怎么定?
"最左前缀原则":(A,B) 索引能服务 A、A+B 的查询,但单独查 B 用不上。所以把区分度高、查询最频繁的列放最左。建复合索引前,先分析你主要的查询模式。
Q5:索引会失效的常见原因?
- 对索引列做函数运算(WHERE UPPER(city)='BJ');2) 隐式类型转换(WHERE id='1' 且 id 是数字);3) LIKE 前导通配符('%xxx');4) OR 条件有非索引列;5) 数据分布让优化器觉得全表扫更快。排查时优先看 EXPLAIN。
Q6:主键和外键会自动建索引吗?
主键自动建唯一索引;外键在 MySQL InnoDB 下会自动建索引(其他数据库不一定,要手动建)。JOIN 的性能几乎完全依赖关联列索引,所以建表时把外键索引想清楚。