第1章 框架对照入门
第 1 章 · 框架对照入门
章节摘要:本章解决「为什么学的是 TensorFlow 和 PyTorch,而不是别的库」以及「动手前环境怎么对齐」。先把人工智能、机器学习、深度学习三层关系钉死,再把两套框架放在同一张选型表上:研究迭代、生产部署、可视化、动态图各占哪一格。读完你应当能向别人讲清选型理由,并在本机或笔记本环境里同时验证两套安装,而不是先装一套再把另一套拖到「以后再说」。
阅读收获
阅读完本章,你应当能够:
- 用自己的例子区分人工智能、机器学习、深度学习三层,并指出本教程落在哪一层
- 对照说出 TensorFlow 与 PyTorch 各自的历史定位:工业部署传统优势 vs 研究侧动态图传统优势
- 列出张量计算、自动微分、数据加载、优化器这四块两边都提供的能力,避免把「功能有无」当成选型依据
- 为 CPU 入门环境写出原文给出的安装命令思路,并知道 GPU 必须按官方 CUDA 对照表对齐
- 判断 Jupyter 与 Colab 各自适合对照实验的哪一段
核心概念速览
金句:选型不是选信仰,是选你此刻更缺的那一侧——要快速看到
fit的曲线,还是要看清每一步梯度从哪来。
图 本章三件事
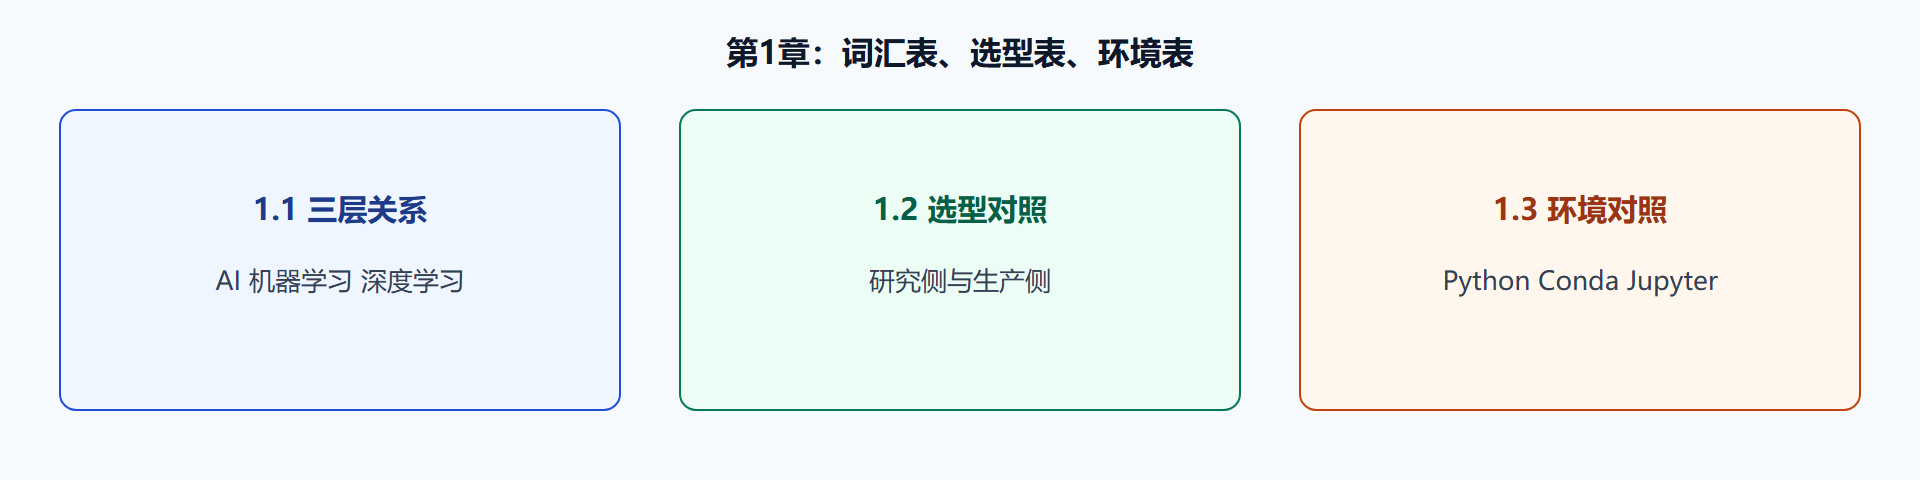
子章节导航
1.1 从人工智能到深度学习
把三个常被混用的词拆开,说明本教程的「第一个 AI 模型」实际是一个有监督的深度分类器,而不是通用智能体。
1.2 TensorFlow 与 PyTorch 选型对照
按市场地位、功能重叠、独特优势、社区与融合趋势四块对照。Google Brain 与 Meta 研究团队的背景只作为来源说明,不替代技术判断。
1.3 开发环境对照
Python 版本下限、Conda 与 Pip、Jupyter 与 Colab、CPU 安装命令与 GPU 对齐原则。安装验证用一个最小张量加法,而不是一上来就训练。
本章怎么对照着读
把 1.2 的表打印或抄下来,当作后文的封面。表上「重叠的能力」读过就划掉,不要在第 2 章再问「PyTorch 有没有优化器」。留下的分叉——fit 对五步、SavedModel 对 state_dict、Tape 对 autograd——就是你真正要学的词汇。1.3 的三道验收门是体力活,建议当天做完:过门之前不要下载 Fashion MNIST,以免把网络问题当成框架损坏。若你只在 Colab 里学习,仍要把「会话结束环境消失」写在笔记第一行,避免第二天找不到昨天的核。
和第 2 章的交接物只有三样:能 import 的两套库、一张「主环境是哪套」的决定、以及「GPU 到底有没有被框架看见」的打印结果。交接物不齐,张量节的 .to(device) 会变成玄学。
子章节之间的逻辑关系
先统一语言,再谈选择,最后才碰安装。跳过 1.1 的人会把「深度学习框架」说成「人工智能框架」;跳过 1.2 直接装的人,后面对照时会缺少「为什么 API 长这样」的上下文。
| 节 | 交付物 | 不读会缺什么 |
|---|---|---|
| 1.1 | 词汇表与验收句 | 把分类器说成通用智能 |
| 1.2 | 选型表 | 用过期口号站队 |
| 1.3 | 环境三道门 | 半残安装进入张量练习 |
1.1 词汇表 ──► 1.2 选型表 ──► 1.3 环境表 │ └► 第2章起的五条对照轴
前置知识与后续延伸
- 前置知识:会写 Python 函数与循环,知道 NumPy 数组大概是什么;不要求微积分熟练,但要接受「损失对参数求导」这件事存在
- 后续延伸:本章为第 2 章的张量与自动求导对照铺环境;Fashion MNIST 的具体加载留到第 3 章和第 5 章,避免在安装节提前引入数据管线细节
本章还有一层「防跳章」的作用。有人已经会 Keras 的 fit,想直接翻到第 4 章对照 PyTorch 循环,这可以,但至少要把 1.2 的选型表读完:否则你会把「循环写得多」理解成 PyTorch 落后,而不是理解成封装切口不同。另一些人只想装环境,觉得 1.1 的三层关系像废话。请至少记住验收句:本教程的模型是有监督深度分类器,不是通用智能体。后面所有「第一个 AI 模型」都指这句话,避免预期膨胀。
环境节会提到 Jupyter 与 Colab,不是因为它们是深度学习的一部分,而是因为对照实验需要一个能左右切换内核的地方。Colab 借 GPU 很香,但会话结束环境消失,不适合当唯一的长期笔记本。本地环境过了三道验收门(导入、加法、设备列表),第 2 章的张量练习才不会和「其实没装上 GPU 版」搅在一起。
读完本章,你应当能用两分钟向同事讲清:为什么同时学两套、此刻主环境选哪套、验证安装的三条标准是什么。讲不清这三句,后面的 API 对照会变成单词表。讲得清,第 2 章开始的五条轴才有主心骨。
1.1 到 1.3 的阅读时间不必平均。已经清楚三层包含关系的人,1.1 可以当复习,但仍要读验收句和划分纪律——这两句后面会反复引用。1.2 建议精读,把「重叠能力」和「分叉优势」分成两列,后文遇到 API 就往其中一列归档,避免把所有差异都当成能力有无。1.3 是动手,卡住就停在验收门,不要带着半残环境进入张量练习。三节的产出分别是词汇表、选型表、环境表,缺一张表,缺的不是「背景知识」,而是后面对照时用来做判断的那张纸。
把三张表当作本章的交付物,而不是「读过就算」。词汇表防止你把分类器说成通用智能;选型表防止你用过期口号站队;环境表防止你带着半残安装进入张量练习。三张表齐了,第 2 章的五条对照轴才有落点。缺任何一张,后文都会把失败归因到错误的层次上。