2.1 张量操作对照
2.1 张量操作对照
本节摘要:张量是深度学习里的多维数组:标量秩 0、向量秩 1、矩阵秩 2,图像批次常常是秩 4。TensorFlow 与 PyTorch 都用张量承载输入、权重和梯度,都能上 GPU,都与 NumPy 可互转。对照重点不在「会不会创建全零张量」,而在属性名字、可变与不可变、设备迁移写法,以及广播规则踩坑。Fashion MNIST 一张图是 28×28,一批 64 张灰度图在 Keras 里常是
(64, 28, 28),在 PyTorch 里常是(64, 1, 28, 28)——通道维放哪,是后面卷积对照的第一分歧。
先说结论
阅读完本节,你应当能够:
- 说出形状、dtype、设备三个属性在两侧如何读取
- 对照创建常量 / 变量(或叶子张量)、全零全一、随机、从 NumPy 转换
- 完成切片、reshape、轴上求和、矩阵乘,并指出广播与真正矩阵乘的区别
- 解释为何深度学习常用 float32,以及通道维 NHWC 与 NCHW 的差异
为什么不用 Python 列表交差
列表套列表能表示矩阵,但没有统一的 dtype,也没有设备概念,更不会帮你录梯度。NumPy 解决了连续内存与向量化,仍默认停在 CPU,也不会自动反向传播。框架张量补上两块:同一套运算可在 GPU / TPU 上跑;运算过程可被自动微分系统记录。原文把这两点写成张量相对传统数组的核心理由,后面所有层都建立在这上面。
秩(维度个数)与形状(每一维多长)要分开说。一张 28×28 灰度图,形状 (28, 28),秩为 2;加上批次 64,Keras 常用 (64, 28, 28);PyTorch 视觉惯例再插通道维,变成 (64, 1, 28, 28)。同一批像素,形状元组不同,卷积层的默认假设就不同。对照实验里第一次 Conv2D 对 nn.Conv2d 报错,十次里有七次是通道维位置,不是算法错了。
属性读取几乎同名:.shape、.dtype、.device。差别在细节。TensorFlow 的形状有时是动态的,图模式下列表里会出现 None;PyTorch 即时形状通常是确定的 torch.Size。dtype 名称两边都能看到 float32,但构造时 TF 常用 tf.float32,PT 常用 torch.float32。设备字符串格式不同:一边是 /device:GPU:0 这类,一边是 cuda:0。打印出来不要当同一套解析。
💡 关键直觉:先把「这张量在哪块内存、什么类型、每一维是什么语义」写在纸上,再写运算。语义没对齐时,两边的
reshape都能跑通,然后默默把像素排错。
创建与运算:同一意图,两套拼写
原文在 2.1 与 3.1、4.1 里反复出现同一组创建动作:从 Python 列表、从 NumPy、全零、全一、均匀随机、正态随机、range 式序列。对照时不要追求把每一个函数名背下来,要追求「我要一个不可训练的常量」和「我要一个会被优化器改的参数」分得清。
TensorFlow 里 tf.constant 接近不可变;tf.Variable 才是训练中会变的权重容器。PyTorch 里普通 torch.tensor 默认 requires_grad=False;需要被优化的参数通常是 nn.Parameter,或在张量上打开 requires_grad。Keras 的 Dense 会替你建 Variable;nn.Linear 会替你建 Parameter。入门时很少手写 Variable,但一旦你要自定义一个可学习标量,两边的分叉就会出现。
# 概念对照:从列表创建,再读属性 import tensorflow as tf import torch tf_x = tf.constant([[1.0, 2.0], [3.0, 4.0]]) pt_x = torch.tensor([[1.0, 2.0], [3.0, 4.0]]) print(tf_x.shape, tf_x.dtype) print(pt_x.shape, pt_x.dtype, pt_x.device)
逐元素加减乘除,两边都支持运算符,也支持函数名。矩阵乘在 TF 里是 tf.matmul 或 @,在 PT 里是 torch.matmul、@ 或二维上的 .mm。广播:矩阵加标量、矩阵加向量,两侧都做,规则接近 NumPy。原文 3.1 用 2×2 矩阵加长度为 2 的向量演示行上广播——这是 SOURCE 里的具体例子,对照时建议两边各跑一遍,确认结果布局一致。
| 意图 | TensorFlow | PyTorch | 备注 |
|---|---|---|---|
| 全零 | tf.zeros(shape) |
torch.zeros(size) |
参数名 shape 对 size |
| 序列 | tf.range |
torch.arange |
终点是否包含要核对 |
| 重塑 | tf.reshape |
tensor.view 或 reshape |
view 要求内存连续 |
| 增加长度为 1 的维 | tf.expand_dims |
unsqueeze |
轴号从 0 计 |
| 去掉长度为 1 的维 | tf.squeeze |
squeeze |
指定轴时若长度不是 1 会报错 |
| 沿轴求和 | tf.reduce_sum |
torch.sum |
TF 带 reduce 前缀的习惯 |
| 设备迁移 | tf.device 上下文 |
.to(device) 或 .cuda() |
PT 更常链式调用 |
切片语法都像 NumPy:x[0]、x[0:2, :]。TF 另有 tf.gather 按索引收行;PT 用高级索引往往更直接。连续内存假设不同:PyTorch 的 view 在转置后可能失败,需要 contiguous();TensorFlow 的 reshape 通常帮你处理,但语义仍是「按当前内存序重排」,不是按轴名字重排。图像要从「高宽」换成「宽高」应使用转置类 API,而不是盲目 reshape。
与 NumPy 互转是调试的逃生口。TF 张量在即时执行下常可 .numpy();PT 用 .detach().cpu().numpy() 更安全——没 detach 时,带梯度的张量转 NumPy 会抗议。反向路径:tf.convert_to_tensor 与 torch.from_numpy。from_numpy 可能共享内存,改 NumPy 会改到张量,这是 SOURCE 互操作节里值得单独记住的行为。
随机张量用于初始化或造假数据。原文出现均匀 0 到 1 与标准正态。对照实验请固定种子,否则你会把「两次运行准确率不同」怪到框架头上。种子 API 两侧不同,记在实验笔记里,不要假设全局一次 random.seed 能管到 GPU 卷积。
设备、通道维、以及对照时的形状契约
GPU 迁移是张量作为「框架对象」而不是「NumPy 对象」的日常证据。原文写法:TF 用 tf.device 上下文把创建与运算包进去;PT 先 torch.device("cuda:0" if torch.cuda.is_available() else "cpu"),再 .to(device)。模型和数据必须在同一设备,否则运行时报设备不匹配。Keras 的 fit 会在内部处理很多设备细节;PyTorch 手写循环里,每一批 inputs 和 labels 都要 .to(device),漏一次就炸。这是训练循环对照的伏笔,张量节先建立肌肉记忆。
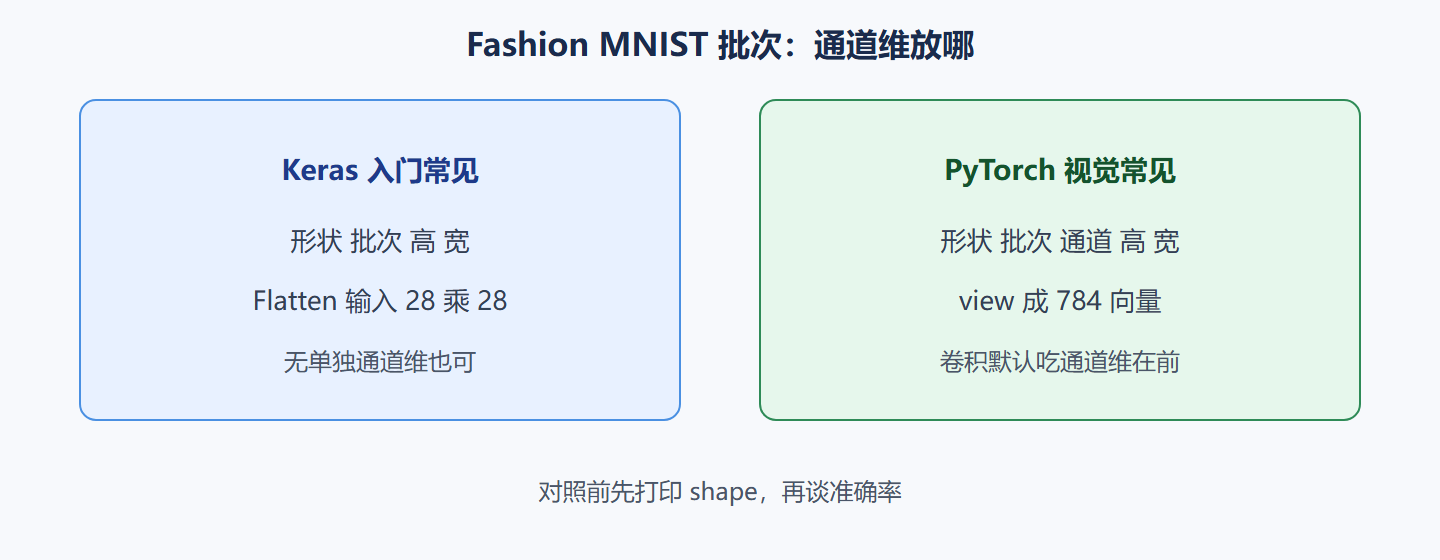
批次 64 张 28x28 灰度 Keras 常见形状: (64, 28, 28) → Flatten 吃掉后两维 PT 视觉常见形状: (64, 1, 28, 28) → view(-1, 784) 或 flatten
通道维约定有名字:TensorFlow / Keras 默认更常 NHWC(批次、高、宽、通道);PyTorch 默认 NCHW(批次、通道、高、宽)。灰度图通道为 1,NHWC 是 (64, 28, 28, 1),NCHW 是 (64, 1, 28, 28)。原文 Keras 入门把 input_shape=(28, 28) 交给 Flatten,等于告诉层「没有单独通道维,后两维都是空间」。PyTorch 示例则 x.view(-1, 28 * 28),-1 让批次维自动推断。两种写法都能把一张图变成 784 维向量,但你从卷积回头改全连接时,必须知道自己手里到底有没有那条通道维。
⚠️ 常见坑:把 PyTorch 的
(N, 1, 28, 28)直接喂给按(N, 28, 28)写的 TF 预处理函数,或反过来。数值能印出来,分类准确率会像随机。形状契约要写进对照笔记,与第 1.3 节的预处理笔记是同一类纪律。
float32 是默认工作精度:显存占用与速度的折中。float64 在科学计算常见,深度训练里反而更慢且占显存。整数标签是 int32 或 int64,不要把标签也除以 255。归一化只作用于像素张量。原文 Keras 路径是像素除以 255.0 落到 0–1;PyTorch 路径常 ToTensor(已经缩到 0–1)再 Normalize((0.5,), (0.5,)) 落到约 -1 到 1。这不是张量 API 差异,是数据管线默认差异,但第一次检查 min/max 是在张量节做最合适。
索引从 0 开始、切片含起不含终,两边一致。原文 3.1 演示右下角 2×2 子矩阵、带步长切片。对照练习建议:同一 NumPy 数组分别转成两侧张量,做完全相同的切片,打印是否相等。这比看文档更快建立信任。
最后谈可变性。TF 的 Variable 用 assign 一类方法改值;直接对 constant 赋值不是 Python 列表那种改法。PT 的叶子张量若 requires_grad=True,你应通过优化器或 with torch.no_grad() 改值,否则会搅乱计算图。入门分类器很少手动改权重,但加载预训练或实现自己的更新规则时,这条会咬人。
图 同一批像素的两种形状
对照现场怎么查形状
报错信息里出现 matmul 维度不兼容,先打印两边参与运算的 shape,不要先改学习率。TF 与 PT 的错误文案不同,但都在说同一件事:最后一维与对方的倒数第二维对不上。广播成功并不等于语义正确:把 (28, 28) 加到 (28,) 上,可能沿行广播,图像会被加上一条「每列一个数」的偏移,代码不报错,分类变差。所以「能跑」不是验收,「打印后能讲清每一维的含义」才是。
reshape 与转置的分工再记一次。reshape 按内存顺序重新切块,转置交换轴语义。把 NCHW 变成 NHWC 应转置,写成 reshape 会把通道像素拆进宽高,画面错乱。PyTorch view 在转置后常要求 contiguous,这是内存布局问题,不是数学问题。TF reshape 看起来更随和,仍可能静默排错。对照练习:用一张全零除了左上角为 1 的图,转完看 1 还在不在左上角。
随机数与复现。tf.random.set_seed 与 torch.manual_seed 管的范围不同,CUDA 还有独立种子。入门对照不要求跨框架比特一致,但要求「同一框架两次运行接近」。若两次 Keras 准确率差五个点,先查是否忘了种子、是否 shuffle 加上了未固定的 Python 随机增强。GPU 非确定性算法可能仍有微小抖动,Fashion MLP 上通常小于「预处理没对齐」的差距。
问题:必须把所有张量都放到 GPU 吗?
不是。模型和参与训练的批次要在同一设备。标签也要。指标累加用的 Python 数字可以在 CPU。有人把整个数据集一次性 .to(cuda),Fashion 放得下,真数据会撑爆显存。管线在 CPU 准备批次、循环里搬家,是更常见的模式。没有 GPU 时全部在 CPU,代码路径应仍走 .to(device),device 为 cpu,这样以后插上显卡不必改结构。
tf.Variable 与 torch.nn.Parameter 是「会被训练」的张量容器。普通张量即使参与了前向,也不一定能被优化器找到。Keras 层替你创建 Variable;nn.Linear 替你创建 Parameter。自己写 w = torch.zeros(3, 4) 当权重,必须包成 Parameter 并挂到 self。TF 自定义层里要用 add_weight 或 Variable。入门少写自定义层,但 2.1 就要知道:不是所有张量都是参数。打印 model.trainable_variables 或 named_parameters 是在问「谁有资格被更新」。
广播的对照练习建议固定用原文 3.1 的 2×2 加长度为 2 的向量,两侧都跑,确认结果矩阵相同。这比读规则快。切片对照用右下角 2×2。reshape 对照用 -1 推断。三道小题过了,Fashion 的 784 展平只是同一肌肉。GPU 小题:把该 2×2 迁到可用设备再加回来,打印 device 字符串。没有 GPU 时字符串应明确是 CPU,不要报错。报错说明迁移代码写死了 cuda。
重点提炼
- 张量四要素:秩、形状、dtype、设备;列表没有后两项,NumPy 默认缺设备与求导
- 创建分清常量与参数:
tf.constant对tf.Variable;torch.tensor对nn.Parameter/requires_grad - 运算几乎可互译:加减广播、
matmul、reshape/view、squeeze;注意 view 的连续性 - 设备要成对迁移:PT 循环里数据和模型都
.to(device);TFfit藏了不少,自定义训练则要自己管 - 通道维是第一形状分歧:
(N,28,28)对(N,1,28,28);卷积前必须统一 - 归一化不是张量 API:除以 255 对 Normalize 0.5 会改变输入分布,检查 min/max
把通道维分歧写成一条可执行检查:打印批次 ndim。Keras 数组路径常是 3,展平层吃掉后两维;PyTorch 视觉路径常是 4,view 吃掉后三维合成 784。两种都能接到全连接。卷积出现时,3 维必须先补通道。检查写在 2.1,是为了第 5 章 Conv2D 报错时你能回到这一页,而不是在学习率上打转。互转 NumPy 时记住:带梯度的张量要先断开追踪再转;from_numpy 可能共享内存,改数组会改张量。调试用副本,训练用框架张量,不要把 NumPy 当第三套运行时。
2 乘 2 加法、右下角切片、负一推断 reshape、设备字符串,四道小题构成张量节出门证。通道 ndim 检查留给图像批次。from_numpy 共享内存只在调试时当陷阱记住。float32 是工作精度,标签不要除以 255。归一化不是张量 API,是管线默认,但第一次 min max 在本节做最合适。四道小题不过,禁止进入求导。能加能切却在 Fashion 上 shape 错,去查通道维与 Flatten 位置,不要换优化器。
下一节对照自动求导:同样是这些张量,GradientTape 与 autograd 如何决定「哪些边该留下梯度」。