2.3 层与激活函数对照
2.3 层与激活函数对照
本节摘要:神经网络是层的有向堆叠:每一层对张量做仿射或卷积一类变换,再经激活函数引入非线性。Keras 用
Dense、Flatten、Conv2D等对象堆进 Sequential 或函数式 API;PyTorch 用nn.Linear、nn.ReLU、nn.Conv2d作为nn.Module的子模块,在forward里写数据怎么流。入门对照的焦点是全连接加 ReLU,以及输出层 Softmax 该不该写进模型——原文 PyTorch 分类器明确不在输出层做 Softmax,因为CrossEntropyLoss内部已含该步骤。
本节地图
阅读完本节,你应当能够:
- 说明没有非线性时多层仿射等价于一层,为何 ReLU 成为默认
- 对照
Dense(128, activation='relu')与Linear+ReLU的拆法 - 解释 Flatten /
view(-1, 784)在 Fashion MNIST 上的作用 - 判断多分类输出层何时放 Softmax、何时只出 logits
层是可学习的张量变换
一层全连接做的事情很短:y = activation(x W + b)。W 和 b 是参数,激活是固定函数。把很多层串起来,中间维数可以先放大再缩小,最后落到类别数。原文把「层、激活函数」定为模型架构的两块积木,而不是一上来就讲残差网络。对照课遵守这个范围:先会堆 Dense / Linear,卷积只作为「同一积木、不同局部连接」的预告,细节放到第 5 章。
没有激活时,两层矩阵乘还是一个矩阵乘,深度是假的。激活在每层输出上弯曲空间,网络才能逼近更复杂的决策面。ReLU 把负数打成 0、正数原样通过,计算便宜,梯度在正半轴为 1,不容易像 Sigmoid 那样大面积饱和。原文入门网络两侧都用 ReLU 做隐藏层,不是偶然。Sigmoid / Tanh 仍出现在需要输出有界的场合;Softmax 专管「一组数变成和为 1 的概率」。
Keras 允许把激活写进层参数:Dense(128, activation='relu')。也允许层后单独加 Activation。PyTorch 更常把 nn.Linear 与 nn.ReLU 拆开,在 forward 里顺序调用;也可以 nn.Sequential 把它们再叠回去。拆开不是更低级,而是让你在中间插入打印或额外运算时不必拆 Sequential。对照时以「计算图是否等价」为准,不以「是不是一行」为准。
Flatten 是图像进全连接的桥梁。Keras Flatten(input_shape=(28, 28)) 把每张图拉成 784,并在 Sequential 里声明输入形状。PyTorch 示例用 x.view(-1, 28 * 28),-1 吃掉批次维。功能等同,位置不同:一边是层对象,一边是 forward 里的视图操作。view 不引入参数,不是「一层」;但在画架构图时仍应画上「展平」,否则读者会以为 Linear 直接吃 4D 张量。
💡 关键直觉:把激活想成「每一层之后必须打一个折」,把 Softmax 想成「只在需要概率解释时才打的折」。训练用交叉熵时,第二折常常已经进了损失函数。
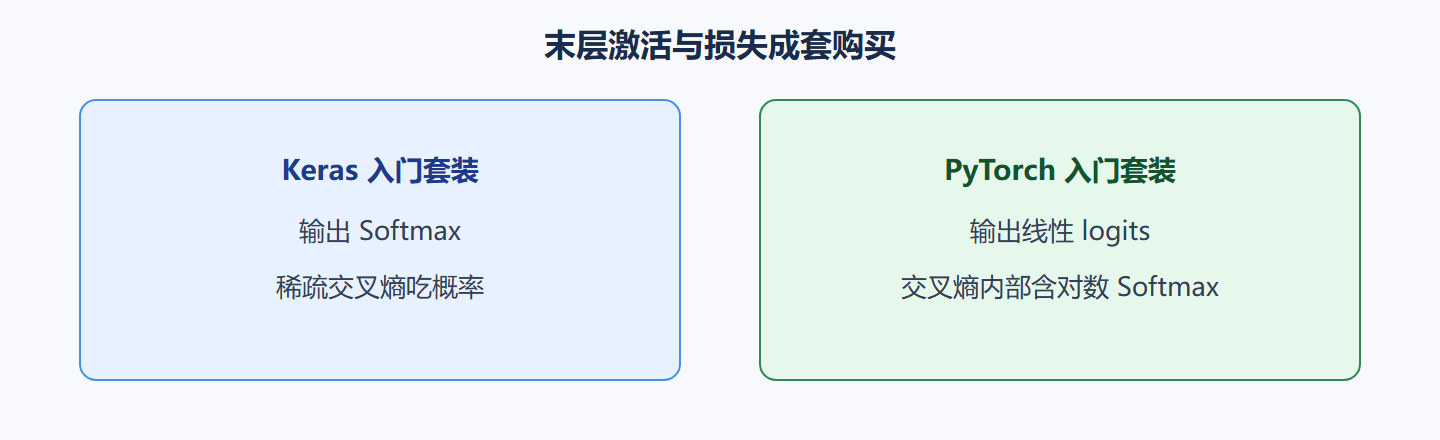
图 末层激活与损失必须成套
两侧常用层怎么对齐
原文 Keras 常用层清单包括 Dense、Conv2D、MaxPooling2D、Dropout、Flatten 等。PyTorch nn 模块里有对应的 Linear、Conv2d、MaxPool2d、Dropout。命名差一个大小写和一个 2D / 2d。卷积核、步幅、填充的默认值不一定相同:Keras Conv2D 默认 padding='valid';PyTorch Conv2d 默认 padding=0,这点一致。但 same 填充在 Keras 是字符串,在 PyTorch 要自己算或使用较新的 padding='same' 支持——入门卷积示例若两边输出空间尺寸对不上,先查填充而不是先改学习率。
Dropout 在训练时随机把激活置零,评估时关闭。这又回到 2.2:model.eval() / Keras 的学习阶段标志。只关梯度、不切评估模式,Dropout 仍会在验证时捣乱,准确率抖动。Batch Normalization 同理,入门 MLP 可以先不用,以免把「框架差异」与「统计层状态」混为一谈。
| 积木 | Keras | PyTorch | 入门用法 |
|---|---|---|---|
| 全连接 | Dense(units) |
nn.Linear(in, out) |
PT 必须写输入维,Keras 可从 input_shape 推断 |
| ReLU | activation='relu' 或 ReLU() |
nn.ReLU() 或函数式 F.relu |
隐层默认 |
| 展平 | Flatten |
view / flatten |
图像进 MLP |
| 二维卷积 | Conv2D |
nn.Conv2d |
第 5 章对照 |
| 最大池化 | MaxPooling2D |
nn.MaxPool2d |
降空间尺寸 |
| Dropout | Dropout(rate) |
nn.Dropout(p) |
注意 rate 与 p 都是丢弃比例 |
PyTorch Linear 必须显式输入维、输出维;Keras Dense 只要输出维,输入维等第一次调用或 input_shape 再定。这是动态与声明风格的缩影。函数式 Keras 用 Input 张量把形状钉死;nn.Module 在 __init__ 里钉死。两边都有「第一次前向才建权重」的懒创建变体,入门少用,以免打印模型摘要时权重还是空的。
输出层的神经元数等于类别数:Fashion MNIST 为 10。二分类可以用 1 个神经元加 Sigmoid,配二元交叉熵;多分类用 10 个神经元。Keras 原文入门在输出层写 activation='softmax',损失用 sparse_categorical_crossentropy。PyTorch 原文明确:输出层只出线性 logits,CrossEntropyLoss 内部包含 Softmax(更准确说是 log-softmax + NLL)。两侧若各按自己的惯例,数值上可以对齐;若你把 PT 模型也加 Softmax 再接 CrossEntropyLoss,等于 Softmax 了两次,训练会变傻。这是全书最高频的对照坑之一。
# Keras:激活写进 Dense # keras.layers.Dense(128, activation='relu') # keras.layers.Dense(10, activation='softmax') # PyTorch:拆开写,输出不加 Softmax # self.fc1 = nn.Linear(784, 128) # self.relu = nn.ReLU() # self.fc2 = nn.Linear(128, 10)
参数量可以心算核对:784×128 + 128 偏置,再加 128×10 + 10。打印 model.summary()(Keras)或打印模块 / 统计 numel()(PyTorch)应接近这个数。对不上就说明 Flatten 没生效或输入维写错。对照课把参数量当「形状契约」的校验和,比看准确率更早发现问题。
架构选择的取舍,而不是层收藏
入门只保留一个隐层 128,是原文的刻意小。加宽、加深都能抬训练集准确率,也更容易过拟合。Dropout 与权重衰减是后话(5.3)。这里先建立:层类型服务数据归纳偏置——像素网格用卷积共享空间权重,展平 MLP 把每个像素当独立特征,后者在 28×28 上勉强能用,换到更大图会立刻显得浪费。
Sequential 只表达单链。多输入、残差相加、注意力分叉,Keras 要用函数式或子类化 Model;PyTorch 本来就在 forward 里写 Python。原文 3.2 给了函数式多输入的拼接例子。对照含义是:当你的图不再是一条直线,Keras Sequential 先退出,PyTorch 几乎不换写法。选型节那句「动态图好写控制流」在层这一级就会兑现。
激活函数不是越多越炫。输出层用 ReLU 会截断负 logits,分类损失会怪;隐层用 Softmax 会强制竞争,通常不是你要的。把「最后一层激活」和「损失函数假定的输入」绑成一张小表贴在显示器上,能避免一半对照事故。
⚠️ 常见坑:在 PyTorch 输出层加 Softmax 却继续用
nn.CrossEntropyLoss;或在 Keras 输出层不设 Softmax 却使用未设置from_logits=True的交叉熵。原文 3.5 注释里写过:若最后一层没有激活,需要from_logits=True。这是 SOURCE 独有的编译细节,必须记住。
非线性与深度的关系还可以用「折纸」来想:每层 ReLU 是一次折叠,折叠次数不够,复杂边界展不开;折叠太多、数据太少,纸会在训练集上皱成过拟合。128 个单元、一层隐层,对 Fashion MNIST 是原文验证过的起点,不是魔法数。换数据集时重新估计容量,不要把 128 当成人格设定。
模块复用时,同一 ReLU 实例在 PT 里可以在 forward 中调用多次,因为它无参数;有参数的层不要指望共享却忘记共享权重的含义。Keras 函数式里重复调用同一个层对象才是共享权重。这和「新建一个同配置的 Dense」完全不同。对照到自定义双塔网络时会用上,入门 MLP 碰不到,但词汇要先放下。
从 MLP 迁到卷积时层怎么换
第 5 章会把 Conv2D / Conv2d 叠在 Flatten 之前。迁移时只改声明,不改损失与五步。Keras 需要给图像一个通道维,否则 Conv2D 不知道在哪一维上滑窗口。PT 的视觉张量惯例已经是通道在前。池化层无学习参数,却改变空间尺寸,summary 上要看到高宽减半(当池化核为 2、步幅为 2 时)。展平发生在所有空间层之后,再接 Dense/Linear。有人把 Flatten 仍放在卷积前,等于没卷积。对照 checklist 加一条:CNN 的 Flatten 在空间层之后。
Dropout 的位置通常在全连接之间,不太放在输入像素上(那等于随机挖掉像素,是另一种增强)。rate 过大,欠拟合会立刻出现。0.2 到 0.5 是常见搜索区间,本课第一轮过拟合才加,且只加一处。BN 层引入滑动平均,加载检查点时必须连同这些非梯度状态。入门 MLP 不加 BN,减少 state_dict 里的意外 key。等你加了 BN,4.4 的「结构和权重树一致」会更苛刻。
问题:为什么 Linear 要写输入维、Dense 可以不写?
Keras 层可以在第一次见到输入时再创建权重,所以 Sequential 第一层用 input_shape 或靠第一次 fit 触发 build。PT 的 nn.Linear 在构造时就要分配 weight 矩阵,必须知道 in_features。这不是谁更先进,是创建时机不同。函数式 Keras 用 Input 把时机提前,和 PT 一样在声明期钉死。子类化 Keras 的 build(input_shape) 又把时机推后。对照时认「权重何时诞生」,不要背「哪边必须写输入维」的死规则。
输出层用 ReLU 会截断负 logits,正确类若需要负分竞争会被压扁,交叉熵学得很吃力。这是「最后一层激活与损失配套」的反面教材。隐层用 Softmax 会让该层各单元互相抢归一化,通常不是你要的隐表示。把激活函数的「能写」和「该写」分开。Keras 把激活写进 Dense 很方便,也更容易随手给输出层抄上 relu。PT 拆开写,抄错的形态不同:给 fc2 后再接 ReLU。两侧各有典型抄错,对照课把它们写成检查清单第三行:打印未训练输出,看有没有被压成全非负或和为 1。
参数初始化两侧默认都不是全零。全零初始化会让对称神经元学同样的东西。不要为了「可复现」把权重设成全零,那是另一种算法。可复现靠种子,不靠全零。打印第一层权重的均值应接近 0、方差不是 0。全零或常数,说明你覆盖了初始化,训练会异常。
要点串联
- 层 = 参数变换 + 激活:无激活则多层仿射可合并;ReLU 是入门隐层默认
- Dense 对 Linear:Keras 可推断输入维,PT 必须写
in_features - 展平位置不同:Flatten 层对
view;都是把 28×28 变成 784 - Softmax 归属:Keras 入门常放输出层;PT +
CrossEntropyLoss放损失内部 - from_logits:Keras 输出无激活时必须打开,否则交叉熵假定已是概率
- 参数量校验和:784×128 + 128×10 加偏置,摘要对不上先查形状
层对照的验收是参数量接近 101770 以及未训练输出的形态正确。Keras 带 Softmax 时未训练输出应接近和为 1 的十维;PyTorch 未训练输出应是任意实数 logits,和不必为 1。形态反了,损失约定一定反了。激活函数清单不必背全:隐层 ReLU,输出按损失配套。Sigmoid 留给二分类单输出。卷积与池化的默认填充两侧都接近「不补边」,空间尺寸会缩小,summary 要对高宽。Dropout 的比例参数都是丢弃比例,评估模式必须关掉它,这与 2.2 的 eval 对 no_grad 分工衔接。
未训练输出形态检查:Keras 带 softmax 则十维和接近 1;PyTorch logits 和不必为 1。参数量接近 101770。输出层不用 ReLU。隐层不用 Softmax。Dropout 比例是丢弃。卷积填充默认不补边,高宽会变。BN 引入额外状态,入门 MLP 不加。Linear 要写输入维,Dense 可推断,认创建时机。共享权重是同一对象两次调用。把形态检查与参数量检查写进 4.1 与 4.2 的验收,源头在本节。源头错了,后面 summary 对不上只能回溯到这里。
把未训练输出形态与参数量 101770 当成 2.3 出门证。形态反了就是损失约定反了。输出不用 ReLU,隐层不用 Softmax。Dropout 是丢弃比例。卷积默认不补边。BN 入门不加。创建时机解释 Dense 与 Linear 的输入维差异。共享是同一对象两次调用。出门证是 4.1 与 4.2 验收的源头。源头错,后面只能回溯,不能靠加层掩盖。
把 101770 与输出形态写成两枚印章。印章盖上,4.1 与 4.2 才能开工。印章盖错,后面所有 summary 都是在盖错的纸上办公。办公越久,回溯越贵。贵的原因是你已经开始解释曲线,而曲线建立在错的输出形态上。形态先于曲线。这是层这一节对全书的命令。
审查印章两枚是否盖在未训练模型上。盖在训完的模型上,Softmax 形态会被学到的峰值掩盖,你看不出约定。未训练时形态最诚实。诚实的形态才能当源头。
下一节对照损失与优化器:稀疏交叉熵、Adam,以及学习率在两侧分别写在哪。