3.1 tf.data数据管线
3.1 tf.data 数据管线
本节摘要:
tf.data.Dataset表示一个样本序列,用转换把预处理、打乱、组批、预取串成流水线,训练时 CPU 准备下一批、GPU 计算当前批可以重叠。原文从内存张量的from_tensor_slices入手,演示map里写预处理(示例是特征加倍或标准化),再shuffle、batch、prefetch,最后把 Dataset 直接传给model.fit。入门数据若已全部在内存,这条管线看起来像多余;一旦图像要解码、增强,它就是 Keras 路径上的正统做法。
读前必看
阅读完本节,你应当能够:
- 说出 Dataset 相对「一大块 NumPy 直接丢给 fit」的三个好处:转换复用、流水重叠、规模可超出内存
- 用
from_tensor_slices((x, y))构建配对数据集并迭代一个元素 - 按推荐顺序连接
map、cache、shuffle、batch、prefetch - 解释
repeat与fit(epochs=...)同时出现时为什么容易把步数算乱
为什么 Keras 还要 tf.data
model.fit(train_images, train_labels) 在 Fashion MNIST 上完全合法,原文引言就是这么写的。那为什么第 3 章还要单独讲 tf.data?因为真实项目里 x 往往不是已经堆好的数组:图片在磁盘上、需要解码、随机裁剪、与标签对齐、还可能比内存大。把这些写进 Python for 循环再 train_on_batch,GPU 会周期性空转。tf.data 的目标是:用一套转换描述「样本怎么变成批次」,运行时用线程或后台流水把下一批准备好。
原文把核心概念说成:Dataset 是元素的序列,元素可以是张量、元组、字典。训练最常见的是 (特征, 标签) 元组。你对 Dataset 做的不是原地改,而是返回新 Dataset——像不可变链条。调试时在链条中段 take(1) 迭代打印形状,比等 fit 报错更便宜。
创建方法原文列了多种:from_tensor_slices 吃内存数组;from_generator 包 Python 生成器;从文件列表 map 读盘。入门用第一种。假设 x 形状 (1000, 20)、y 形状 (1000,),切片后每个元素是 (20,) 配标量标签。这和「第一个元素就是整个 1000」相反,初学者常在这里懵:slices 是按第 0 维切开。
💡 关键直觉:
from_tensor_slices的第 0 维是样本维。切完之后再batch(32),训练循环看到的才是批次维。
图 链条顺序不可颠倒
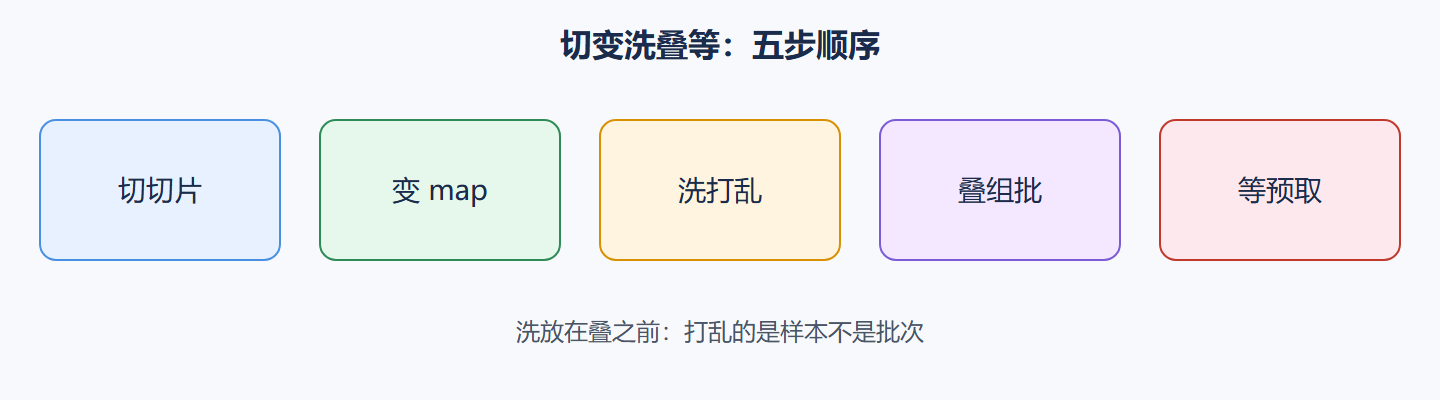
转换算子:原文出现过的那些
map 接收一个函数,作用于每个元素。原文示例:特征加倍,或做标准化。函数应尽量用 TF 运算而不是纯 Python 重循环,以便图优化;简单的标准化用 TF 减均值除方差即可。num_parallel_calls 可设成自动调优常量,让 map 并行。预处理里若混进不可微的 Python 随机,只影响数据、不影响梯度,这是允许的——增强本来就不应进 Tape。
shuffle 需要一个缓冲区大小。缓冲区太小,打乱不充分,等于几乎按原序训练;太大,内存涨。内存放得下整个训练集时,缓冲区可以设成样本数。Fashion MNIST 6 万,完全放得下。文件序列极大时,只能设一个折中窗口,并承认打乱是局部的。
batch 把连续元素叠成批次。drop_remainder 在有些 TPU 场景要 True,CPU 入门可 False,最后一批不足也留下。形状从 (28, 28) 变成 (32, 28, 28)。标签从标量变成 (32,)。fit 认这个结构。
prefetch 让数据集在模型训练当前批时准备下一批。原文完整管道示例把 prefetch 放在末尾,这是惯例:越靠近消费者越好。缓冲区 1 或自动调优即可,不必设成几百。
repeat 让序列循环。若 Dataset 已经 repeat 了指定次数,fit 再写 epochs 会让步数语义重叠,原文注释专门提醒:已经 repeat 的话 epochs 可以省略,或反过来不要双重循环。这是 SOURCE 独有的对接细节。推荐入门:Dataset 不 repeat,把 epoch 交给 fit(epochs=10)。
cache 把 map 之后的结果放内存或文件,适合预处理贵、数据能缓存的情况。第一次 epoch 慢、后面快,往往是 cache 生效。数据增强若希望每个 epoch 不同,cache 应放在随机增强之前,或干脆不 cache 随机部分。
| 算子 | 作用 | 入门建议 |
|---|---|---|
from_tensor_slices |
按样本切开内存数组 | Fashion 小数据首选 |
map |
逐元素预处理 | 标准化、类型转换 |
shuffle |
打乱 | 缓冲尽量覆盖训练集 |
batch |
组批 | 与对照实验统一 64 |
prefetch |
训练与加载重叠 | 放链条末尾 |
repeat |
无限或有限循环 | 入门交给 fit 的 epochs |
cache |
缓存 map 结果 | 无随机增强时可开 |
# 原文结构的概念管道:切片 → 预处理 → 打乱 → 组批 → 预取 # dataset = tf.data.Dataset.from_tensor_slices((x_train, y_train)) # dataset = dataset.map(normalize).shuffle(60000).batch(64).prefetch(1) # model.fit(dataset, epochs=10)
与 Keras 集成原文写得很直:model.fit(processed_dataset, epochs=...)。验证集另建一条,通常不 shuffle 或 shuffle 策略不同,且不要把测试集增强打开。fit(validation_data=val_dataset) 即可。元素结构必须与模型输入一致:单输入就是 (x, y);多输入要字典或元组对齐函数式模型的名字。对不上时错误发生在 fit 的第一批,读形状。
调试与性能的实际顺序
先正确后加快。链条写成后,用 for x, y in dataset.take(1) 打印 x.shape、y.dtype。标签若变成 float,后面稀疏交叉熵可能仍能跑,但最好保持整数。再跑一个 epoch,看 GPU 利用率:若很低且 CPU 打满,map 太重或没 prefetch;若都很低,瓶颈在模型太小(Fashion MLP 经常如此),不要为了利用率把管道复杂化。
⚠️ 常见坑:
shuffle放在batch之后,变成「打乱批次顺序」而不是打乱样本。另一坑:在 map 里用 NumPy 随机,且没设tf.data的确定性选项,导致对照实验无法复现。
顺序惯例:先 map(或先 cache 再 map 视增强而定)→ shuffle → batch → prefetch。shuffle 在 batch 前,保证批次内样本来自打乱后的流。有人反向记忆,因为「先组批再打乱更省」,那打乱的是批,类别均衡会变差。
从生成器创建时要注意:生成器是有状态的,repeat 行为与切片不同,多进程也更脆。能切片就切片。文件读取用 Dataset 列表 map 读字节再解码,路径字符串会出现在代码里——平台规范禁止在教程正文写具体磁盘路径,用「数据根目录下的文件列表」描述即可。本课入门不依赖读盘。
AUTOTUNE 让运行时选并行度。它不是「越自动越快」的保证,而是避免你随手写 num_parallel_calls=8 在双核笔记本上过订阅。写入笔记:对照实验两侧都用小模型时,管道优化的绝对收益可能小于随机种子。仍要学正确顺序,换大数据时才有肌肉记忆。
最后,fit 吃 Dataset 时不要再传 batch_size 参数去「再切一刀」,批次已由 Dataset 决定。重复指定会让人以为 Keras 又切了一次。验证这一点的方法是打印一个批次形状,确认第一维是 64 而不是 64 乘别的数。
和文件、增强、确定性有关的细节
从文件构建时,Dataset 通常先持有路径字符串列表,再 map 读字节、解码、缩放。解码要用 TF 的图像解码函数,才能并行。用纯 PIL 在 map 里读,num_parallel_calls 的收益会下降,还可能碰到全局解释器锁。本课入门不走文件,但你要知道:数组切片是教学入口,文件链条才是生产入口。生产入口上,cache 到内存或本地缓存文件,往往比反复解码更划算。
确定性训练需要同时固定 Python、NumPy、TF 的种子,并在 Dataset 上关闭某些非确定的并行优化。完全确定性在 GPU 上仍然困难。对照课把目标定为「同框架两次接近」,不要追求与 PT 比特一致。shuffle 的缓冲若小于全集,两次运行的第一批本来就可以不同,这是算法使然。评估管线应 shuffle=False,否则你「每次 evaluate 数字略变」会误判成模型不稳。
padded_batch 在变长序列出现,图像尺寸一致时用不到。误用 padding 会在空间维填 0,卷积会看见黑边。Fashion 保持 28×28,普通 batch 足够。unbatch 用于调试,把批次拆回样本看某一张。链条是可逆的,调试时大胆 take、unbatch、打印,不要等到 fit 第三 epoch 才看第一张图。
问题:fit 传入 Dataset 还要不要 steps_per_epoch?
若 Dataset 有限且没有无限 repeat,Keras 可以自行走完一个 epoch,不必写 steps_per_epoch。写了反而可能提前截断或重复取。无限 repeat 时必须写步数,否则一个 epoch 不会停。原文注释的核心就是避免双重循环。入门选择有限 Dataset + epochs=10,少一个旋钮。验证集同理,不要把验证 Dataset 写成无限。
from_tensor_slices 传入一对数组时,第 0 维必须等长,否则创建即失败。这是标签与特征对齐的第一道闸。特征 60000、标签 59999 会在这里爆,而不是在 fit 中途爆。map 进出结构要稳定:进去 (x,y) 出来仍是 (x,y)。prefetch 放在 batch 之后,预取的是批次。口诀:切、变、洗、叠、等。写反则 3.3 对照表跟着反。先正确链条,再加 AUTOTUNE 并行。
核心回顾
- Dataset 是转换链条:切片创建,map/shuffle/batch/prefetch 返回新对象
- slices 切第 0 维:切完才是单样本,batch 之后才是训练循环看到的形状
- 与 fit 对接:直接传入 Dataset;epoch 与 repeat 不要双重计算(原文注释)
- shuffle 在 batch 前:打乱样本而非打乱批
- prefetch 放末尾:让准备下一批与当前计算重叠
- 先打印一个批次:形状与 dtype 对了再谈加速
tf.data 验收:take(1) 得到的批次第一维是 64,标签是整数,map 之后仍是特征加标签一对。shuffle 缓冲在内存允许时应覆盖训练集,避免只打乱窗口。prefetch 在末尾。repeat 不要与 fit 的 epochs 叠成无限循环。cache 不要冻住随机增强。这些句子每一条都对应过一次真实事故。链条写完先 take,再 fit。fit 报错再拆链条,不要在 fit 的第三 epoch 猜测是不是 shuffle 放错。与 Keras 数组 fit 相比,Dataset 路径多出来的价值是转换可复用和流水重叠,Fashion 上价值小,文件数据上价值大。本章用小数据买的是肌肉记忆。
与 fit 对接时,Dataset 的元素结构必须匹配模型输入。单输入就是特征加标签;多输入要用元组或字典对齐函数式模型的输入名字。对不上发生在第一批,读形状。不要把 batch_size 再传给 fit。steps_per_epoch 只在无限 repeat 时需要。有限链条让 Keras 自己走完更安全。map 里只用 TF 运算,才能并行。Python 重循环会把 AUTOTUNE 变成摆设。cache 放在确定性强的解码之后、随机增强之前。评估链条 shuffle 关闭,增强关闭。这些是 3.1 的家规,3.3 对照表左边一列全部来自这里。家规执行到 take(1) 为止,不要执行到「我感觉管道很快」。
把口诀切变洗叠等写成链条注释,每一段转换后都可以 take(1) 打印。哪一段形状坏了,坏在哪一段,不要整链建完再猜。repeat 与 epochs 二选一作为 epoch 控制源。cache 与随机增强互斥位置。评估链关闭 shuffle 与增强。map 用 TF 运算。元素结构保持一对。batch 之后不要再给 fit 传 batch_size。这些是可操作的闸门,不是风格建议。闸门过了,prefetch 开不开都无所谓,因为 Fashion 拷贝本来就便宜。闸门没过,prefetch 只会让错误来得更并行。
把分段 take(1) 当成调试的唯一合法方式。整链猜错位置是非法调试。口诀顺序是法律。repeat 与 epochs 二选一是法律。评估关闭 shuffle 是法律。法律过了,prefetch 只是礼貌。礼貌可以没有,法律不能没有。没有法律的快,是把错误预取到 GPU 上而已。
审查 take(1) 的标签是不是长度为批次的一维整数。二维可能是 one-hot,本课不走。走了必须改损失名字,对照表会多一行约定。能不加就不加。不加的前提是审查过。没审查就 fit,等于把审查推迟到报错信息里,报错信息不一定提到标签编码。提到形状的报错更常见,更容易把你带去改 Flatten。
下一节看 PyTorch 如何把「一条样本」和「一串批次」拆成两个类,以及 Windows 上多进程的原文警告。