2.2 计算家族:EC2/ECS/EKS 三家对照
2.2 计算家族:EC2/ECS/EKS vs 阿里云 vs 腾讯云
本节摘要:计算服务是云上"机器"的根。三家云在"虚机、容器、K8s 集群"三种部署形态上各自有产品矩阵,但命名、计费单位、调度粒度差异巨大。本节给一张三栏对照表 + "什么时候用虚机、什么时候用 K8s"的决策依据。学完本节,你能在面对"上 ECS 还是上 K8s"这种工程决策时给出有理有据的判断。
学习目标
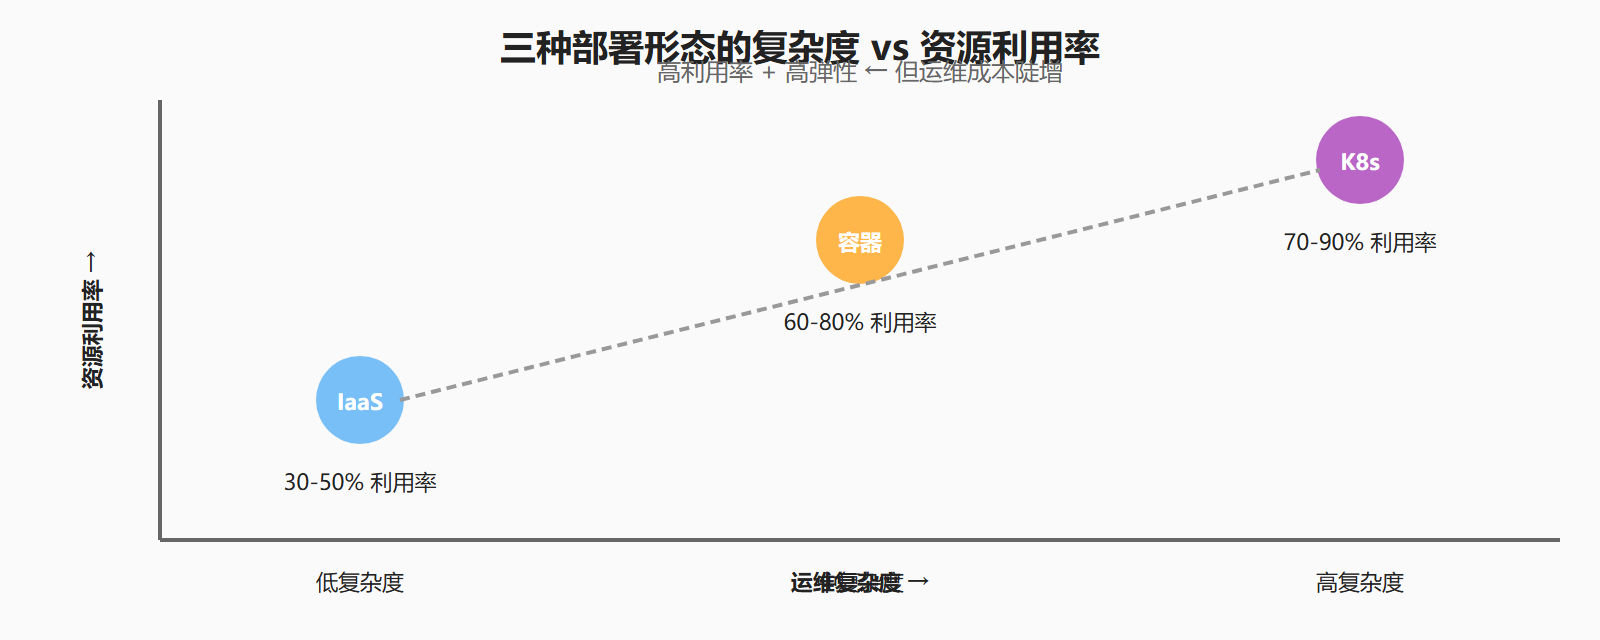
图:部署形态复杂度对比
阅读完本节,你应当能够:
- 说出 AWS / 阿里云 / 腾讯云三家在"虚机、托管容器、K8s 集群"上的对应产品(EC2/Fargate/EKS vs 阿里云 ECS/弹性容器实例/ACK vs 腾讯云 CVM/EKS-TKE)。
- 理解"虚机 vs 容器 vs K8s"三种部署形态的核心权衡:启动时间、资源利用率、运维复杂度、可移植性。
- 针对一个真实业务("我们有个 10 个微服务的电商系统")给出容器化路径建议。
- 知道 Fargate / 弹性容器实例 / EKelet 这类"无服务器容器"的真实价值:何时该用、何时不该用。
一、先看个反例:不是所有业务都需要 K8s
K8s 是云原生的"标准答案"——但答案不一定对。
举一个反例:某团队为了"拥抱云原生"把一个 3 个微服务的内部系统迁到 K8s。结果 6 个月后:集群管理员要学 30 个 K8s 概念(Pod、Deployment、Service、Ingress、ConfigMap、Secret、PV、PVC、StatefulSet、DaemonSet、Job、CronJob、NetworkPolicy、HPA、VPA、Cluster Autoscaler、Helm、Operator、CRD、Admission Controller...),还上了 Prometheus + Grafana + EFK + Istio + Argo CD 监控栈。整个迁移花了 200 人天,而系统 QPS 从来没超过 100。
正解:3 个微服务、日均 1 万请求的业务,直接用 3 台 ECS + Nginx 反代 + RDS 即可,K8s 完全是过度工程化。K8s 的复杂度只有在"微服务 ≥ 10 个、QPS ≥ 1000、团队 ≥ 5 人"时才划算。
二、核心原理:三种部署形态与产品矩阵
2.1 三种部署形态对比
| 维度 | 虚机(IaaS) | 托管容器 | K8s 集群 |
|---|---|---|---|
| 启动时间 | 1-3 分钟 | 30 秒 | 1-2 分钟(Pod 启动) |
| 资源利用率 | 30-50% | 60-80% | 70-90% |
| 运维复杂度 | 低 | 中 | 高 |
| 可移植性 | 低(与云绑定) | 中(容器镜像可移植) | 高(K8s 标准) |
| 适用规模 | 任意 | 5-50 微服务 | 20+ 微服务 |
| 学习曲线 | 1 天 | 1 周 | 1 个月 |
| 典型代表 | EC2 / ECS / CVM | Fargate / 弹性容器实例 / EKelet | EKS / ACK / TKE |
2.2 三家云产品矩阵
| 部署形态 | AWS | 阿里云 | 腾讯云 |
|---|---|---|---|
| 虚机 | EC2(Elastic Compute Cloud) | ECS(Elastic Compute Service) | CVM(Cloud Virtual Machine) |
| 托管容器 | Fargate(搭配 ECS/EKS) | 弹性容器实例 ECI | EKelet(Serverless 容器) |
| K8s 集群 | EKS(Elastic Kubernetes Service) | ACK(Container Service for Kubernetes) | TKE(Tencent Kubernetes Engine) |
| 裸金属 | EC2 Bare Metal | ECS Bare Metal | CVM Bare Metal |
| GPU 实例 | P3/P4/G4/G5 | GN5/GN6/GN7 | GN10X/GN7 |
2.3 三种部署形态的 mermaid 视图
三、工程实践要点:选型决策
3.1 真实案例:电商系统的容器化路径
某电商 2020 年的架构演进:
| 阶段 | 时间 | 部署形态 | 微服务数 | 月基础设施成本 |
|---|---|---|---|---|
| 阶段 1 | 2020 Q1 | 5 台 ECS + 1 个 RDS | 3 | 8000 元 |
| 阶段 2 | 2021 Q2 | 20 台 ECS + K8s on ECS | 12 | 28000 元 |
| 阶段 3 | 2022 Q3 | 阿里云 ACK 托管 + ECI 弹性 | 25 | 35000 元(弹性扩容) |
| 阶段 4 | 2023 Q4 | ACK + Fargate 模式 + 自动扩缩 | 30 | 25000 元(弹性优化) |
关键转折:阶段 3 用了托管 K8s,省掉了 1 个全职 SRE 工资;阶段 4 引入 ECI 做弹性扩容,秒杀期间 5 分钟扩容到 100 Pod,活动结束自动释放。
3.2 选型决策表
| 业务特征 | 推荐部署 | 理由 |
|---|---|---|
| 微服务 ≤ 3 个、日均 ≤ 1 万 QPS | 虚机(ECS) | K8s 是过度工程化 |
| 微服务 5-20 个、流量有规律 | 托管 K8s(ACK/TKE) | 平衡运维和弹性 |
| 微服务 20+ 个、流量大峰谷 | K8s + Fargate/ECI | 极致弹性 |
| 短任务(CI/CD、批处理) | Fargate/ECI/EKelet | 按秒计费 |
| AI/ML 训练 | GPU 虚机(按需) | GPU 资源池化 |
| 传统 Java 单体应用 | 虚机 + Tomcat 自管 | 没必要容器化 |
3.3 反例:K8s 不是越多越好
| 反例 | 后果 | 正解 |
|---|---|---|
| 3 个微服务上 K8s | 运维成本超过收益 | 直接用虚机 + Docker Compose |
| 没有监控上 K8s | 出问题不知道怎么排查 | 先有 Prometheus + Grafana |
| 没有 CI/CD 上 K8s | 镜像手动 kubectl apply | 先有 GitOps 流水线 |
| 单 Region 部署 + K8s 多集群 | 增加复杂度无收益 | 单集群足够 |
⚠️ 常见坑:"我们用了 K8s" ≠ "我们享受了 K8s 的好处"。K8s 是一套"约定大于配置"的系统——如果你的应用没有按 12-factor 改造(健康检查、配置外置、优雅停机、日志结构化),上 K8s 只会增加故障面。没有改造好就跑 K8s = 把混乱的东西放到更复杂的环境里。
💡 关键直觉:部署形态的选择不是"先进 vs 落后",而是"复杂度匹配业务规模"。一个 QPS 100 的内部工具用 K8s 是浪费,一个 QPS 10 万的电商用虚机是瓶颈。判断标准是"你的运维能力能否驾驭这个复杂度"。
本节小结
- 三种部署形态的权衡:虚机(简单、低利用率)、托管容器(中等、利用率提升)、K8s(高利用率、高复杂度)。
- 三家云的产品矩阵高度同构:EC2/Fargate/EKS vs ECS/ECI/ACK vs CVM/EKelet/TKE。
- K8s 不是越多越好:3 个微服务上 K8s 是过度工程化,20+ 微服务才划算。
- Fargate / ECI / EKelet 是"无服务器容器":短任务 + 突发流量的最佳选择。
- K8s 价值的前提:应用已 12-factor 化、有完整 CI/CD 和监控。
下一节我们切到"存储"——对象 / 块 / 文件三种存储模型的不可替代性。