1.1 定义与六十年演进之路
1.1 定义与六十年演进之路
本节摘要:人脸识别(Face Recognition)是基于生物特征的身份识别技术,它让计算机从图像或视频里自动完成"检测到人脸—提取特征—判定身份"这一连串动作。本节从定义出发,沿六十年技术年表走一遍,你会看到每一次"断案思路"的更替,以及为什么今天的答案叫"深度学习特征"。
学习目标
阅读完本节,你应当能够:
- 用一句话区分人脸识别与人类看图,说清它"认"的是什么。
- 说出演进中三次关键转折的时间与动因。
- 判断某条技术路线属于几何派、统计派还是学习派。
一、问题与直觉
先看一个你会亲历过的场景。深夜加班回家,楼道里光线昏黄,你掏出手机,屏幕亮起,前置摄像头扫过你的脸,锁开了。整个过程不到一秒。但你有没有想过:同样是你这张脸,早上屏幕能解锁,晚上贴着面膜、戴了半张脸的黑框眼镜,锁还是开了——它到底"认"到了什么?
人眼看图,靠的是整体判断:这脸的神情、轮廓、熟悉感。机器完全不是这么回事。给计算机一张照片,它看到的只是几十万个亮度数值,至于哪块是鼻子、哪块是眉毛,它一开始一无所知。人脸识别要做的,就是从这堆数字里抽出一段"稳定的、可重复的、和别人不同的签名",下次再见这张脸时拿签名去对账。一句话:人脸识别,是把一张脸变成一段可反复对账的"身份签名"的技术。
这句话里藏着它和"人脸检测""人脸比对"的区别。检测只回答"有没有脸,框在哪";比对回答"这两段签名像不像";识别才是完整的"采集到判定"。很多场合这几个词被混用,但搞清边界,后续读代码、看指标才不糊。
二、核心原理:三次断案思路的更替
若要给这段历史画出一条主线,那就是"人到底该由谁来定义什么是脸"。前几代靠人手工定规则,最后深度学习干脆把"定义什么叫像"交给了数据。
第一代:几何量脸(1960s—1970s)
早期计算机算力金贵,Woody Bledsoe、Charles Bisson 等人走了最直接的路:人工在照片上标出眼睛、鼻子、嘴角的位置,然后量它们之间的距离和比例——眼距、鼻宽、口鼻距——作为"脸谱"。听起来很合理,问题也立现:手标成本高得离谱,而且一旦家人换个表情,比例全变。
# 极简的几何脸谱示意:把关键点坐标压缩成一串比值 landmarks = {"left_eye": (30, 28), "right_eye": (58, 28), "nose_tip": (44, 45), "mouth": (44, 61)} def geosign(lm): eye_w = lm["right_eye"][0] - lm["left_eye"][0] # 眼距 mouth_h = lm["mouth"][1] - lm["nose_tip"][1] # 鼻口距 return eye_w, mouth_h # 两三个数当"身份签名" print(geosign(landmarks)) # 输出 (28, 16)
这段代码的真意不在数值,而在思路:把"一个人长什么样"压缩成极少数几何量。它几乎不能用于任何真实场景,却点破了后来一切的动机——压缩。
第二代:统计降维(1980s—1990s)
Knby、Sirovich 和后来的 Turk、Pentland 换了个玩法:不再手工挑指标,而是对整批人脸照片做主成分分析(PCA),找出最能区分彼此的那几条"平均脸分量",这就是著名的特征脸(Eigenfaces)。紧跟着的 LDA/Fisherfaces 更进一步,用上了类别信息,朝"更分得开"的方向投影。这一代奠定了"把人脸投到低维子空间再比距离"的模板,也是第 3 章要细讲的数学核心。
第三代:手工视觉特征(2000s)
Viola-Jones 的级联分类器让"快速找脸"第一次上了消费级硬件,Haar 特征加 AdaBoost 成了那个时代检测的事实标准。特征提取端则流行局部二值模式(LBP)、方向梯度直方图(HOG)这类对光照相对不敏感的手工纹理特征。这一代的好处是轻快可解释,代价是"特征由人设计"——人想不到的特征,它就没有。
第四代:深度学习(2012 至今)
2012 年 AlexNet 在 ImageNet 上夺冠,人脸识别随即迎来拐点。DeepFace、DeepID、FaceNet 相继登场:不再手写规则,卷积网络从海量人脸里自己学出判别性极强的特征,配合第 3 章会讲的三元组损失、角度间隔损失,识别率跃过了人眼水平。前置条件是数据与算力——MS-Celeb-1M 这类千万级数据集,加上 GPU 的普及,"从数据里学什么叫像"第一次成为现实。
下面这张时间线把四次更替叠在一张图上,方便你一眼记住"哪一代靠人、哪一代靠数据"。
图:人脸识别四代演进时间线
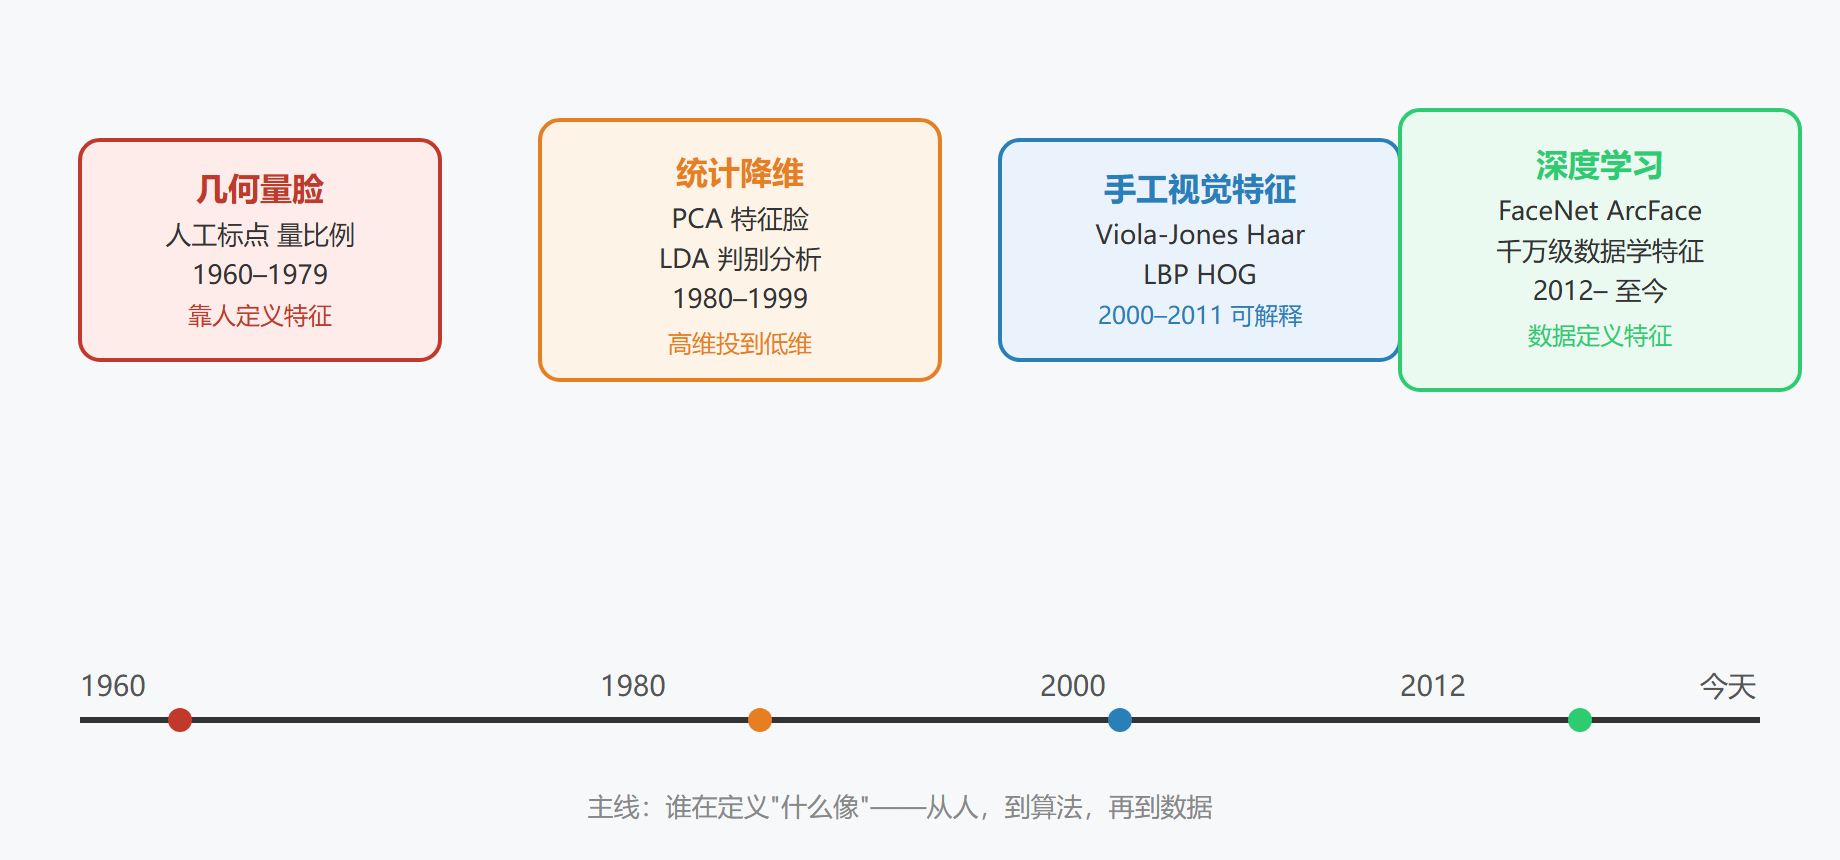
图:演进时间线
这张图把四代方案按时间排开,横轴是年份,纵向是"定义者"的转移。注意色彩由红转绿,对应的正是"人制定特征"到"数据学特征"的转变——这也是今天一切人脸识别方案都以深度学习为主题的根。
如果嫌时间线太密,下面这张继承关系图只看"谁接谁的班":
四代的对比可以在一个表里收干净:
| 代线 | 特征从哪来 | 代表方法 | 优势 | 致命短板 |
|---|---|---|---|---|
| 几何量脸 | 人手工标注 | 关键点比例 | 简单、算得快 | 表情/角度变化就失效,手标贵 |
| 统计降维 | 统计学压缩 | PCA/LDA 特征脸 | 有理论框架 | 依赖对齐与光照,特征信息有限 |
| 手工视觉特征 | 人设计算子 | Haar、LBP、HOG | 轻快、可解释 | 人想不到的特征它就没有 |
| 深度学习 | 数据自学 | CNN、FaceNet、ArcFace | 判别性强、抗变化 | 数据与算力门槛高,难解释 |
⚠️ 别当着"淘汰"看这段历史。深度学习成了主流,不代表前几代被丢进垃圾堆:光照稳定的窄场景至今仍有人用传统方案省钱省电。真正的判断标准始终是"特征从哪来"以及"你的数据够不够多"——这也决定了第 3 章选型的方向。
💡 一句话记住演进:每一代更替,回答的都是同一个问题——"什么叫像"由谁定义。从人量比例、统计压缩、手工算子,到最终交给千万级数据自学,这条主线贯穿整部人脸识别史。
三、这一节的坑与判断
- 别把"检测"和"识别"混成一步。检测只负责出框,识别才负责出身份,两套模型、两种评估,混用会直接把流程设计带偏。
- 别迷信"越新越好"。光照稳定的门禁场景,一个轻量的传统方案够用又便宜;只有在面对千万级开放库、跨姿态跨光源时,深度特征的优势才充分兑现。
- 判断一个方案属于哪一代,看它的"特征从哪来":人定的几何量、统计压缩、手工视觉特征、还是网络自学。这是最快的一句话判别法。
本节要点回顾
- 主干判定:人脸识别 = 把脸压缩成可对账的身份签名,检测出框、比对出分、识别出人。
- 四代演进:几何量脸 → 统计降维 → 手工视觉特征 → 深度学习,定义者从人走向数据。
- 课题主线:一切技术更替都在回答"什么叫像",今天由千万级数据回答。
- 结论:识别效果的物理下限,由"特征的稳定性与可分性"共同决定。
你已经理解了历史的脉络,下一节我们把视线收回到当下,把"断案流水线"的工位一个个排开,建立全书的空间总图。