2.5 比对与识别决策
2.5 比对与识别决策
本节摘要:比对是把刚提取的身份签名,和库里的千万条注册签名逐一比较,算出一个相似度或距离;识别决策则拿着这个分数,对照阈值推断"是不是他"或"他是谁"。本节讲清欧氏距离、余弦相似度、汉明距离各适用何种特征,以及阈值判定的学问和它对 False Acceptance/False Rejection 的权衡。
学习目标
阅读完本节,你应当能够:
- 说清相似度与距离的关系,以及如何对应"像不像"。
- 对比三种常用度量(欧氏、余弦、汉明)的取向与适用特征。
- 理解阈值如何决定误识与拒识的此消彼长,并说明如何挑阈值。
- 解释 Top-N 与 1:N 搜索中比对的角色。
一、问题与直觉
假定你手里已经有一段几百万维的"身份签名",而库里有几百万条注册签名。接下来是一个朴素到不能再朴素的问题:它像哪条,像到什么程度?比对要回答的就两个数字:相似度与阈值。相似度衡量"两段签名离多远";阈值是你在"宁可错杀"还是"宁纵勿枉"之间划的那条线。可见,模型再强,把分数翻译成身份的阈值没定好,系统照样会在自家门口放错人、误拦人。
二、核心原理:度量与阈值
三种常用度量,各配一种特征
度量决定"怎么算像"。常用三种,逻辑各有偏向:
- 欧氏距离:两向量直线距离,越小越像。直观但受特征尺度牵制,适合幅度本身有意义的浮点特征。
- 余弦相似度:只看方向、不看振幅,两向量夹角越小越像。对浮动幅值、归一化嵌入格外友好,深度学习嵌入普遍用它在比"方向"。
- 汉明距离:统计两个二进制串有多少位不同,只适用于二值化特征,快但信息量有限。
一个印证:现代深度嵌入基本都先做归一化再用余弦相似度——因为它自动忽略"整体亮度高一点低一点"这类全局伸缩,天然贴合"越关注方向、越有助于跨光照"的诉求。传统 LBP 直方图则常用卡方或直方图交叉距离(这类度量按分布比相似,正好对得上特征的性质)。
import numpy as np def cosine_sim(a, b): a, b = a / np.linalg.norm(a), b / np.linalg.norm(b) # 归一化看方向 return float(a @ b) # 点积 = 夹角余弦 def euclid_dist(a, b): return float(np.linalg.norm(a - b)) # 直线距离 print(cosine_sim([1, 0, 2], [2, 0, 4])) # 0.9999… 方向几乎相同 print(euclid_dist([1, 0, 2], [2, 0, 4])) # 2.23,幅度差也被计入
上面这个对比很有用:向量 [1,0,2] 和 [2,0,4] 只是同方向放大两倍,余弦给接近满分,欧氏却判了不小的距离——这正是"要不要把整体强弱算进像不像"的分歧。
阈值:系统良心的刻度
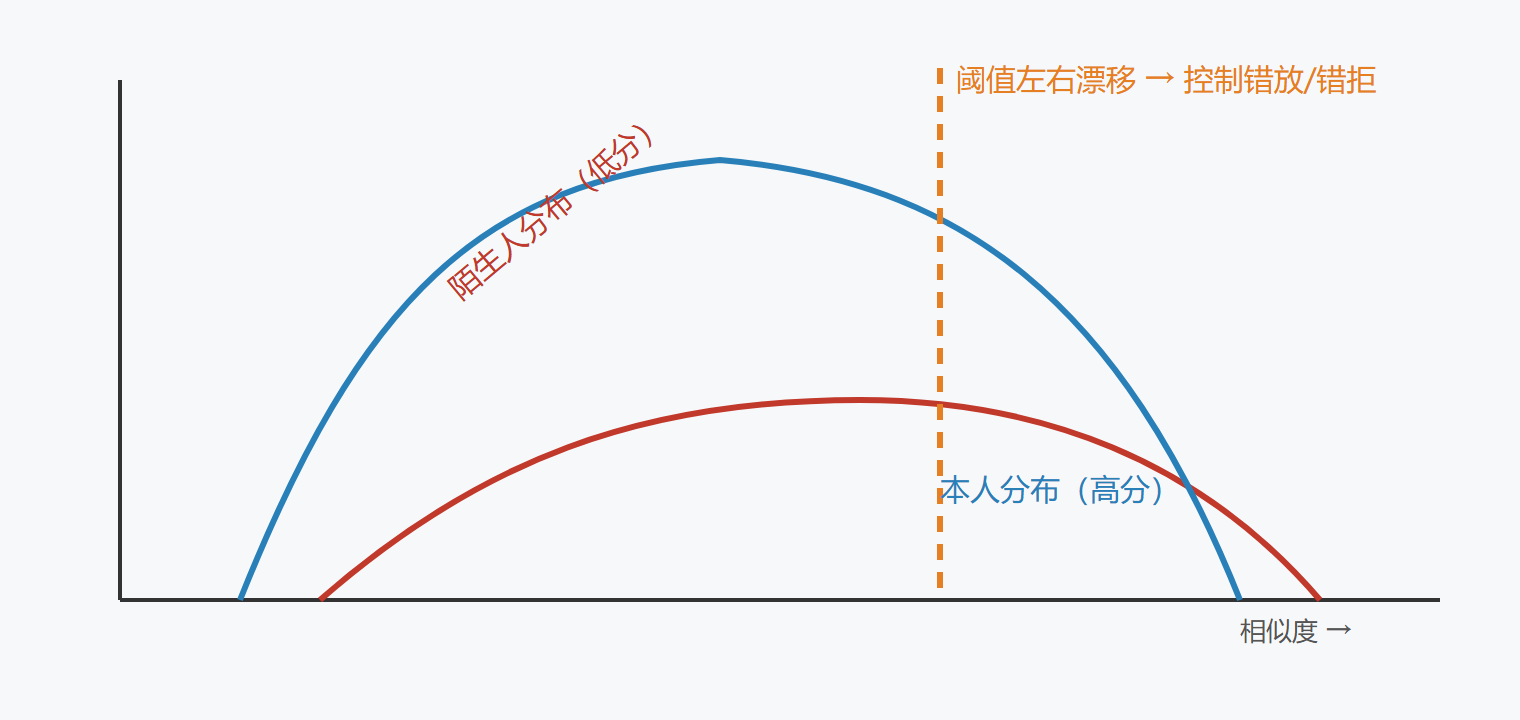
拿到相似度后,剩下的就是把"分数"翻译成"身份"。最常见的是阈值法:高于阈值放行(当作本人),低于则拒绝。这一个数字同时管着两件对立的事——放行越松,越容易放错人(误识,False Acceptance);放得越紧,越容易把达标的本人拦在门外(拒识,False Rejection)。误识与拒识此消彼长的平衡点,就是下一章会用到的等错误率(EER)。挑阈值,本质是按场景在"错放"和"错拒"之间挑立场:门禁宁可偶尔误拦,也不轻易放陌生人;黑名单核验则宁可多过一点,也不漏掉风险人。
Top-N 与搜索:比对在 1:N 里的角色
在 1:N 搜索里,比对还多一层"要不要把整库全比"的问题。小库可拿查询向量和全体逐条比,取相似度最高的 Top-K 作为候选;大库则得靠向量索引(如基于聚类的倒排、乘积量化)先粗召回、再精排,控制"每次查询要和多少条比"。这部分细节在第 4.5 节接续,本处先立住一句话:比对质量决定"找得准不准",索引策略决定"找得多快"。
一个可设想的调阈值过程:300 人的公司门禁
假定你给三百人的公司楼道装刷脸门禁。你手头有一段"本人 100 张、陌生人 100 张"的验证集。先跑一遍全部比对,得到每个人的相似度分布,你会看到两条钟形曲线:本人这条整体偏高、集中在 0.75 附近;陌生人这条偏低、落在 0.4 左右,但两条曲线在 0.6 附近会有交叠。
def pick_threshold(scores_pos, scores_neg, prefer_far=0.001): best = None for t in np.linspace(0.3, 0.9, 61): # 枚举候选阈值 far = sum(s >= t for s in scores_neg) / len(scores_neg) # 陌生被放 tpr = sum(s >= t for s in scores_pos) / len(scores_pos) # 本人被放 if far <= prefer_far and (best is None or tpr > best[2]): best = (t, far, tpr) return best # 返回 (阈值, 此时FAR, 此时TPR)
门禁讲究安全,你把 FAR 压在千分之一以下;结果阈值会被推到偏高,原本个别表情严肃、光线差的本人可能被拒——于是你的 FRR 变大了。你不甘,再回去把录入时的人脸质量抓严一点、补一面顺光,曲线整体右移,FRR 就降回来了。这个过程说明:阈值不是孤立拍的,它和录入质量、预处理强度一起被反复校准,评估与调优(第 5 章)正是干这件事的系统化方法。
下面这张图把阈值两端的权衡摊在一张图上:横轴是相似度,两条曲线分别在堆高"本人"和"陌生人",中间那道竖线就是你定的阈值,它的左右移动会让两条尾巴各自牺牲。
三种度量的取向,用一个表对照最好记:
| 度量 | 怎么算"像" | 最适合的特征 | 一句话优点 |
|---|---|---|---|
| 欧氏距离 | 直线距离越近越像 | 幅度有意义的浮点向量 | 直观、可解释 |
| 余弦相似度 | 夹角越小越像 | 归一化的深度嵌入 | 抗整体幅值伸缩 |
| 汉明距离 | 位数差异越少越像 | 二值化特征 | 极快、省存储 |
三、工程实践要点
- 深度嵌入配余弦相似度、传统直方图配直方图类距离,度量要和特征的性质对表。
- 阈值永远要对着你场景的"错放/错拒代价"来定,别照抄别家的默认值,不同库、不同光照下最优阈值会漂。
- 1:N 大库必须上索引,别指望暴力逐条比对,否则查询耗时会随库增长线性炸开。
💡 关键直觉:比对是"量距离",决策是"划界"。模型管"比得像不像",阈值才管"敢不敢认"。
⚠️ 常见坑:把相似度直接当概率用。相似度是相对分,不是后验概率,两个不同库里的同分,可信度并不等价。
本节要点回顾
- 比对:用相似度/距离量化"两段签名像不像",三种度量各配一种特征。
- 决策:分数对照阈值翻译成身份,阈值同时捏着误识与拒识两头。
- 平衡:等错率点是错放错拒的天然换位点,挑阈值=定立场。
- 1:N:大库靠向量索引粗召回再精排,质量管准、索引管快。
- 核心:模型管"像",阈值管"敢认"。
比对已经给出了"像谁、像到什么程度"的判决。可如果是张照片冒充本人,通向结论的路上还有最后一道闸——下一节的活体检测。