4.4 模型训练与优化
4.4 模型训练与优化
本节摘要:训练把人脸数据"烤成"能分人的网络。本节把训练流程拆成一串步骤——标准化预处理、主干与损失选择、优化器与学习率、训练技巧(初始化、批归一、早停、集成),以及模型压缩(剪枝、量化、知识蒸馏)——并给一个贴近实际的可复现流程,让你知道每一步在调什么、为什么。
一炉柴火:同一份数据,为何有人七成有人九成
按理说,把数据丢进去、跑几百轮、看损失下降,训练就完成了。可真正上手你会发现:同一份数据,有人收敛出 95%,有人只有 70%。差别几乎全在那些"训练细节"上——输入是 112 还是 224、批多大、学习率怎么衰减、要不要用预训练、过拟合怎么收。本节把这些最容易被新手当背景板的细节提到台面上逐条讲。
训练还有一条公理需要先立住:没有可复现基线,就没有优化。连"上次是怎么训出来的"都说不清,谈何改进。所以第一步永远是固定一个确定性的流程,参数、随机种子、数据版本都记下来。
训练流程一步步拆
预处理与标准化
送入网络前的脸要做检测对齐、统一尺寸(如 112×112)、像素归一化。这一环不达标,网络学到的全是对齐残差。特别注意:训练和线上要用同一套对齐模板与归一化参数,否则训练得很好、一部署就跑歪。
主干与损失
选一个主干(ResNet 深度大、MobileFaceNet 轻量),配第 3.4 节的损失(ArcFace 是现成的稳线)。这一步要在"精度"与"算力"之间找第一个平衡点——先定主干规模,再谈缩放到更轻。
优化器与学习率
优化器决定"往哪个方向大步走"。SGD 带动量稳妥、Adam 自适应好调;学习率的调度(阶梯衰减、余弦退火)决定能不能从远岸登顶。最常见的坑是学习率设太大导致发散、太小则原地踏步——先给一个偏小的默认值(如 0.01-0.1 量级配 SGD、更小的 Adam),用学习率热身慢慢加热往往更稳。
# 一个贴近实际的最小训练循环(示意图) for epoch in range(epochs): for images, labels in loader: feats = backbone(images) # 前向得嵌入 loss = arcface_loss(feats, labels) # 走 ArcFace 损失 loss.backward() # 反向求梯度 optim.step(); optim.zero_grad() # 更新参数、清梯度 if epoch % 5 == 0: lr *= 0.7 # 学习率阶梯衰减 print(epoch, loss.item())
训练技巧:防过热、防退化
几样常用技巧拼起来,能把"能训"推向"训得好":
- 迁移/预训练初始化:用 ImageNet 或人脸预训练主干起步,远稳于从零炼丹,小数据基本必走;Kaiming 初始化适合 ReLU 一类的激活。
- 批量归一(BN):稳定梯度、加速收敛,几乎是人脸主干的标配。
- Dropout 等正则:防过拟合,配合验证集观察。
- 早停:验证集不再涨就停,别靠硬加轮数硬凑。
- 评估节奏:每固定轮次在验证集上测一次 LFW/自建集,把"看着训练损失下来、实际却过拟合了"这类翻转尽早叫停。
压缩:给模型瘦身
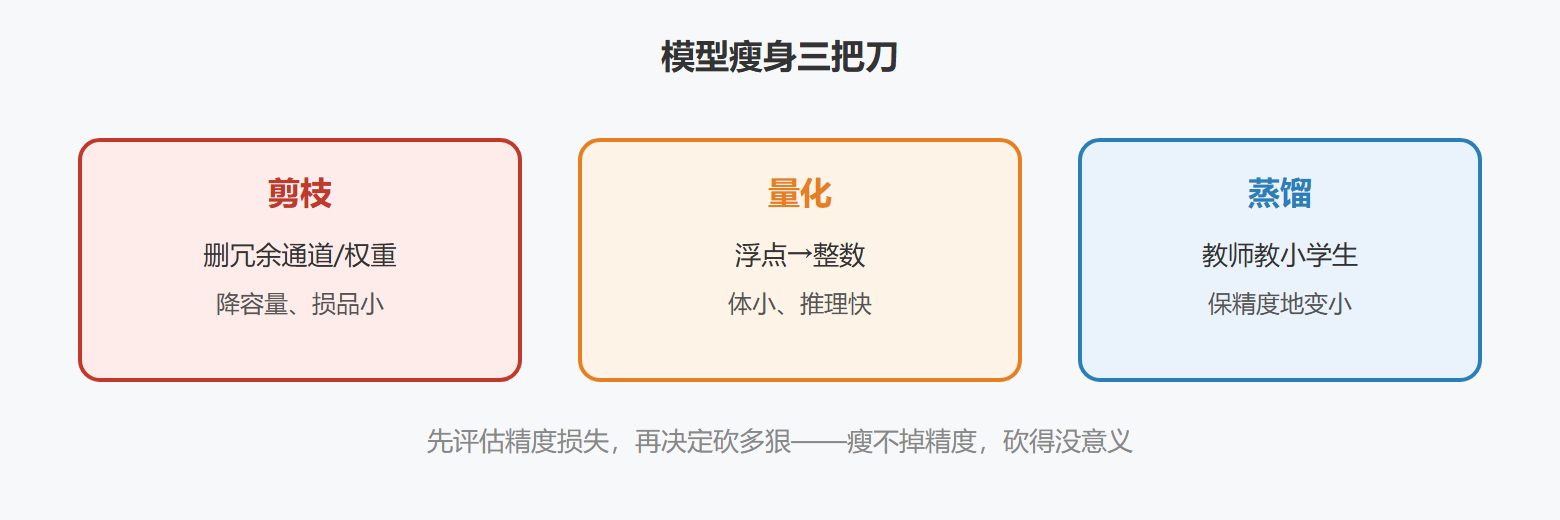
模型训好还要跑在受限硬件上,靠剪枝、量化、知识蒸馏三招瘦身:
- 剪枝:删掉次要的权重连接或通道,删冗余,精度损失不大。
- 量化:把浮点转整数,模型体积缩、推理加速,但要防精度跌——通常是先从 FP32 量化到 FP16/INT8 试试,精度掉了再评估要不要更保守。
- 知识蒸馏:用一个更大的教师模型"教"一个学生模型,后者复制前者的软标签,尽量保住精度又变小——先训教师,再训学生。
一张表:三种压缩
| 手段 | 删/改什么 | 主要收益 | 主要代价 |
|---|---|---|---|
| 剪枝 | 次要权重/通道 | 容量变小 | 精度可能小幅回落 |
| 量化 | 浮点转整数 | 体积小、推理快 | 精度易跌 |
| 知识蒸馏 | 小模型学大模型软标签 | 保持精度地变小 | 需先训教师模型 |
工程实践要点
- 迁移学习是省钱的主路,用预训练主干微调远稳于从零炼丹,小数据大概率必走。
- 过拟合的几个信号:训练损失很低、验证却不涨——先降容量或加正则,别硬加轮数。
- 压缩不是无脑降质:先跑精度损失评估再决定砍多狠,剪枝/量化/蒸馏常配合使用,总有一道适合你,但每动一步都要拿同阈值复测一遍。
- 别没先做模型可行性验证就一头扎进超参大扫荡。先把基线跑正(ArcFace+ResNet+合理学习率),再逐步加料,比盲目搜参高效得多——参数越多、自由度越大,越容易把噪声当信号。
一句话直觉:训练的美,在于每一步都在"稳收敛"。预处理、主干损失、学习率调度、防过拟合这些细节,共同决定你从一副普通牌里打出几成。
可复现基线:先锁定,再谈优化
训练最忌讳上来就四处调参。起步的正确姿态是:先把一整套固定配置钉死并写下——随机种子、数据版本、增强策略、批尺寸、优化器、学习率调度、主损失——跑出一条可复现的基线,再在这个基线上做单变量实验。没有基线,所有"调上去/调下来"都无从归因,你可能为噪声掏空精力。实践里强烈建议每次实验记录一个配置快照(种子+参数+数据 hash+验证集分数),让"上次那个更好的模型"永远能复现,而不是靠记忆碰运气。
过拟合的三种信号与对症下药
过拟合在人脸训练里很常见,学会认信号、对症下药最省力。信号一:训练损失很低、验证却不涨——先降模型容量(换小主干)或加正则;信号二:训练准确率极高、在少量验证样本上一错再错——多半是库太小或增强过度,补数据或压增强;信号三:验证集分数在某一轮后开始回落——这就是典型过拟合起点,配合早停在这个点停掉。核心口诀是"验证集说话":别被训练数字迷惑,一切以独立验证集上的 FRR/FAR 为准绳,然后再推敲容量、正则、数据三者的组合拳。
压缩三板斧的先后顺序
给模型瘦身,一般有个推荐顺序:先量化(成本最低、提速明显)看精度损益,若精度可接受就用量化交付;精度不达标再看剪枝,把冗余通道按贡献砍掉一部分;最后才考虑知识蒸馏这种"重武器"——它要先训一个大教师模型,投入最大,但往往能在保持精度的同时拿到最好的体积/精度折中。每一步压缩结束都要用同一套验证集、同一阈值复测 FRR/FAR,绝不只凭一个准确率拍板压缩前后谁能上。压缩不是无可奈何的妥协,而该是"在受限硬件上还能保住多少精度"的有意规划。
模型烤好了、也瘦身了,最后一公里是把它真正放到线上。下一节谈云端、边缘、移动端怎么部署、怎么切。