2.2 命名规范:从 cal_tot 到 calculateTotalPrice
2.2 命名规范:从 cal_tot 到 calculateTotalPrice
本节摘要:命名是代码可读性的基石。本节给出命名的六条通则(描述性、可发音、可搜索、无歧义、慎用缩写、长度适配作用域),划清四种主流命名风格的领地(小驼峰、大驼峰、蛇形、烤串),并为变量、常量、函数、类、布尔、集合、文件与数据库给出可直接执行的具体规则,最后点名拼音命名、误导性命名等高频陷阱。
核心问题
阅读完本节,你应当能够:
- 运用六条命名通则评估并改写一个不合格的标识符
- 为四种命名风格各说出典型的使用场景
- 按动词前缀体系为函数选择准确的名字
- 用 is、has、can 前缀为布尔值命名并说明为什么 flag 是坏名字
- 识别拼音命名、误导命名、类型冗余命名等陷阱并改正
一、问题与直觉:一个缩写引发的排查
一个真实故事:某团队有个函数叫 cal_tot,计算折后总价。半年后新同事看到调用处,以为它是"日历相关的总量统计",顺着调用链查了两个小时。而如果这个名字写成 calculateDiscountedTotal,两小时的误会会在两秒内消失。命名问题的残酷之处在于:写的人永远知道缩写是什么意思,所以永远不觉得有问题;痛的是读的人,而读的人恰恰没有发言权——代码已经写完了。
命名在代码里无处不在:变量、函数、类、参数、文件、目录、数据库表、配置项。每一个名字都是一次微型文档:写得好,读者零成本获取信息;写得差,读者付出一次查询甚至一次误读。更重要的是命名几乎不可逆地扩散——一个坏名字会被几十处调用复制,改名的成本随引用数增长。所以命名值得在写下的那一刻多花十秒钟。
命名还有一个容易被忽视的社交属性:可发音。代码评审、结对编程、故障复盘都在口头进行,一个发不出音的名字(比如无意义辅音堆砌的缩写)会让每次讨论都变成拼写比赛。能顺畅读出来的名字,才能被顺畅地讨论。
二、核心原理:通则、风格与具体规则
2.1 六条通则
- 描述性:名字要回答"装着什么"或"做什么"。
data、tmp、obj、doSomething是典型反例,customerRecord、temporaryBuffer、calculateTotalPrice是正例。 - 可发音:便于口头交流。评审会上说不出口的名字会持续制造沟通摩擦。
- 可搜索:名字要足够独特。搜
MAX_RETRIES一步命中;搜i、e会得到两千个无关结果。可搜索性在排查问题时直接决定效率。 - 无歧义:
db_conn是连接还是配置?mgr是经理还是管理器?歧义命名迫使读者去猜,猜错的代价是引入缺陷。 - 慎用缩写:只保留业界公认缩写(HTTP、URL、ID)。
usrInfo省了两个字符,输了所有人的时间。 - 长度适配作用域:作用域三行的循环变量可以叫
i;生命周期贯穿整个模块的变量必须用完整描述性名称。命名长度应与"读者需要记住它多久"成正比。
2.2 四种风格的领地
| 命名风格 | 形式 | 典型领地 | 示例 |
|---|---|---|---|
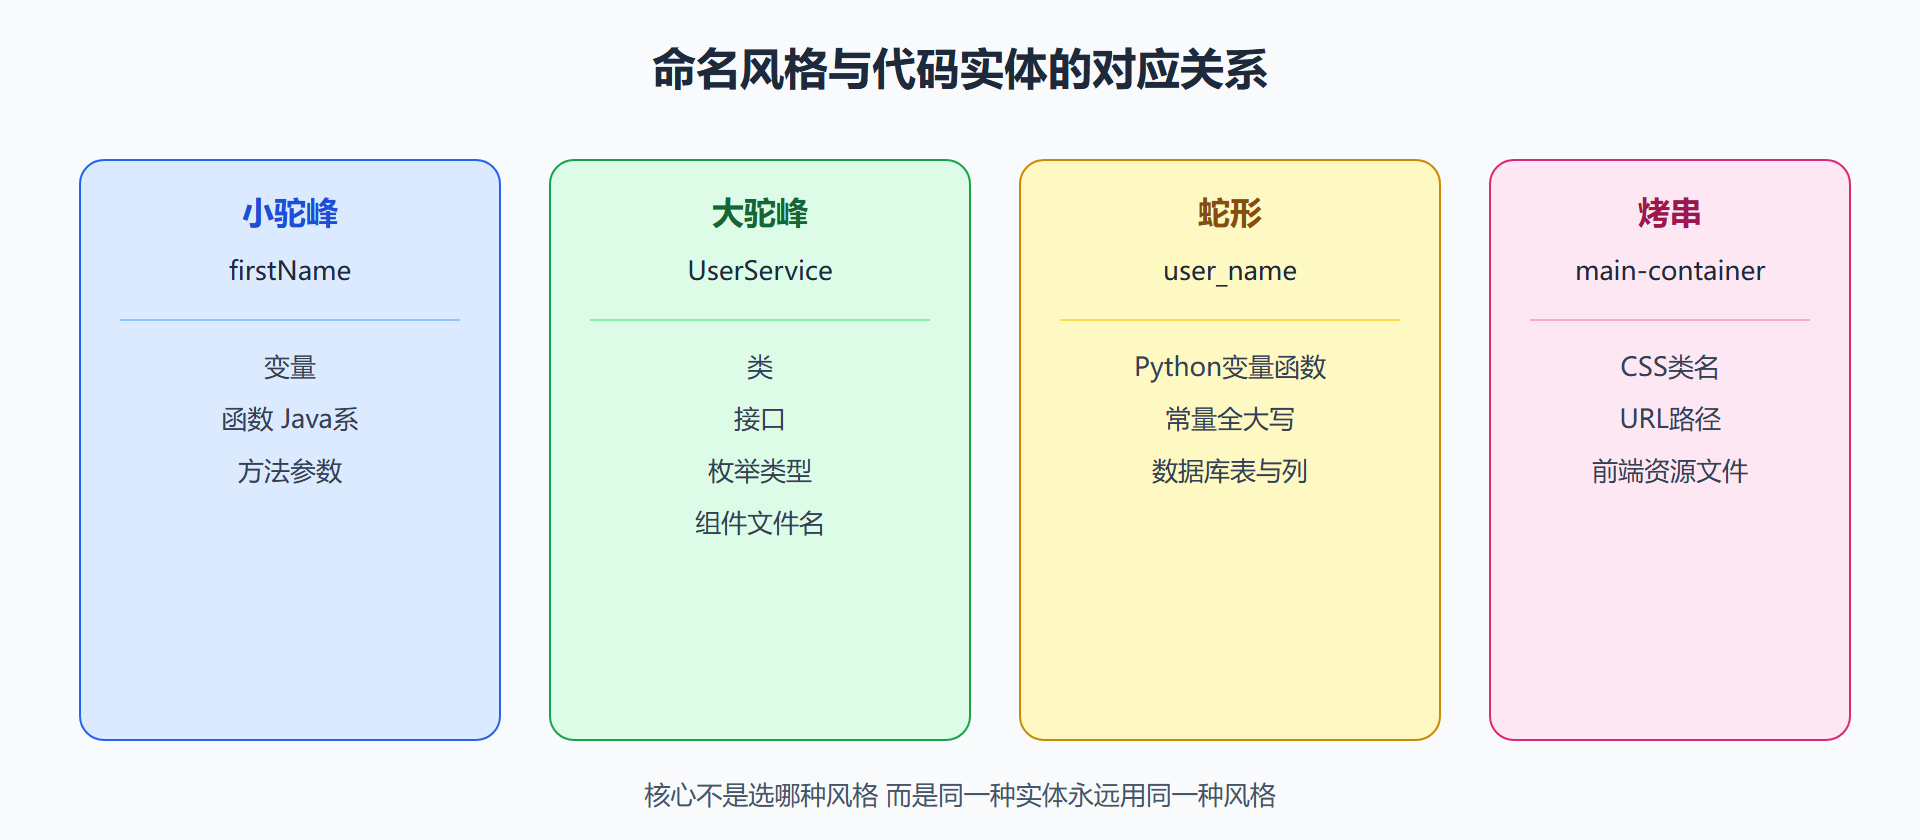
| 小驼峰 lowerCamelCase | 首词小写后续大写 | 变量、函数(Java 系语言) | firstName、getUserProfile |
| 大驼峰 PascalCase | 每词首字母大写 | 类、接口、枚举类型 | UserService、PaymentGateway |
| 蛇形 snake_case | 全小写下划线分隔 | 变量、函数(Python 系)、常量、数据库字段 | file_name、MAX_CONNECTIONS |
| 烤串 kebab-case | 全小写连字符分隔 | CSS 类、URL 路径、前端组件文件 | main-container、user-profile |
要点是领地意识:风格本身没有对错,错的是混用。读者看到大驼峰就知道是类型、看到全大写蛇形就知道是常量、看到 is 开头就知道是布尔——这种"望形知义"的条件反射,正是靠一致的风格训练出来的。还有一种匈牙利命名法(把类型编进名字,如 strName、iCount),在现代 IDE 悬浮即见类型的时代已无必要,且类型变化时要连名字一起改,一般不推荐。
2.3 各类实体的具体规则
变量:描述性加风格统一。布尔值加 is、has、can、should 前缀——isActive、hasPermission、canEdit 一眼可判;反面典型是 flag 和 status,读者无从知道该期待真还是假。集合用复数或类型后缀——users、productList、customerMap。
常量:全大写蛇形,体现"不可变"的郑重。MAX_RETRIES、DEFAULT_TIMEOUT、API_TIMEOUT。常量名与变量名的视觉区分,让读者立刻知道改它安全不安全。
函数与方法:动词开头,六组常用前缀构成一套"动词词汇表":
| 前缀 | 语义 | 示例 |
|---|---|---|
| get / fetch | 获取数据不改状态 | getUserInfo、fetchOrders |
| set | 设置数据 | setUserName |
| create / update / delete | 实体生命周期操作 | createOrder、deleteUser |
| calculate / compute | 计算并返回结果 | calculateTotalPrice |
| handle / process | 处理事件或流程 | handleClick、processData |
| is / has / can / should | 返回布尔判断 | isValidEmail、shouldRetry |
事件处理函数以 on 开头(onInputChange、onUserLogin)。这套词汇表的价值在于:调用者不用读函数体就能预期行为——看到 get 就知道无副作用,看到 is 就知道返回布尔。
类与接口:大驼峰加名词。类名通常是单数名词(User、OrderService、DatabaseConnector),表示一类实体或一项职责。接口命名各语言习惯不同:有的社区加 I 前缀,更现代的做法是直接用名词甚至形容词化(Runnable、Serializable 以能力命名)。
文件与目录:跟语言社区走——组件文件常用大驼峰或烤串,工具函数文件常用小驼峰或蛇形,配置文件常用烤串。目录名表达模块功能:auth、products、notifications。
数据库:蛇形命名。表名复数(users、order_items),列名单数描述含义(user_id、created_at)。
四种风格领地一览
三、工程实践要点:陷阱与执行
3.1 五个高频陷阱
- 拼音命名:
yonghuLiebiao(用户列表)。跨国团队无法阅读,拼音同音歧义多,一律改用英文。词汇量不是借口——查一次词典比留下一个终身谜语便宜。 - 误导性命名:函数叫
deleteUser实际只做软删除(标记无效)。名不副实比名字难懂更危险,因为读者会基于名字做出错误假设。应改为deactivateUser或markUserAsInactive。 - 类型冗余命名:
stringUserName、intUserAge。现代 IDE 悬浮即显类型,把类型编进名字是信息重复,类型重构时还会变成包袱(匈牙利命名法的教训同理)。 - 暴露实现细节:
arrayForStoringCustomers把数据结构写死在名字里,换成别的结构名字就错了。抽象一层叫customers即可。 - 否定式布尔:
isNotValid配合取非运算能绕晕任何人,一律用正向的isValid。
3.2 命名的执行机制
命名规范主观区间大,光靠文档约束力弱,建议三层执行:其一,评审必查项——评审人对命名的反馈往往最能让作者建立语感;其二,Linter 规则化——命名风格(驼峰还是蛇形、常量是否全大写)可以配置成静态检查规则,机器先行拦截(详见第 6 章);其三,示例库——在规范文档里维护一组"本团队的标准命名"正反例,比抽象原则更有传播力。
⚠️ 常见坑:评审时把命名批评表达成"这名字不好",引发无休止的口味之争。有效做法是对照规范说事实:"按我们的约定,布尔应以 is 开头,这个叫 flag 的变量建议改成 isEnabled"——规则在先,讨论就短。
💡 关键直觉:好的命名是一次性投资、终身分红。写的时候多花十秒,之后每次被读到都在省时间;而命名总量的复利,就是你整个代码库的可读性。
本章回顾
- 六条通则:描述性、可发音、可搜索、无歧义、慎用缩写、长度适配作用域
- 四种风格各有领地:小驼峰管变量函数、大驼峰管类型、蛇形管常量与数据库、烤串管样式与路径,混用是万恶之首
- 动词词汇表:get、set、create、calculate、handle、is 等前缀构成可预期的函数语义
- 布尔前缀:is、has、can、should 让真假一目了然,flag 与 status 是反面典型
- 五个陷阱:拼音命名、误导命名、类型冗余、暴露实现、否定式布尔
- 三层执行:评审必查、Linter 规则化、维护正反例示例库
下一节处理另一类日常争议:缩进、空格与大括号——以及为什么这些争论应该全部交给机器裁决。