4.1 错误处理与异常:别让程序静默失败
4.1 错误处理与异常:别让程序静默失败
本节摘要:错误处理规范的目标是让失败变得响亮、可定位、可处理。本节讲五条核心原则——尽早失败、区分错误与异常、不吞异常、信息充分、异常不用于控制流;给出标准异常与自定义异常的分工、捕获粒度与资源管理(最小 try 块、精确捕获、异常链、资源自动释放),以及配套的日志纪律。
你能学到什么
阅读完本节,你应当能够:
- 说明"尽早失败"为什么优于"带着错误继续跑"
- 区分错误与异常的概念并把握自定义异常的时机
- 识别空 catch 块与宽泛捕获的危害并改正
- 运用最小 try 块、精确捕获与异常链组织捕获代码
- 设计带上下文的错误信息与分级日志
一、问题与直觉:一个空 catch 块吃掉的事故
又一次深夜复盘。支付回调偶发失败,但日志里干干净净——没有任何报错。最后发现问题代码长这样(概念示意):
try: settle_payment(callback) except Exception: pass
写这段代码的人本意是"回调失败不能影响主流程",想法不算全错,做法是灾难:异常被吞掉,连一行日志都没留。程序表面健康地运行了几个月,实际每天悄悄丢掉一批支付结算,直到财务对账才发现。修复代价:核对数月流水、补偿用户、排查为什么没有痕迹。
这个案例揭示了错误处理的第一定律:失败的代码不可怕,安静的失败才可怕。异常机制的发明就是为了让错误"大声喊出来"——沿调用栈向上传播,直到有人处理或程序停止。空 catch 块相当于把警报器电池拔了:火灾照常发生,只是没人知道。正确姿势与错误姿势的区别不在于"要不要让程序继续跑",而在于继续跑之前有没有把失败记录下来、该补救的有没有补救。
二、核心原理:五条原则
2.1 原则一:尽早失败
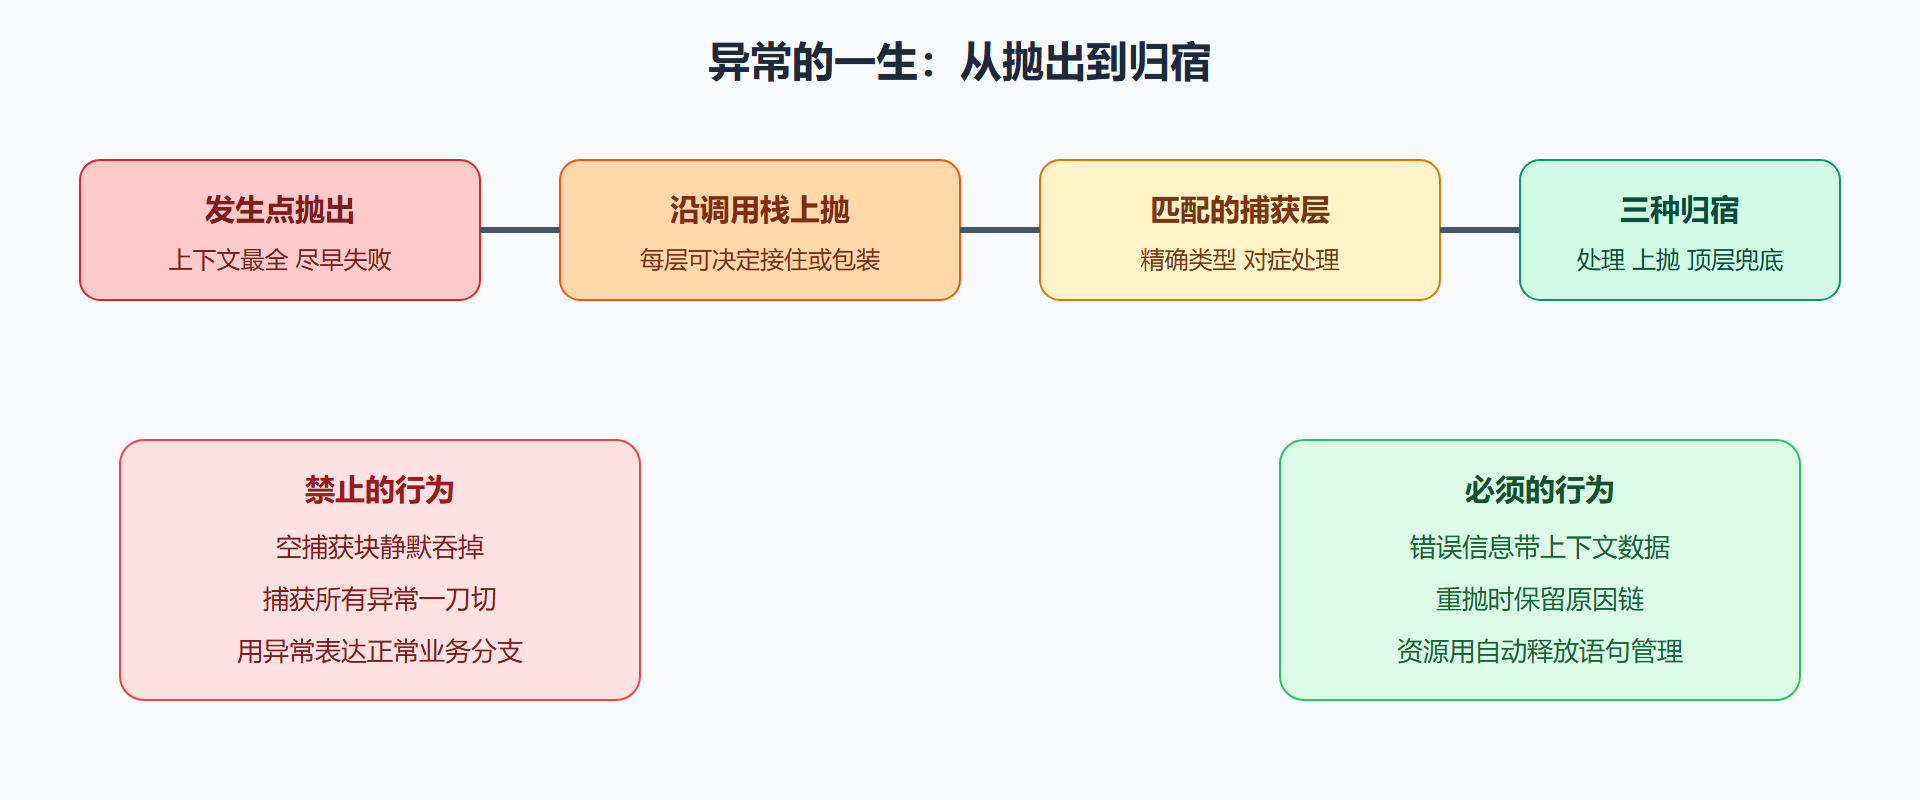
检测到错误条件时,在离发生点最近的位置立即抛出或返回,不要带病运行。理由是因果距离:错误在发生点抛出,上下文最全、原因最直白;往上层传三层之后,现场被后续计算污染,排查变成考古。第 3.3 节的卫语句就是尽早失败在函数入口的应用——参数非法立刻拒绝,不进入主逻辑。反面模式是"宽容输入":什么参数都默默接受,内部悄悄纠正,直到某个纠正不了的瞬间在离源头十万八千里的地方爆炸。
2.2 原则二:区分错误与异常
错误指程序无法恢复的严重问题(内存耗尽、栈溢出),通常交给运行时环境甚至操作系统处理,业务代码捕捉它们没有意义。异常指运行时可以被捕获处理的非预期事件(文件不存在、网络超时、输入非法)。规范关心的是后者。把两者混谈会导致两类笑话:给内存耗尽写 catch 块(接住了也做不了什么),或对网络超时不管不问(明明重试就能救)。
2.3 原则三:不吞异常
捕获之后只有两条合法出路:处理它(记日志、降级、重试、通知用户),或重新抛出(本层处理不了就包装后上抛)。默默忽略是最差选项。实在确认"这个异常可以安全忽略"的极少数场景(比如清理临时文件失败),也必须写注释说明为什么可以忽略——把判断依据留给未来的读者。
2.4 原则四:信息充分
错误信息是写给排查者的第一现场报告,合格信息包含:发生了什么(错误类型)、在哪发生(哪个模块哪个操作)、相关数据(参数值、资源标识)。对照:
# 差 排查者只能干瞪眼 raise Exception("出错了") # 好 类型明确 原因具体 上下文齐全 raise InvalidOrderError(f"订单 {order.id} 校验失败:收货地址为空")
2.5 原则五:异常不用于控制流
异常机制有真实开销(栈展开、对象构造),且用异常表达"正常业务分支"会让控制流隐式化——读代码看不出哪条路径走异常。规则:可预期的业务分支用返回值(如"用户不存在"返回空或结果对象),真正的异常状况用异常(如"数据库连不上")。边界判断:这件事在正常业务里每个星期都会发生吗?会,就是分支,不是异常。
异常生命周期与处理决策
三、工程实践要点
3.1 抛出侧:标准异常与自定义异常
优先使用语言内置的标准异常类型——参数非法用参数异常类、文件不存在用对应的 IO 异常类,读代码的人见名知意。当标准异常无法表达业务语义时再自定义,例如余额不足:
class InsufficientFundsError(RuntimeError): pass def withdraw(amount): if balance < amount: raise InsufficientFundsError(f"余额不足:当前 {balance},需 {amount}") ...
自定义异常必须继承合适的基类、名字以 Error 结尾、信息包含关键数据。好处在调用侧兑现:捕获方可以精确区分"余额不足该提示用户充值"与"数据库异常该报警",处理策略各异。
3.2 捕获侧:粒度与资源
最小 try 块:try 只包住真正可能抛异常的语句。try 块包了整个函数体,出了问题你不知道是哪一行,还会误捕无关代码的异常。精确捕获:按类型分别捕获,各有各的处理(概念代码):
try: content = read_config(path) except FileNotFoundError: log.warning("配置文件不存在 使用默认配置") content = DEFAULT_CONFIG except PermissionError: raise ConfigError(f"无权读取配置 {path} 请检查部署权限")
异常链:包装重抛时保留原始异常作为原因,让排查者能一路看到根因,而不是每层包装都把现场洗掉一层。资源管理:文件句柄、数据库连接必须保证异常路径下也释放——用语言提供的自动释放语句(资源随块结束自动关闭的机制),不要依赖手动收尾。
3.3 日志纪律
错误日志是排查的主战场。四条纪律:分级使用(调试、信息、警告、错误、严重各有语义,拿错误级记正常流程等于狼来了);带上下文(时间、请求标识、用户标识、关键参数,生产环境里没有上下文的报错几乎无法定位);不泄密(密码、密钥、卡号绝不进日志);与用户提示分离(给用户看的是友好文案,给工程师看的是完整日志,两份信息不能互相替代)。
⚠️ 常见坑:在循环里对每次失败都重试且日志全开,一次网络抖动产生几万条错误日志把磁盘打满,故障升级成事故。重试要有次数上限与退避策略,日志要有聚合与限流。
💡 关键直觉:设计错误处理时的自问句是"三个月后的深夜,这段失败能帮我多快定位问题"。每条原则——尽早失败、信息充分、保留原因链——都是在给未来那个深夜的自己留面包屑。
| 环节 | 规则 | 反模式 |
|---|---|---|
| 抛出 | 尽早失败 标准类型优先 自定义表业务语义 | 带病运行 宽容输入 |
| 信息 | 类型加原因加上下文数据 | 一句出错了 |
| 捕获 | 最小块 精确类型 对症处理 | 空 catch 捕获所有 |
| 重抛 | 包装并保留原因链 | 每层洗掉现场 |
| 资源 | 自动释放语句 | 手动收尾漏异常路径 |
| 日志 | 分级 带上下文 不泄密 | 错误级刷屏 无上下文 |
本章回顾
- 第一定律:安静的失败比失败本身可怕,空 catch 是拔掉警报器电池
- 尽早失败:错误在发生点抛出,上下文最全;带病运行制造考古式排查
- 两条出路:捕获后要么处理要么重抛,没有"默默忽略"这个选项
- 信息三要素:什么错、在哪里、相关数据
- 异常不做控制流:每周都发生的是业务分支,用返回值表达
- 捕获三件套:最小 try 块、精确类型、异常链保留现场
- 日志四纪律:分级、带上下文、不泄密、与用户提示分离
下一节看正常路径的纪律:如何让控制流保持扁平、让读者永远不迷路。