4.3 解调译码与接收链路总览
4.3 解调译码与接收链路总览
接收链的收尾:在修整好的星座上逐符号定夺归属(解调),再用信道编码的冗余把漏网的错误掰正(译码)。本节讲软判决如何比硬判决更值钱,最后把整张接收链路图"反向发射链 + 同步估计均衡"串成一体。
学习目标
阅读完本节,你应当能够:
- 说出解调(映射回比特)与译码(用冗余纠错)各在修什么,为什么软判决比硬判决赚。
- 定义对数似然比(LLR),解释它为何是软信息的标准载体。
- 把整张接收信号链按"下变频→同步→估计→均衡→解调→译码"的顺序复述并解释相互关系。
- 体会"发射端多讲究,接收端多省力"在本章收尾处如何落地。
一、硬与软:最后一道判断题
均衡把波形修干净后,摆在你面前的是星座图上一个大致的点,你要判它是哪个格位。两套判法:
- 硬判决:直接把点归到最近的星座点,输出确定性比特(0/1)。简单,但把"这个点离两格差不多远"的犹豫信息全丢了。
- 软判决:不急着定,把这个点对每个候选格位的"对数似然比"(LLR)原原本本递给译码器。LLR 正负给倾向,绝对值给信心。
信道译码(Turbo/LDPC 的置信传播)是吃"信心存量"的赢家:给它软信心,它能在迭代里把多份犹豫互相印证,从而多赚 2~3 dB。硬判决把这些信心提前扔了,等于把免费得来的增益倒掉。这就是工程里几乎咬定软判决的原因——代价只是多算一点 LLR,收益却是看得见的可靠性。
软判决的收益在迭代码里被放得最大。Turbo 码靠两个分量译码器来回互喂软信息,LDPC 靠稀疏校验图上的置信传播左右传递,两者每一次迭代都在重用"我不是很有把握"这类软证据,把看似无用的犹豫累积成可纠错的底气。若在源头就把软信息砍成硬比特,迭代就失去了可以交换的"货币",增益自然大幅缩水。所以"软判决 + 迭代译码"往往被当成一个整体设计,而不是两块独立的拼图——理解了这条,你就明白为什么 4G/5G 的接收端把这个环节做得这么重。
二、LLR 到手:软信息长什么样
对 BPSK,若映射 0→+1、1→-1,接收 y,噪声方差 σ²,其对数似然比对每个符号是:
L(y) = 2·y / σ²。
正负表倾向,|L| 说明多信几分。y 越靠 ±1、噪声越小,L 越绝。高阶 QAM 的 LLR 逐比特算,但要义一样——把连续的信心值交给下游,而不是切一刀硬说 0 还是 1。这份"软仗"的写法不复杂,一段最小复现就能看见硬判丢信息:
import numpy as np y = np.array([0.9, 0.4, -1.1, 1.2, 0.05]) # 接收样本(BPSK 下) var = 0.25 LLR = 2 * y / var # 软信息:带符号的信心 hard = np.sign(y) # 硬判决:只留符号 print("软信息 LLR:", np.round(LLR, 2)) print("硬判定: ", hard) print("丢掉的信心在 |LLR|:", np.round(np.abs(LLR), 2))
倒数第二个样本 y=0.05 的 LLR 很小——译码器看得出"这里几乎没把握";而硬判决照样硬说一个符号,这个"咬不准"就这么被吞掉了。软判决的全部价值,就是把这种"咬不准"透明地传下去。
LLR 的绝对值大小本身就是一条重要线索,不必非得先判出比特才能用:|L| 越大,表示这个点到格位的距离越悬殊、可信度越高;|L| 接近 0,则说明它正好悬在两格之间。译码器拿到这一串带刻度的信心后,可以借校验关系"交叉验证"——某一位信心虽弱,但与其相邻的若干位强确信能把它们联手掰正。这条"用确信去捞不确信"的机制,正是迭代译码从软信息里捞到额外增益的机理。
三、整条接收链:把发射链和信道一起收伏
把第 3、4 章放一张图,接收链的完整形态一目了然。
接收信号处理链总览
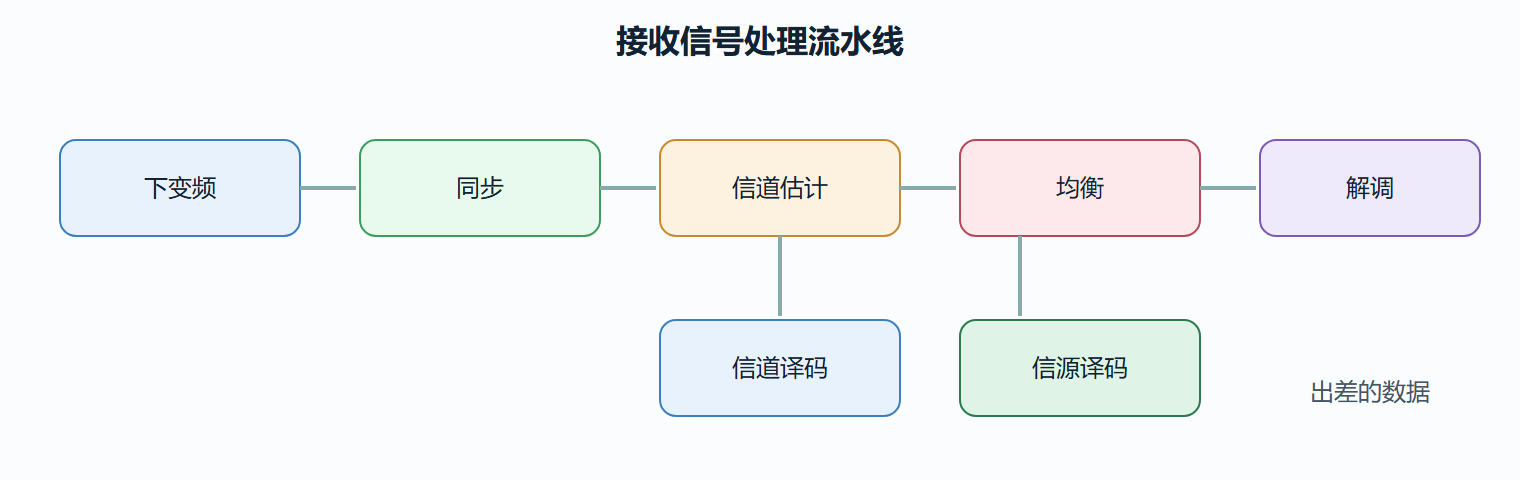
顺着箭头读:射频落地后先下变频回基带(第3.3章的逆运算),同步对表(4.1),估计与均衡把信道畸变除回去(4.2),再解调(本节的映射逆)、译码(纠错逆)直至还原。你会发现——发射端的每一步,接收端都以"逆运算 + 专门治信道"的方式接回来了。这正是本册"波形链路"主线的浓缩。
把这种"一收一防"的关系再压一层就能出结论:发射端的天花板决定波形能有多讲究,接收端的水平决定这些讲究能兑现多少。同步没咬准,后面均衡做再好也补不稳;估计没描细,均衡就补过头;均衡补过头,把星座洗得越干净其实越骗人;就算星座干净,软信息若没传到译码器,编码增益又折半。所以读取本节的正确姿势不是盯某一级的酷炫,而是把整条链看作一条"误差传导链"——前面任何一级省下的功夫,都可能被后面加倍讨回来。这正是接收端被做成信号处理密度最高工位的根本原因。
若想验证自己对整条链的感受是否到位,可以随手做一次"参数联调"的体检:试着只改一个导频密度,看从同步到译码整条的误码表现会怎样牵一发动全身;再单独加重某级噪声,看错误是从哪一级开始雪崩的。这种"对着整链问如果"的练习,比单记某级公式更能让你真正握得住接收机——它也顺带解释了为什么真实的接收机调试,往往要回到端到端、回到指标上去看,而不是死盯单一模块。这一整链的"软硬配合",正是接收机工程里最见功力的地方。
四、给实践者的收尾观察
- 软判决几乎永远是送分题:能用 LLR 就别丢成硬比特,2~3 dB 白送不要白不要。
- 译码之外还有信源译码:别把"还原出人话"误当成信道译码的终点,链路末端还有信源译码在收尾。
- 同步估均衡解调译码一环扣一环:前面的误差会层层放大到后面,所以关键参数(导频密度、环带宽)往往要联合调,不是各调各的。
本节要点回顾
- 解调映回比特,译码用冗余纠错,软判决(LLR)把信心传给译码器白赚增益。
- 软硬判决的分水岭,就在"要不要把咬不准的点透明地传下去"。
- 接收链是发射链的逆运算集,叠加同步估计均衡三件治信道新工具。
- 接收端软信息收益显著,工程默认走软。
- 前级误差会滚到后级,链路参数要联合校。
第4章给两条链路画了完整句号。第5章退一步,把这三、四章里反复用到的底层工具——滤波、频谱、采样量化、估计检测——整理成一本通用工具册,回来你会更通透。