5.5 MVCC让读不挡写
5.5 MVCC:多版本并发控制,让读不挡写
MVCC(多版本并发控制)的思路是:改变"读到最新值"就非要等写完成"的设定,给每份数据保留多个历史版本,让每个读事务去"看自己那个时刻该看的快照",于是读与写、读与读互不阻塞。本节讲清它凭什么不挡写、快照到底怎么取,以及它到了分布式里新增的两道题——全局版本号怎么发、没有全局钟怎么排可见性。
学习目标
阅读完本节,你应当能够:
- 解释 MVCC 为什么能"读不挡写":每个读看自己的快照版本。
- 描述一条数据的版本链是怎么被建立、推进与清理的。
- 说明分布式下 MVCC 的版本可见性为何比单机更难,举出一个典型解法。
先给"锁"找出个两难
想象一个订座系统,某天很多人同时看同一个热门座位。如果用最原始的"读也要锁",那一个读者在查座位时别的读者就得等着,系统吞吐断崖。做并发的人立刻遇到两难:想读得一致,就得拿锁,一拿锁就不让并行;想并行得快,就不能锁,可不锁读到的又是旧值/脏值。MVCC 就是为了破这个两难给出的答案——别用一个"最新值",给同一份数据留一串历史版本,每个读都去看"它该看的那一版"。这样读者之间、读与写之间都互不打扰。
一、版本链:数据不是一份,是一串
在 MVCC 里,每次写不是把旧值覆盖掉,而是在这份数据的"版本链"尾部追加一个新版本,每个版本带着"起始时间/版本号"和写它的事务 id。一个读事务进来,就拿着自己的事务 id/快照时间,沿版本链找到"我看到那一刻的最新一版」,然后就着那版读完整个事务——期间哪怕别的写事务又在后面追了几个新版本,也不影响这个读者。这正是"读不挡写"的微观来源。
版本链与可见性
二、快照怎么取、旧版本怎么清
每次读事务开始,给它分配一个"快照点",之后的可见性判断就变成一道简单题:只认版本号不大于我快照点、且由更早事务写入的版本,后面的新版本再热闹我也当看不见。这就把"读到的值"从"全库最新"变成"我时刻的合理值",既一致又不阻塞。
但版本不会永远留下去——否则链越来越长、磁盘爆炸。于是 MVCC 需要垃圾回收:当某个版本比起所有活跃事务的快照点都旧、再也没人需要它时,它就会被删除。分布式库干这件事尤其头疼,因为你还得先知道"哪个节点上还有活跃事务",跨节点一做,回收就变成分布式协调的活。这也是 MVCC 从单机搬到分布式后最常埋的坑。
版本可见性判断矩阵
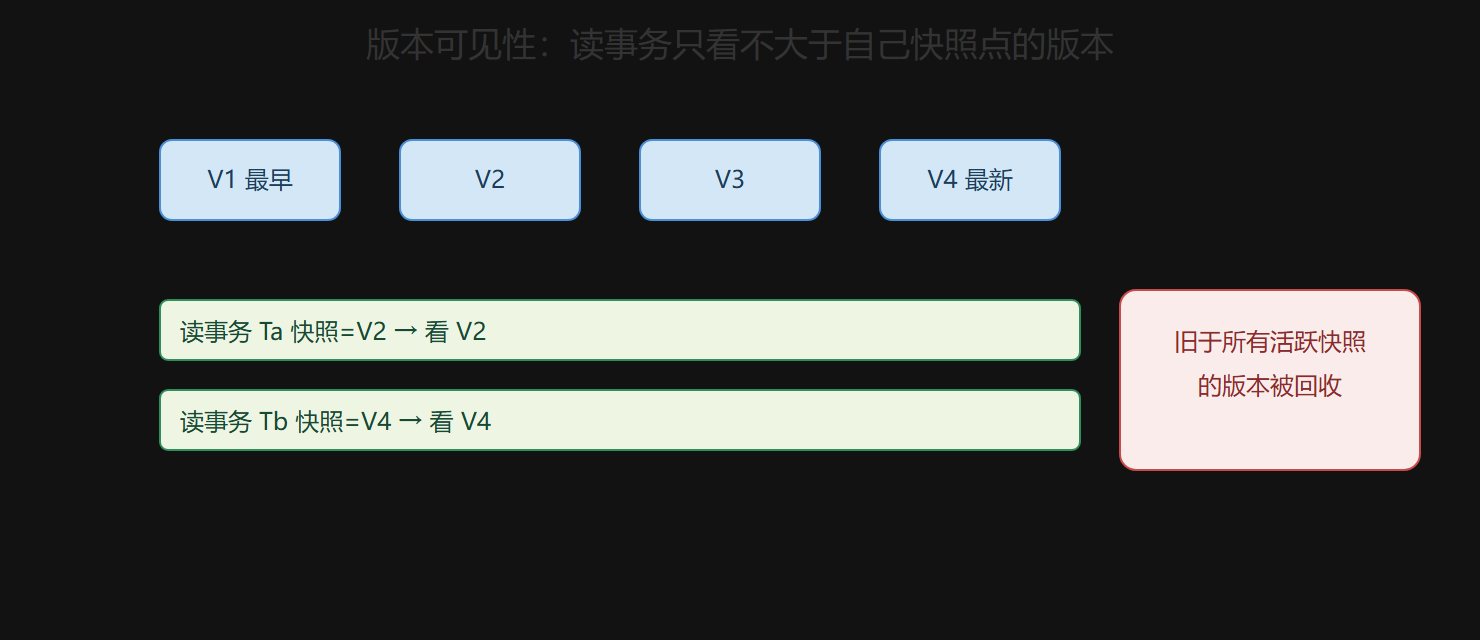
下面这张 SVG 用一张"事务对照版本"的网格,展示不同读事务各自看到哪一版、以及旧版本在什么情形下被当作垃圾回收:
MVCC 中每个读事务看向哪个版本
三、到分布式里:两个版本号难题
单机 MVCC 顺风顺水,是因为它有一个全局一致的时钟给你用来排版本。分布式一上新难题冒头:
难题一:全局版本号怎么发。 每个节点都写,就要一个"全站唯一且递增"的编号发生器,谁也别想发了重号。常见做法是让一个协调者或用一个时间戳服务统一发号,避免各节点各自用本地时钟发号造成编号错乱。
难题二:没有全局钟,可见性怎么判。 各节点的墙钟都有偏差,你怎么知道"T_a 该看到的版本"在 B 节点上究竟是哪一版?如果按天真的本地墙钟判,很可能出现"B 说版本已到 V5,而那其实是未来"的乌龙。业界主流解法是以协调者发的逻辑时钟/快照号为准,而不是拿各节点的物理时钟直接比——这就是为什么 MVCC 在分布式下往往伴随一套带全局快照机制的事务层。
单机与分布式 MVCC 的差别
| 环节 | 单机 MVCC | 分布式 MVCC |
|---|---|---|
| 版本号来源 | 本地时钟/序号 | 统一全局发号 |
| 可见性判定 | 本机时钟即可 | 要逻辑快照号,勿用物理墙钟 |
| 垃圾回收 | 本节点活跃事务 | 跨节点活跃事务协调 |
| 主要坑 | 版本链膨胀 | 全局时钟与跨节点回收 |
四、一个随手能算的可见性例子
把 MVCC 的可见性判断落到一组具体的版本号上,你就彻底不懵了。假设某条数据的版本链是 V1(事务 T1 写入)、V2(T3 写入)、V3(T5 写入),各带写入事务号与生效时间:
- 读事务 Ta,分配到快照点"看到 V2 为止":它沿链找到一个"版本号能让它看、且写入更早"的最新的那版,也就是 V2。哪怕之后 V3 才写的更新再热闹,Ta 全程只认 V2。
- 读事务 Tb,快照点更晚(看到 V3):它读到 V3,因为它是"Ta 之后才开、且 T3 已提交"的最新版。
- 关键点:Ta 读 V2 的整个过程中,T3 甚至 T5 的写可以持续推进、把 V3 追加进来,但 Ta 丝毫不受影响——这就是"读不挡写"的微观机制。
| 读事务 | 快照点 | 选中的版本 | 触发机制 |
|---|---|---|---|
| Ta | 早 | V2 | 版本号不大于快照点的最新版 |
| Tb | 晚 | V3 | 同一个判断,只是快照点更靠后 |
等所有活跃事务的快照点都超过 V2 之后,V2 就成了"无人再看的老版本",被垃圾回收清掉。把这一套顺下来,你就掌握了 MVCC"读它该读的、不断被新写打扰"的全部逻辑,也能顺手推理为什么 MVCC 在往下读的并发里几乎不阻塞。
这套"读它该读的、不被打扰"的逻辑,细想其实和你在文档软件里看到的"版本历史/快照恢复"是同一件事——只是被数据库用事务 id 与快照点做成了每秒成百上千次并发的利器。只要理解到这一层,你就明白 MVCC 不是什么炫技特效,而是"给每一次读配一帧它该看的时刻"这套朴素思想,在"读多写少、热点高并发"场景下的工程落地。值得顺手记住:MVCC 换来的"Isolation"是大多数数据库默认隔离级别(可重复读/读已提交)的底层支撑,它在偷偷决定你每一次 select 看见的是什么。
本节要点回顾
- MVCC 的立身:给数据留多版本,读看快照,互不阻塞。
- 版本链:写追加新版本,读按快照点挑一版看完全事务。
- 垃圾回收:老于所有活跃快照的版本周期清理,防链膨胀。
- 分布式两大难题:全局版本号怎么发、无全局钟时可见性怎么判。
一致性、事务、并发隔离在这一章都见过了,可它们背后都默认了一件事——"大家得听同一个世界的时序"。可如果节点之间连"谁先谁后"都互相说服不了,事务就无从谈起。这正是第 6 章要正面回答的共识问题:Paxos、Raft、Quorum,怎么让一群机器就"对"达成一致。