6.4 拜占庭容错与故障恢复
6.4 拜占庭容错与故障恢复
前面讨论的故障都是"节点崩了"——你只要把它当作不再说话就行。可世界上还有更坏的故障:节点被攻破、被恶意替换、甚至主动撒谎。这类"会撒谎的节点"对应的是拜占庭容错(BFT)问题,要靠更苛刻的票数配比才能对付。本节还回头把更常见的崩溃容错的另一半讲完:故障怎么被检测、节点挂了副本怎么重建自愈。
学习目标
阅读完本节,你应当能够:
- 区分"崩溃故障"与"拜占庭故障"在信任模型上的差别。
- 说出经典拜占庭容错所需的节点配比,并说明它为何如此昂贵。
- 描述故障检测(心跳/租约)与副本重建的完整步骤。
故障也分"品行":崩溃 vs 撒谎
入门者常默认"节点挂了就是不再响应",这假设了所有节点都忠诚、只是会死。可现实中还有一种更险恶的情况:节点被攻破、被黑客操控、数据被篡改、甚至主动给你返回假数据。前者叫崩溃容错(只管机器死没死),后者叫拜占庭容错(还得防机器撒没撒谎)。这一节我们先看"会死"的怎么治,再看"会撒谎"的怎么治,最后落在运维每天都在做的检测与自愈上。
一、崩溃容错:多数认可就够了
前面 Raft、Quorum 能用一个简单的"多数组件"达成一致,全靠一个隐藏假设——节点要么正常、要么安静地死掉,绝不会乱说话。在这个前提下,"多数"就够兜故障了:N 个副本里只要活着且同意的超过半数,共识就能推进,剩下的挂了也没关系。这是现代分布式库的默认工作模式,也正是它相对便宜的原因。
二、拜占庭容错:得防说谎的
但一旦假设换掉——允许有节点撒谎、篡改、和稀泥,情况立刻变糟。因为一个坏节点假装成多数,就能把假数据洗成"大家都同意"。想让系统在存在 f 个拜占庭节点的前提下还稳,经典结论是:节点总数 N 必须满足 N 大于等于 3f 加 1。也就是至少容许三分之一的节点做坏事。这笔账算下来代价极大:每容忍一个坏节点,就要多准备三台真使,通信复杂度也水涨船高。这也是为什么拜占庭容错(去中心化程度极高的场景,比如区块链、跨机构联盟链)才会价值连城,而普通单方可信的数据库集群几乎用不上它。
崩溃容错与拜占庭容错的门槛对照
三、故障怎么被发现:心跳与租约
比"怎么容"更靠前的问题是"怎么知道它挂了"。分布式惯用两件套:心跳——每台节点周期性给对方发"我还活着"的信号,某节点超时没收到就该警惕;租约(lease)——给一个身份(比如 leader)发一个带有效期的凭证,过了期没续,就自动视为失效,这能在网络抖动与真故障之间划出较可靠的边界。租约的好处是能避免"你以为它还在,其实已失联"导致的重复领导与脑裂。
四、发现之后怎么自愈
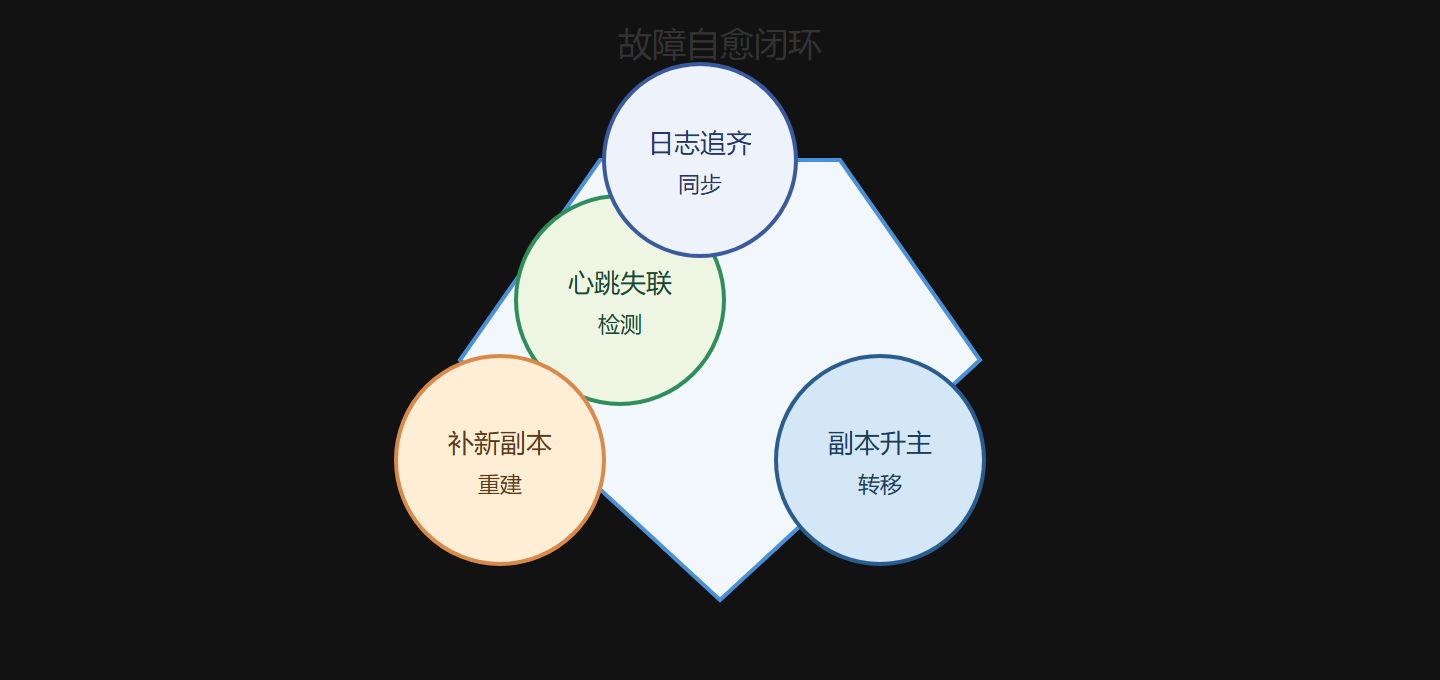
检测到节点故障后,闭环的下一步是重建:第一步把故障节点的流量与数据职责转移到它留下的副本(选一台升为主);第二步在健康节点之间补出新的副本,使其回到"多数活着"的容忍区间;第三步通过日志或快照把新副本的数据追齐。这套"检测→转移→补副本→追齐"就是数据库高可用的日常,也是从第 3 章"副本保可用"到这一刻才真正落地。
下面这张 SVG 概括"检测与自愈"的四步闭环:
故障检测与自愈闭环
五、别一上来就想拜占庭:先把崩溃吞下
新手读到这里容易犯走极端的错,觉得"要容错就得上拜占庭那套贵的"。现实恰恰相反:99% 的业务集群,你要应付的只是崩溃容错这一档——因为你的节点由你自己管理、有信任边界、顶多宕机掉电,不会被黑客攻破来给你回假数据。拜占庭容错的天价配比(N 要 3f+1),只在"参与方彼此不信任、谁都不能说了算"的去中心化场景(区块链共识、跨机构联盟链、多方可信记账)才值回票价。所以工程选型的正确顺序是先自问一句"我的节点彼此可信吗"——答案可不行,就走便宜耐用的崩溃容错(Raft/Quorum 那套);只在多机构互不信任时,才咬牙上 BFT。这个顺序能帮你把有限的精力花在最能落地的罐子里,而不是被"更高级"的算法带偏。
六、一张"检测与自愈"现场清单
把"怎么发现"和"怎么修"落到日常,拼成一张可用清单,轮值守群的时候照着做:一、心跳周期与超时阈值调得对不对——太短会误杀正常节点、太长会拖慢故障感知,通常先按网络 RTT 的几倍起步;二、租约是不是真的在续约——检查有没有"过期未续却被当成仍在"的窗口,这正是脑裂的来源;三、故障转移有没有自动触发——主节点如果几百毫秒内没自动选新主,多半配置有漏;四、补副本与数据追齐有没有走后门——新副本是不是通过日志/快照增量补齐,而非整库重建。把这四条挂进监测大盘,你就从"读了概念"走到了"能真正扛得住节点挂掉"这一层,为接触真实分布式运维铺好了地基。
七、把选型落到一条一句话上:要不要 BFT
BFT 的门槛极高,绝大多数业务场景真的犯不上:如果你能拿到集群里每台机器的控制权、能保证没人能塞进来恶意节点篡改数据,崩溃容错那套(Paxos/Raft/Quorum)就够了,而且简单便宜、容错能力满足绝大多数业务需求。只有当你面对"多方互不信任、节点被攻破后会故意撒谎"这种分布式信任场景时,才咬牙咬出代价上 BFT——别为了"更高级"硬上,BFT 那套 N 要 3f+1 的代价,每多容一个坏节点就要多买两台新机器,这笔账不到真需要别付。
本节要点回顾
- 两种故障品行:崩溃容错(管死)vs 拜占庭容错(管撒谎)。
- 拜占庭门槛:N 需 3f+1,容错极贵,多用于高去中心化场景。
- 检测两件套:心跳保活、租约划失效边界、防脑裂。
- 自愈闭环:检测 → 转移 → 补副本 → 日志追齐。
机器就"对"达成一致、故障也学会了自愈,接下来注意力该挪到"在一致且可用的前提下,怎么把查询做得更快"了。第 7 章分布式查询优化,把上几章攒下的地基,用在"跨节点快速查出结果"这最后一步上。