7.3 分布式 Join 如何省钱
7.3 分布式 Join 策略:谁往谁那儿搬,搬多少
联表查询把两张表按某个键拼起来,单机里一眼就看懂的操,到了分布式就要先解决"两张表住在不同的节点、键却得对上"。本节讲清三种策略——Broadcast 广播小表、Shuffle 重分两张表、Colocation 同驻预排——各自什么时候最省钱,以及那句选型直觉:让数据搬得少的那套,往往就是对的。
学习目标
阅读完本节,你应当能够:
- 描述 Broadcast、Shuffle、Colocation 三种 Join 各自的数据搬运方向。
- 说出三种策略各自的适用前提(表大小、是否同驻)。
- 做一次判断:给定两表的大小和分区方式,选最省钱的策略。
联表查在分布式里有多"内耗"
单机库里一条 join 说出去轻巧。可你一旦把它放大到"订单表在节点 1、用户表在节点 2",立马撞上难题:订单要按用户 id 和用户表对上,可两表根本不住一起。 想要 join,就必须让这对数据在某个地方重逢——跨越零个或多个网络来回。而怎么让它们重逢最省钱,就是本节三种策略要在背后比的账。判业绩就一句话:搬得越少越省,选型对准"谁小、谁被哪个键分区"。
一、Broadcast Join:把小的那半边复制到所有节点
当两张表一张大一张小时,很多系统选择 Broadcast:把那张小表复制(广播)到每一个参与 Join 的节点,让每台都能在本地拿"大表本片 + 完整小表"来做本地 join,最后把各自结果上报归并。小表只有几千行,广播一次的成本微乎其微,却把"跨节点碰对"变成了"本地 join"。代价是广播需要小表小到能塞进每个节点,否则广播本身就变成灾难。
二、Shuffle Join:把两边都按连接键重新聚分
当两表都大、又没法同驻时,只好 Shuffle:根据连接键(比如 user_id)把两张表各自重新分区,让"连接键相同的数据"被汇聚到同一组节点,再在每组内做本地 join。它把"全网随机配对"变成"分组内本地配对",能并行地摊在多个节点做,代价是一次不小的重分区搬运——两张表都要按 key 全部重新倒腾一遍,网络成本可观。
三种策略的搬运方向
三、Colocation Join:让连接键一开始就住一起
最高明的省法不是"搬得聪明",而是压根不用搬——Colocation。它要求把两张要常联表的数据,按同一个连接键放在同一个分片。这样 join 从一开始就发生在本地,无需任何跨节点搬运。代价不在这条 SQL,而在建库设计:你得想清楚哪些表会高频联表、让它们共用分片键。能 colocate 的都 colocate,动不动就不必到 Shuffle 去搬两遍。
四、三种策略怎么选,一表看清
选型最终落到"谁小、谁被哪个键分片、能不能同驻"三问上:
| 策略 | 搬运方向 | 适用前提 | 代价 |
|---|---|---|---|
| Broadcast | 小表复制到所有节点 | 小表足够小 | 广播成本 |
| Shuffle | 两表按连接键重分区 | 两表都大且无法同驻 | 一次全网重分区 |
| Colocation | 无需搬运 | 连接键同驻同片 | 建库时要设计好分片键 |
一个经验判断:优先想 Colocation(能同驻就别搬),其次想能不能 Broadcast 掉更小的那半边(能用小表当局部凭据就别整表重分),实在不行才轮到 Shuffle(准备好那笔全网重分区的账)。
四、一张真实案例的快速选型:订单表 join 用户表
实战中拿不准时,把这张表往题上一套立刻有结论。假设你有一张 1 亿行的订单表(按用户 id 分片),一张 1 万行的用户表:
- 用户表只有 1 万行,足够小——Broadcast Join:把小用户表广播到每个节点,节点上订单表和用户表本地 join,选它最省。
- 如果订单表和用户表都已经千万级、而且都按用户 id 分片好了——Colocation Join,直接本地 join 不用搬,选它最优。
- 如果两张表都是亿级、分别按不同键分片,也没法 colocate——Shuffle Join,只好两边都按用户 id 重分区,各走各的,虽然搬一次,总比把整张亿级表广播到所有节点省。
这一套走下来,你选的策略基本就是最优的。所以选型的时候,别一开始就想着 Shuffle,多往"能不能不搬、能不能少搬"上想,这就是分布式 Join 最省钱的心法。
三种策略的搬运量一图看穿
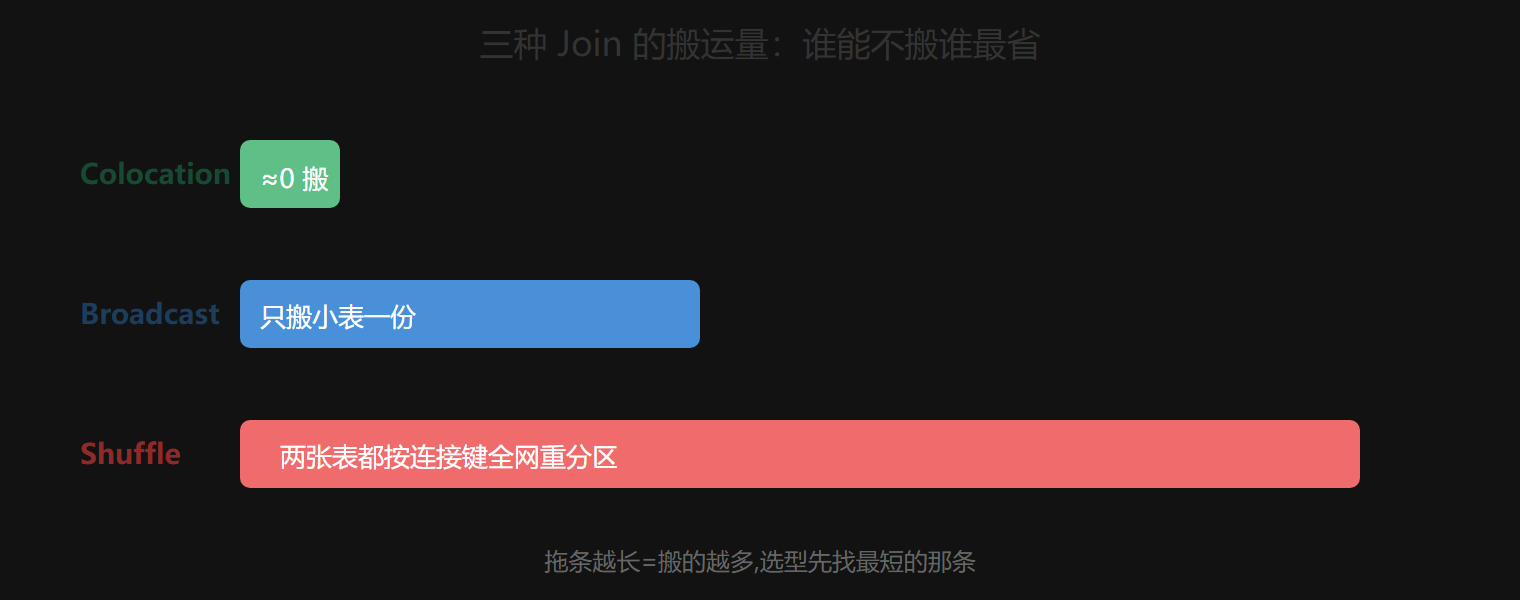
五、一句给建库者的忠告:选型提前到分片那天
上面这套选型口诀(Colocation > Broadcast > Shuffle)看起来只是"选哪招",但一批真正有效的库里,这个选择往往早在建库决定分片键那天就被判了死刑——因为能不能 colocate、能不能 broadcast,取决于你当初让哪两张表共用同一根分片键。所以给正在做库设计的人一句实在话:在定分片键时,就把"哪几组表会高频联表、要不要共用一根键"当成一条硬约束考虑进去。 与其等 join 上线后想尽办法省网络,不如一开始就让它们同驻——这是全册里最划算、也最省心的"从源头少搬"。记住:好的 join 不是"选出来的",而是"设计出来的"。
本节要点回顾
- 三种策略:Broadcast 抄小表、Shuffle 折两表、Colocation 免搬运。
- 省的是传输:分布式 Join 比的从来不是 CPU,而是搬了多少。
- 选型三问:谁小、谁按哪个键分区、能不能同驻。
- 优先级:Colocation > Broadcast > Shuffle。
Join 的省钱功夫到这就够了,原理、优化、共识、事务也在前几章备齐。最后该用真实产品把这些攒下的知识串起来了。第 8 章走进 NewSQL、NoSQL、云原生与 OLAP 的世界,看看哪一套是真适合你手上那个业务的。