3.3 环境准备与测试数据管理
本节摘要:集成测试的真依赖是把双刃剑——环境要可控、数据要干净、隔离要彻底。本节讲清"内存库还是容器"、"数据如何初始化与清理"两条主线,给出一套能落地的生命周期模板。
真依赖的两副面孔
上一节说集成测试愿意用真东西,但真东西一多,麻烦就跟着来:真实数据库在 CI 里装了没有?测试之间要不要共用一个库?跑完的数据谁清理?这三件事管不住,你的集成测试就会三天两头因环境闪红,然后被团队当成需要"排除"的噪声。所以环境与数据的管理,实质是在真实性与可重复之间修一条稳定的轨道。
环境第一问:这台库住哪
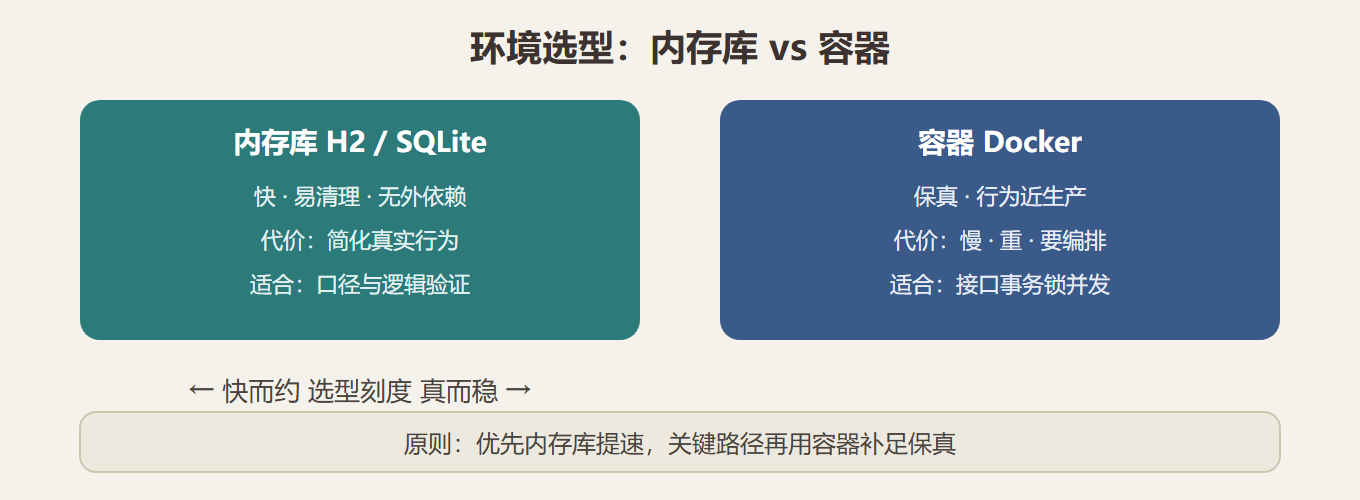
两个主流答案,按需取舍。
内存数据库,如用 H2、SQLite 这样的进程内实现来充当数据库。优点是启动快、清理容易、零外部依赖,CI 里开着就能跑。缺点是它过度简化了真实数据库的怪脾气——索引、锁、并发表现和生产未必一致。它适合"主要想验证 SQL 与逻辑口径"的场景。
容器,典型做法是用 Docker 起真实的数据库、消息队列、缓存服务。优点是环境保真,几乎和生产一致,能发现只在真实实现里露出的怪问题;缺点是启动慢、要编排资源、CI 里更重。它适合"接口、事务、并发、锁这些行为和实现绑定"的场景。
数据第二问:初始化与清理的生命周期
测试数据不干净,是闪红和互相污染的头号元凶。两条铁律:跑前重置到已知状态,跑后清干净自己搞脏的。下面这两个工具函数演示了最小生命周期。
def setup_known_state(db): db.reset_all() # 每次回到同样的出发点 seed_client(uid=1, level="gold") seed_client(uid=2, level="guest") def teardown_clean(db): db.tables("client_level").truncate() # 只清本用例碰过的表
跑测试时,每个用例在同一个干净的出发点起跑,结束后把头绪理干净,绝不把脏数据留给邻居用例。要做到"每个用例可复跑、顺序无关",这是最低要求。
一个生命周期模板
给集成测试套固定节奏,能大幅减少环境噪声:
- 开局:连接测试库,
reset_all确保空仓。 - 播种:按用例标注的最小数据集初始化。
- 执行:跑断言。
- 复核:确认断言通过。
- 收尾:truncate 本用例涉及的表,或直接销毁内存库。
数据生成上,超出"硬编码两条"的数量后,别手工维护一车 fixture,改用数据工厂或随机播种工具按规则批量生成,并把生成规则集中在一个地方,方便日后改口径只改一处。
隔离到什么程度
环境隔离的目的是"脏交互最小化"。常见做法有:集成测试用专属独立数据库/独立 schema,别和研发的本地库混用;不同团队或不同 PR 的 CI 用互相独立的测试库;必要时加锁或排队,避免并发跑 CI 时互相踩。说到底,隔离不是奢侈,是让"红灯可信"的地基。
数据也别只会"造假",造假要造得像
前面建议用数据工厂批量生成数据,但工厂造出来的"规整数据"有一个隐患:太干净、太理想,反而暴露不了真实脏数据才会踩的坑。比如真实账目里常见的落单数据、历史遗留的 null 字段、乱序的时间戳,这些"丑数据"恰恰是集成层最容易翻车的地方。所以成熟的做法是**"规整数据 + 一条丑数据样本"双管齐下**。
丑数据样本怎么来?最省力的来源是生产环境的脱敏快照——拿一段真实的表数据,脱掉敏感字段后缓存下来,每次都喂给统一的集成用例。它的好处是真实、会跟随现实演化;代价是要维护一套脱敏与同步的流程,且快照会膨胀、需要定期压缩。若一时拿不到真实快照,就退而求其次,在数据工厂里"重点丑化"几个高风险字段——例如故意把金额字段塞 null、把状态列塞进不合法枚举,让用例在这些变异上也有守卫。
数据版本与用例版本要对齐
环境数据还有一个容易被忽视的维度:版本。真实数据库有迁移(migration),字段会随版本演进。若用例断言的是旧字段口径,而库已经迁到新版本,集成用例就会因为"数据版本"而误红。建议在套件层面记录"数据 schema 版本"并与用例断言绑定,每次跑前确认"用例期待的版本 == 库的当前版本",不一致时给出明确提示而不是莫名翻红。这条看似费事,却在库迁移频繁的项目里能省下大量"明明什么都没改怎么红了"的排查时间。
让环境"配得起"这件事也能自动跑
环境搭建老是靠人肉反复点击,是很多集成套件孱弱的根源。更稳妥的方向是把环境配置也写成代码、纳入版本管理:数据库的建表迁移、初始化的种子脚本、容器的编排定义,都落到仓库里,让"拉一个新环境"变成一个命令就能完成的事,而不是一段口口相传的配置说明。别小看这一步,它直接把"我这边跑不起来,多半是环境问题"这类日常甩锅从根上消除。
真要这么干,记得三件事:一是把"建环境"和"卸环境"成对写成脚本,既能拉起也能干净地拆掉,防止残留污染;二是把环境的版本(镜像 tag、schema 版本)直接锁在仓库声明里,而不是靠各自记忆;三是首倡"新成员克隆后一条命令能起测试环境"作为验收——起得来,环境才配叫"可复现"。做到这三点,集成测试的环境才从"看人脸色"变成"随取随用"。
数据要"够用",不要"够多"
配测试数据还有个常见的跑偏:为了显得全面,恨不得把库里每个字段种一遍,结果一次集成测试要拉起万千行数据,又慢又难定位。正确的量级是**"够用"而不"够多"**——只种被测那条路径真实依赖的最少状态,能用三条绝不用三百条。这样既能让用例聚焦、又能把任何一个"该红的接缝"暴露得更明确。真需要大体积数据验证的性能场景,单独归到慢档,别让"造大库"拖垮日常轮次。数据瘦身是集成用例随手可做的一件小事,累积起来的提速却相当可观。
本节要点回顾
- 环境二选一:内存库提速、容器保真,关键路径补足保真。
- 数据两铁律:跑前重置、跑后清理,才能顺序无关可复跑。
- 生命周期模板:开局重置→播种→执行→复核→收尾五步。
- 数据用工厂生成:超过手工条数就集中到数据工厂统一口径。
- 隔离是地基:专属库/schema,别让并发 CI 互相污染。