4.2 如何选择:用哪盏灯暖哪一段
本节摘要:落到具体业务,选层不是拍脑袋。本节给出一套"离外部世界距离 + 风险尖点"两步判定法,外加一张选择矩阵,帮你把一段需求分到单元层或集成层,并讲清灰色地带怎么兜底。
别再问"这段算单元还是集成"
最没效率的争论,是给一段代码贴一个非此即彼的标签。正确姿势是按风险分层出钱:说话算话的标准不是"它现在是不是单元",而是"这段逻辑被改坏的可能性和代价有多大、要怎样才能最快的灯照到它"。下面两步,帮你把标签之争降维成成本账。
第一步:量一下它离外部世界多近
距离越近,越可能需要真依赖,也越该往集成层放。给一段被测逻辑量量,下面的任一项命中,就先把"单元层"的选项打上问号:
- 直接读写数据库或文件;
- 直接发起网络调用或订阅消息队列;
- 依赖真实时钟、随机量、全局状态;
- 需要真实进程间交互(锁、socket、共享内存)。
什么都没命中、纯内存能闭环的,优先归单元层——它便宜、快、能高频跑。
第二步:找风险尖点
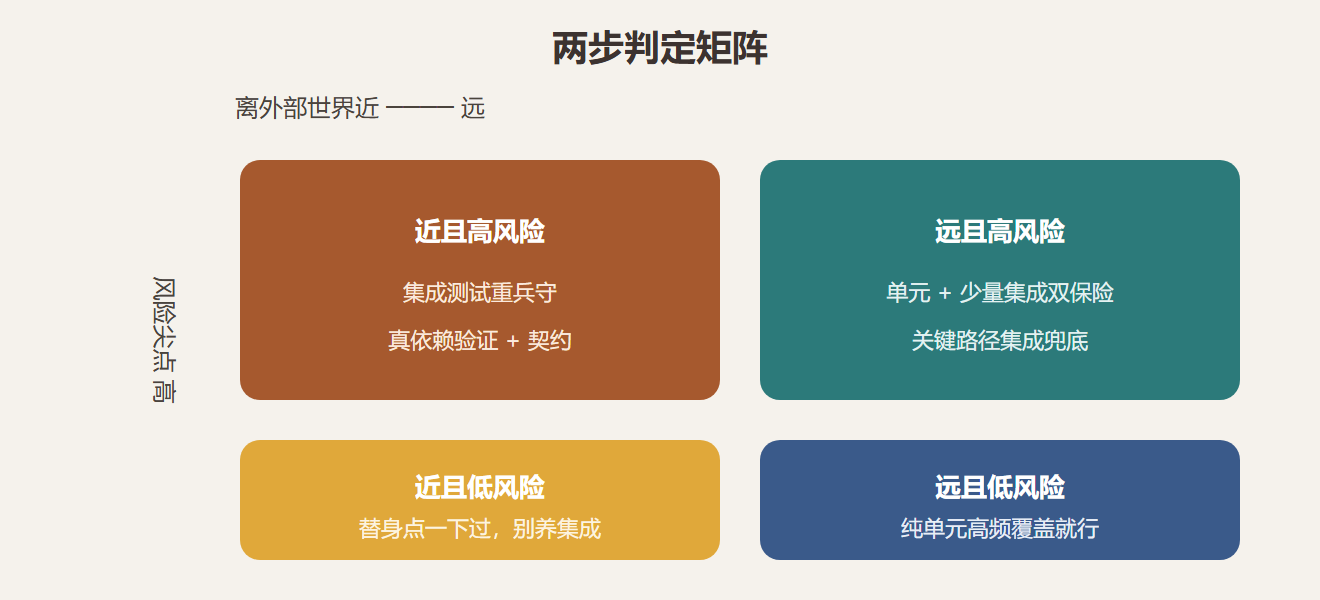
距离之外,还要看"风险尖点"在哪。风险尖点=最容易被改坏、或改坏后代价最重的那条路径。它常常是金额、权限、状态机、对外契约这类"两头都得对"的地方。风险尖点处哪怕离外部不算太远,也值得花一次集成测试的钱去锁死——你要的是"真依赖下的真相",而不是替身下的安慰。
下面这张矩阵帮你两两组合落地方案。
一个实例走到落地
背景:结算系统新增促销叠加功能,同时牵扯价格计算(纯内存)和读促销配置(数据库)。
操作:价格计算部分按"远且低风险"处理,写纯单元用例把叠加优先级测干净;促销配置读库这段按"近且高风险"处理,走集成测试真读配置树验证口径。
结果:改价格规则时单元层秒回红灯,改配置字段时集成层抓出口径漂移,两者互补不重复。
解读:同一功能的两个片段被分到两层,不是因为它俩长得不同,而是它俩离外部距离和风险等级不同。变式:灰色地带可先用集成测试兜一发,若连续数月从未亮红、又明显拖慢整体,再考虑下放到更轻的层。
关于「先写哪个」的小结
现代团队多按"改到哪段就补哪段"的路子,而不是中规中矩地单元先行再集成。这个顺序在实践中更务实:改动先撞单元层拿到最快要的快照(配合 TDD,见第 5 章),等接缝涉及真依赖时,再补集成用例收口。先快后慢、先宽后窄,挡在前面的是廉。
灰色地带的三条兜底法则
"离外部近不近 + 风险高不高"两轴答完,仍会有不少段落在中间游移,这正是最容易吵架的地方。给三条约俗成,帮你在灰色地带快速落锤:
- 宁误编一层,不两头空:与其让这段逻辑两边都不管、谁测都不兜底,不如先给它一个明确的归属;等多了证据再改判,比持续悬空好。
- 风险锚定优先级:两可时优先照顾风险尖点——能给集成加一道保险就加,代价只在开发者被慢反馈磨一下;而漏掉高风险接缝的代价,是线上事故与你无关的上线后爆发。
- 用"历史红灯"说话:那段曾被哪一层真拦过真实回归,就默认继续待在那一层。附一条实测经验:凡某段逻辑在过去一个季度被集成用例拦过真实缺陷,就把它定性为集成常驻,别轻易下放。
这三条不是教条,而是把"两可"从每换个人都重吵一遍,转成"有默认值、可更新"的仓库共识。
一张少数但关键的"外包/自建"避坑
选层过程中还有一类常被忽略的情况:当一段逻辑要接的外部能力既充当依赖又充当功能边界(比如第三方支付、外部身份认证),选择单元还是集成会直接牵扯"要不要替身、替身够不够真"。这种情况下除了看距离和风险,还要多看一条——这个外部能力是不是你惹得起的"活的"。你若控制不了它何时改版,就在集成层用真依赖盯着;你若只是偶发调用它、又无高风险,就用替身隔在单元层省维护费。这里的取舍同样回归那句成本账:把验证押在"你控制得住"的地方,比押在"你控制不住"的地方划算得多。
有一种"被迫选层"更要提前防
上面都是一段逻辑主动去排层,但实际操作里有一种更被动的场景:历史包袱逼着你只能用某层。比如一段关键逻辑被埋在一块谁也拆不动的老代码里、依赖全部写死,此时"理论上该走集成"的结论,实践里可能既插不进替身、也拉不起真环境。对这种"想归层却归不动"的段落,正确姿势不是硬拗,而是先记账:明确它在排层矩阵里的真实位置、记录"当前约等于哪一层的假真相",放进重构或技术债清单,等有机会拆出来时再归到该归的层。
这种"记账而不硬拗"的分寸很重要。好高骛远地现在就要把每一段都归到"理论上该在的层",往往会逼出一堆临时替身和假绿灯,反而拖垮你真心想守住的那几段。卡住的老逻辑先认命再图谋,比假装已经分层到位更诚实,也更省力。
选层是一次「连续校准」,不是"定完就完"
还有一层容易被忽略:选层不是一次性的决定,而是跟着代码演化不断回看的连续校准。一个函数今天纯内存、归单元层很顺;半年后它为了性能接进了缓存、又连了库,性质就从"纯单元"滑向了"半集成"。若还在用半年前的选层结论糊弄,等于守着过期的地图走。所以我建议给"选层回看"也排个节奏:每当一段逻辑发生"引入外部依赖 / 性能改造 / 拆分重构"这三类变化之一时,就顺手把它在矩阵里的位置重算一遍,别让旧标签继续罩着新代码。
这条习惯跟第 1.1 节"分层测试的一条坏账规律"同一底子——成本跟着缠住的标签复利堆积,越早重算越省。摊这么一点回看的成本,换来的是"分层判断永远贴着代码的当前真相",几十行的工夫远低于一次误判带去的排期事故。
一句好记的选择口诀
落到日常,与其事到临头翻矩阵,不如记一句顺手的选择口诀:"能闭门算的走单元,要真出门的走集成,又忙又险的加一层"。"能闭门算的"是纯内存、离外部世界远,单元层又快又省;"要真出门的"是踩着磁盘、网络、时钟,借口再多也归集成层;"又忙又险的"是高风险尖点,值得在真依赖下多罩一层。这句话足够在大多数场景里帮你三十秒拍板,矩阵和两步法留给你想严谨核对的时候用。
本节要点回顾
- 别贴标签:按"离外部距离 + 风险尖点"分层出钱。
- 两步判定:先量距离再找风险尖点。
- 矩阵落地:近高风险集成重兵,远低风险单元高频。
- 功能可拆分到层:同一功能不同片段各归各层。
- 先快后慢:改动先撞廉的层,接缝再收集成这一发。
选层定了,4.3 把两层合成一条分层防线,看它们如何互补而不互相浪费。