1.3 数据库基础
1.3 数据库基础
本节摘要:后端离不开数据库。本节讲清数据库的角色(持久化存储)、关系型与非关系型的区别、基本概念(表、行、字段、主键)、以及后端如何与数据库交互(SQL、ORM)。
你能学到什么
阅读完本节,你应当能够:
- 解释数据库的角色
- 区分关系型与非关系型
- 掌握基本概念
- 理解 SQL 与 ORM
- 认识三框架的数据访问方式
一、问题与直觉
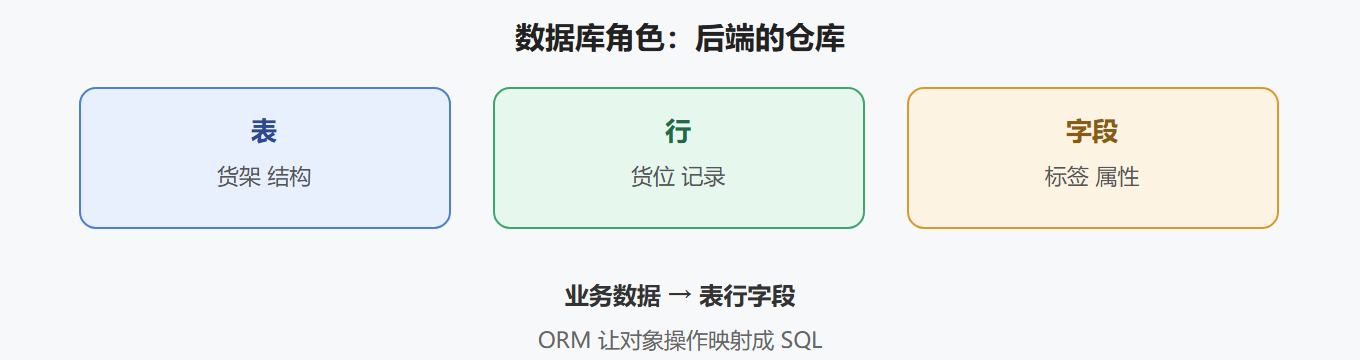
"数据存哪?"——内存会丢,文件难查,数据库是答案。把数据库想成一个"有规矩的仓库":有货架(表)、有货位(行)、有标签(字段),用统一的"取货单"(SQL)来存取。后端的所有数据问题,最后都落在数据库上。
二、核心原理
2.1 关系型与非关系型
| 类型 | 结构 | 代表 | 场景 |
|---|---|---|---|
| 关系型 | 表格(严格结构) | MySQL、PostgreSQL | 业务数据 |
| 非关系型 | 文档(灵活结构) | MongoDB | 灵活数据 |
💡 关键直觉:关系型像"表格账本",非关系型像"自由笔记"——业务数据要严谨用关系型,灵活场景用非关系型。多数入门项目从关系型开始。
2.2 基本概念
2.3 SQL 与 ORM
- SQL:直接写查询语句操作数据库
- ORM:用代码对象映射数据库表,自动生成 SQL
三、工程实践要点
3.1 后端与数据库的交互
请求进来 → 业务逻辑 → 数据层(SQL/ORM)→ 数据库 返回结果 ← 数据返回 ← 查询结果
3.2 三框架的数据访问
| 框架 | 常用方式 |
|---|---|
| Spring Boot | JPA/MyBatis(ORM) |
| Django | Django ORM |
| Node.js | 原生驱动/ORM |
⚠️ 常见坑:在代码里拼 SQL 字符串(SQL 注入风险)。用框架的 ORM 或参数化查询,别手拼——安全与省心兼得。
3.3 入门建议
先会建表、增删改查(CRUD) 再用 ORM 简化操作 最后学设计(外键、索引)
核心回顾
- 要点一:数据库是"有规矩的仓库"
- 要点二:关系型像账本,非关系型像笔记
- 要点三:表、行、字段、主键是基础概念
- 要点四:SQL 直接查,ORM 对象化
- 要点五:别手拼 SQL,防注入
- 要点六:先 CRUD 再设计
数据会管了,下一节接通前后端——API 设计与交互。
常见疑问
Q1:关系型数据库为什么叫"关系型"?
因为它基于"关系模型"——数据组织成一张张有行列结构的二维表,表之间通过相同的字段(键)建立关联。一个"关系"就是一张表,表里的"关系"靠主键外键来维护。这套模型的好处是结构严谨、查询灵活,用 SQL 一个语句就能完成跨表统计。绝大多数业务系统的核心数据(订单、账户、用户)都存在关系型数据库里。
Q2:ORM 是怎么"替我们写 SQL"的?
ORM 做的事情是:你写一个类(对应一张表)、类属性(对应列),框架在运行时把"对象操作"翻译成 SQL。比如你调用"保存这个对象",框架自动生成一条 INSERT;你调用"按条件查",框架生成 SELECT。好处是少写很多样板 SQL、类型安全、换数据库时改动小;代价是复杂查询不如手写 SQL 灵活,性能也不一定能写出最优。所以实践中的原则是:常规增删改查用 ORM,复杂统计直接写 SQL。
Q3:后端和数据库之间隔了几层?
以典型 Web 应用为例:控制器 → 服务层 → 数据访问层(ORM)→ 数据库驱动 → 数据库服务器。中间每一层都有职责:控制器收请求,服务层写业务规则,数据访问层负责把对象映射成 SQL,驱动负责和数据库服务器通信。理解这条链路,排错时就能按层定位:接口报错先看控制器参数对不对,数据不对再看服务层逻辑,连接超时再看数据库本身。
Q4:什么是 SQL 注入?为什么拼 SQL 字符串会出事?
SQL 注入是攻击者把 SQL 片段混进你的查询条件,改变查询语义。比如你把用户输入直接拼进"WHERE name = '用户输入'",输入里带上引号和特殊字符,就可能把原来的查询变成"删除表"或其他危险操作。防范方法就是参数化查询:把用户输入当作"值"传给数据库,而不是拼进"语句"里。ORM 默认就是参数化的,这也是推荐用 ORM 的原因之一。
工程实践要点
动手建议:装一个最简单的 SQLite 或 MySQL,建一张表(比如用户表),插入几行数据,再用命令行或图形工具执行几条查询。重点体验三件事:第一,写一条增删改查的 SQL;第二,观察表结构和数据的关系;第三,体会"主键唯一标识一行"意味着什么。这些基础体验会直接帮助你理解后面三个框架各自的数据访问层是怎么工作的。