1.1 预测任务怎么切分
1.1 预测任务怎么切分
本节摘要:时间序列预测是按时间顺序用历史观测估计未来数值。真正要先切的不是模型,而是任务:序列由趋势、季节、周期、残差组成;输出可以是单步或多步、一个点或一条区间。切错任务,后面所有对照都对不上业务决策。
学习目标
阅读完本节,你应当能够:
- 用加法或乘法分解读一条业务曲线,指出哪一段是季节、哪一段是残差
- 区分单步、迭代多步、直接多输出三种 horizon 策略
- 说明点预测和区间预测分别回答什么业务问题
- 给自己的项目填一张任务切分卡,而不是直接写“用 LSTM”
一、一条曲线里其实有四件事
港口调度室墙上的集装箱吞吐量日曲线,看起来是“一个数随时间在变”。SOURCE 把它拆成四块:趋势是长期方向,季节是固定日历周期(周、月、年),周期是长度不固定的起伏(经济景气),残差是解释不掉的随机波动。深度学习后面再强,也是在这四块上做文章,不会凭空多出第五种物理量。
加法模型把四块相加,适合波动幅度不随水平变大的序列;乘法模型把四块相乘,适合“水平越高、季节摆幅越大”的序列。SOURCE 提醒:乘法情形常先取对数,转回加法再建模。我更倾向先画一张按周对齐的小倍数图:若旺季波峰随年度均值抬升而变高,乘法优先;若波峰高度几乎不变,加法即可。
冷库温度是另一类例子。设定值附近的小抖动多半是残差;开关门造成的日内起伏是季节;压缩机老化导致的缓慢漂移是趋势。把这三类混成一个“预测温度”的黑盒,模型会把季节学成趋势,或者把残差当成可预报信号。
观测 Y ├─ 趋势 T 长期升/降/走平 ├─ 季节 S 固定周期,可对齐日历 ├─ 周期 C 长度不固定 └─ 残差 R 解释不掉的部分 加法:Y = T + S + R 乘法:Y = T × S × R
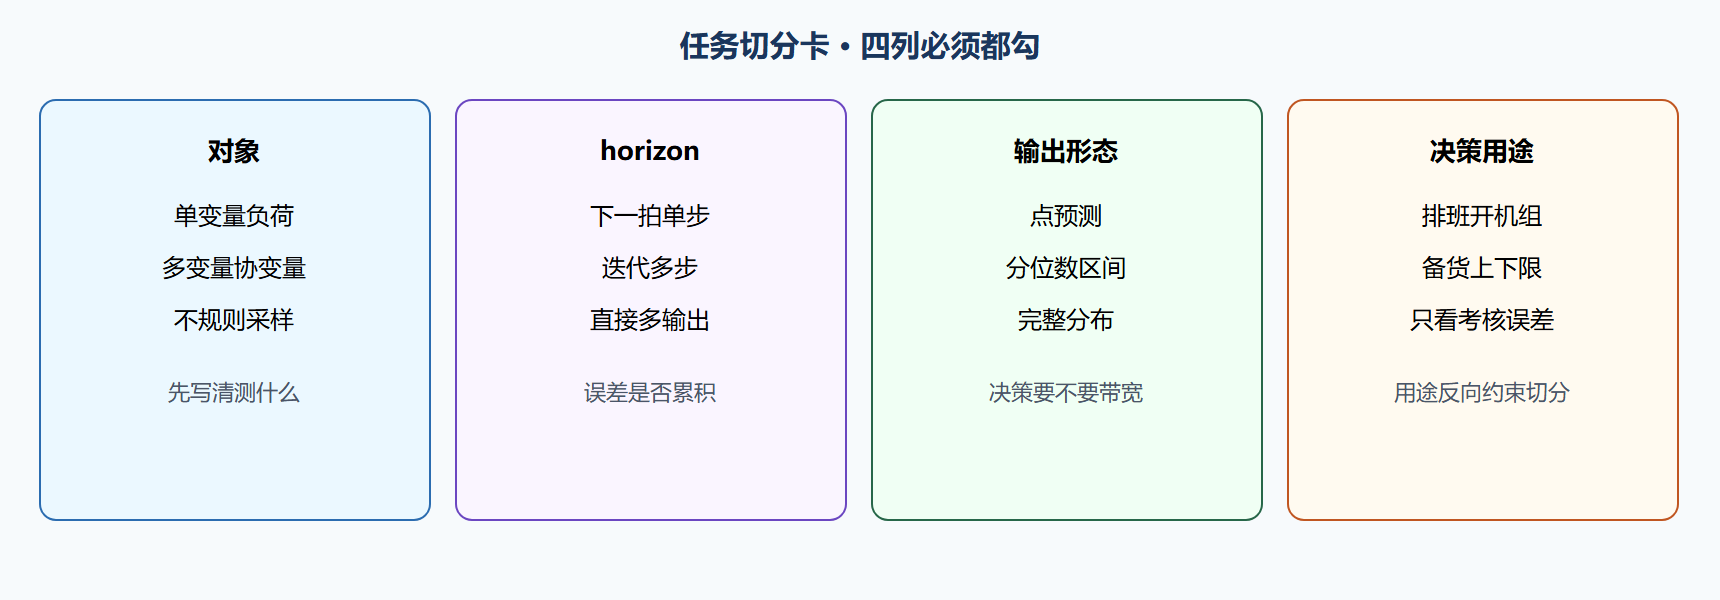
图 任务切分卡:先勾选项再谈网络
二、horizon:单步、迭代、一次吐出整段
SOURCE 把预测任务分成单步和多步。单步只估下一个时间步,误差不会滚进下一步的输入。公交到站间隔若只需要“下一班大概几分钟”,单步足够。变电站若要排出未来 96 个 15 分钟点,那就是多步。
多步里又有三条路。迭代(SOURCE 称 Recursive)每次只走一步,把预测值塞回输入再走下一步:实现简单,误差累积是硬伤。直接多输出(Multi-Output)一次吐出未来整段:没有滚雪球,但模型要同时学多个 horizon,短 horizon 和长 horizon 可能互相扯皮。混合策略把前几步直接出、后面迭代,或分段直接出,是工程上常见的折中。
我倾向:horizon 不超过输入窗口的四分之一时,优先直接多输出;更长再考虑分段或混合。迭代只在“必须用已经训好的单步模型、不能重训”时才作为权宜。
| 策略 | 误差行为 | 训练成本 | 适用直觉 |
|---|---|---|---|
| 单步 | 不累积 | 最低 | 下一拍决策 |
| 迭代多步 | 逐步放大 | 低,复用单步模型 | 权宜、短 horizon |
| 直接多输出 | 各步独立拟合 | 头更大 | 固定长度轨迹 |
| 混合 | 前段稳、后段漂 | 中 | 长轨迹又不能重训多次 |
概念上,直接多输出只是把最后一层从“一个数”改成“一段向量”,并不神秘:
输入窗口: x[t-L+1] ... x[t] 单步输出: y_hat[t+1] 多输出: y_hat[t+1] ... y_hat[t+H] 迭代: y_hat[t+1] 再作为输入去估 y_hat[t+2]
三、点还是区间,问的是两种决策
点预测给一个数,区间预测给范围或分布。SOURCE 把后者叫 Interval / Probabilistic。调度开备用机组,关心的是“晚高峰会不会超过上限”,一个点不够;仓库备安全库存,关心的是上分位数,不是均值。若考核指标写的是 RMSE,点预测与考核对齐,硬上区间只会让报表难看。
点预测常用 MSE/MAE;区间常用分位数损失(后文第 5、6 章会对照)。不要把点预测的残差标准差事后画成“置信带”就宣称做了不确定性量化——那只是同方差假设下的装饰,遇到波动率随时间变的序列会骗人。
时间序列预测的重要性,SOURCE 列了决策支持、资源优化、风险管理、性能评估、自动化。落到切分卡上:决策支持往往要区间;资源优化可能只要点;风险管理必须要带宽;拿预测当新策略基线时,先保证划分不泄漏(第 5 章),否则基线本身是假的。
⚠️ 常见坑:把多步任务训成单步,上线再用迭代滚 96 步。验证集上看起来 RMSE 很低,那是单步的分;滚到第 40 步,负荷曲线会漂出物理范围。
💡 关键直觉:horizon 和输出形态是产品需求,不是模型能力等级。Transformer 也可以只做单步点预测;ARIMA 也可以出预测区间。
问题:不规则采样算不算时间序列?
算。SOURCE 写明数据点可以在固定或不固定间隔上观测。公交到站、船舶靠泊就是不规则的。深度侧后面会用到注意力或图网络来迁就不规则;统计侧往往先重采样到规则网格。切分卡上要单独勾“是否规则”,这决定预处理走哪条路。
问题:周期和季节有什么差别?
季节对齐日历,长度固定;周期长度不固定,例如几年一次的景气。深度模型两者都会吃进非线性里,不会自动帮你标注名字。若业务要解释“这是春节效应还是景气循环”,仍需要分解或外生日历特征,不能指望网络自己开口。
四、三张业务表:同一套切分词,不同落点
把切分卡填到具体业务上,比背定义有用。下面三张是示意,数字不是实测。
变电站 15 分钟负荷、日前要 96 点、考核常见 RMSE,备用决策却看晚高峰会不会顶上限。对象是单变量加气温协变量;horizon 是多步固定 96;输出形态口头说点、心里要区间。切分卡一旦这样填,后面就不能只用单步 LSTM 的验证分去投标。季节是日双峰加工作日/周末,周期是缓慢用电结构变化,残差含高温尖峰。加法还是乘法:高峰随年负荷水平抬升时偏乘法,先对数再建模是 SOURCE 写过的路。
港口日吞吐量、要未来两周泊位计划。班期是已知未来,台风是稀疏事件。horizon 14 对日序列不算短,迭代会把班期误差滚大。更合理的是前 3 日直接多输出、后面用班期加季节朴素。点预测够排计划草稿,真正占泊位的安全余量仍要上分位。这里周期(景气)和季节(周班期)必须分开勾,否则网络会把景气当星期学。
冷库分钟温度、只要下一拍是否越限报警。单步点或单步上分位即可。趋势是压缩机老化,季节是开门造成的日内起伏,残差是控制抖动。这种题上 Transformer 是错轴。切分卡填完应显示:统计或浅层网络,区间只要一条上尾。
问题:切分卡能不能中途改?
能,而且应该改。产品从“看一眼明天”变成“自动排 96 点”时,horizon 轴已经移动,模型族排名作废,要重测,不是加两层。改卡比改网络便宜,但必须留下版本:V1 单步点、V2 多步点、V3 多步区间。对照日志按版本存,禁止把 V1 的漂亮 RMSE 贴到 V3 的汇报上。
问题:不规则采样怎么填对象这一列?
单独勾不规则。公交到站不是等间隔负荷。后面预处理要决定:投影到整点网格,还是保持事件序列。切分卡不勾这一项,第 2 章会默认网格化,把事件抹掉。SOURCE 承认间隔可以不固定,并不等于深度会自动处理;只是提醒你这是合法时间序列,需要单独策略。
把三张业务表和两问写进项目备忘,第 1.2 节的六条优势才有地方挂钩。没有落点的优势清单,只是宣传册。
五、切分卡版本号
切分卡不是填一次。产品从“看一眼”改成“自动排班”,horizon 已经变,旧版 RMSE 作废。给卡打版本:对象、H、点或区间、决策用途四列任一变化就升版本。对照日志按版本分夹,禁止把旧版漂亮数字贴到新版汇报。SOURCE 把单步多步、点区间并列,正是因为它们是产品选项不是模型等级。港口若只决策前三日泊位,却用十四日平均当主指标,是卡填错,不是网络不够新。冷库越限报警只要上尾,却用 RMSE 选模型,同样是卡填错。把版本号写进实验文件名和报告页眉,比再写一段定义更有用。
六、切错任务的三种典型账单
第一种账单最常见:内部比赛用单步 RMSE 选了 LSTM,上线却要滚 96 步负荷。验证集上的胜利是单步题的胜利,产品题是多步。切分卡如果一开始就把 horizon 写成 96,这种错法会被挡住。第二种:报表考核点预测,库存同事按带子备货,模型组只优化 RMSE,上线后安全库存仍然拍脑袋。点与区间是并列选项,SOURCE 写得很清楚,不是点做完再“加个置信带”。第三种:对象勾了多变量,训练却用事后气温,信息集非法,深度假赢。三种账单看起来像模型不行,其实是任务没切开。
把账单反向当检查单。上线漂了,先问切分卡版本有没有和产品一致,再问模型族。一致而仍漂,才进入第 5 章诊断。不一致,先改卡重测,不要加层。港口、变电站、冷库三张表示意,用来练习填卡,不是标准答案。你的项目应有自己的一张卡,四列都勾,决策用途能用一句话说给非技术人员听。说不清用途,就还没有任务,只有数据文件。
七、四列互相卡住时听哪一列
对象、预测步数、输出形态、决策用途四列会打架。听决策用途。报表只要一个点,却把区间列勾上,后面会为带宽浪费容量。备用决策要超限概率,却把输出勾成点,后面会用均方根误差选出一个从不敢报高峰的模型。预测步数与决策窗口不一致时,缩短步数而不是加深网络。对象勾多变量但决策时刻拿不到预报,把通道降回当时信息集。四列冲突时改卡,不改层数。公交到站若决策是下一班会不会晚点超过八分钟,切分卡应是单步上尾,不是未来两小时轨迹的平均误差。
要点速记
- 时间序列按时间排序,核心是顺序,不是表格里多了一列日期
- 四块分解:趋势、季节、周期、残差;加法/乘法按波幅是否随水平变化来选
- 单步不累积,迭代会滚雪球,直接多输出换更大的输出头
- 点预测对齐 RMSE 考核,区间对齐备货与风险
- 切分卡四列:对象、horizon、输出形态、决策用途
- 不规则采样也是时间序列,要单独勾选,别默认为等间隔
下一节把同一张切分卡放到“经典统计 vs 深度学习”轴上,看六条深度优势各自在什么条件下成立。