2.1 序列特性对照表
2.1 序列特性对照表
本节摘要:时间序列相对独立同分布数据的核心差别是时间依赖。趋势、季节、周期、随机性、平稳性、异常值会同时出现在一条曲线上。统计模型把这些特性写成可检验的假设;深度模型把它们吃进非线性,但不等于已经处理。对照表的用法是:每项特性决定你后面预处理和模型族该往哪边偏。
阅读收获
阅读完本节,你应当能够:
- 区分自相关、偏自相关、互相关三种依赖
- 指出趋势存在时均值会随时间变,因而序列非平稳
- 说明季节与周期对日历对齐的不同要求
- 对异常值给出“删、盖、留作事件”三种对照,而不是一律当噪声
一、时间依赖不是“看起来连着”
SOURCE 把时间依赖性定为时间序列最核心的特性:当前或未来观测与过去观测有统计关联,数据不是随机独立的。冷库温度现在偏高,十分钟后大概率还偏高,这是依赖,不是模型学聪明了。
三种相关不要混。自相关是同一序列不同滞后之间的相关,今天负荷对昨天负荷。偏自相关是去掉中间滞后之后的直接相关,用来看“是不是真的需要那么高的阶”。互相关是两条序列之间的滞后相关,例如气温领先负荷两小时。深度学习宣传自己擅长捕捉时间依赖,RNN、LSTM、GRU、注意力、Transformer 都在 SOURCE 里被点名;但它们捕捉的是统计关联,不是因果。气温与负荷互相关高,不代表你该用负荷去预报昨天的气温。
公交到站间隔的自相关往往在滞后 1 很强、更远很快衰减:司机连发、路口拥堵会传到下一班,但传不了十班。这种短依赖,统计模型很舒服。港口吞吐量若被周班期锁住,自相关会在滞后 7 出现尖峰,那是季节,不是“长依赖神话”。
滞后 k 的自相关:Corr(x[t], x[t-k]) 偏自相关:去掉 1..k-1 之后,x[t] 与 x[t-k] 的直接相关 互相关:Corr(x[t], z[t-k]) 注意谁领先谁
二、趋势、季节、周期、残差:同一张表里的四行
趋势是长期升、降或走平,可以线性也可以弯。SOURCE 举例:上升如长期增长,下降如某些传统产量,无趋势则在均值附近晃。趋势一旦存在,均值随时间变,序列非平稳。统计侧常用差分去趋势;深度侧可以差分,也可以把时间索引或慢通道当作输入让网络自己拟合趋势。我更倾向:趋势很稳时差分或显式趋势项更省;趋势会拐弯、会结构性变时,留给深度,但验证段必须包含至少一次拐弯,否则网络只是把旧趋势外推。
季节是固定周期、可对齐日历的重复,零售节假日、工作日双峰都是。周期是长度不固定的起伏,经济景气是典型。深度模型两者外观相似,都是“过一段时间又抬起来”,但业务解释完全不同。把景气循环当成季节,换一个周期长度就会集体估错。
随机性/残差是四块里解释不掉的部分。SOURCE 把它当噪声。深度的危险在于:容量足够时,残差也会被拟合。对照方法是看测试段残差是否仍像训练段那样“无结构”。若测试残差突然出现星期效应,说明季节没学够,不是随机性变了。
图 七项特性对两条路线的含义
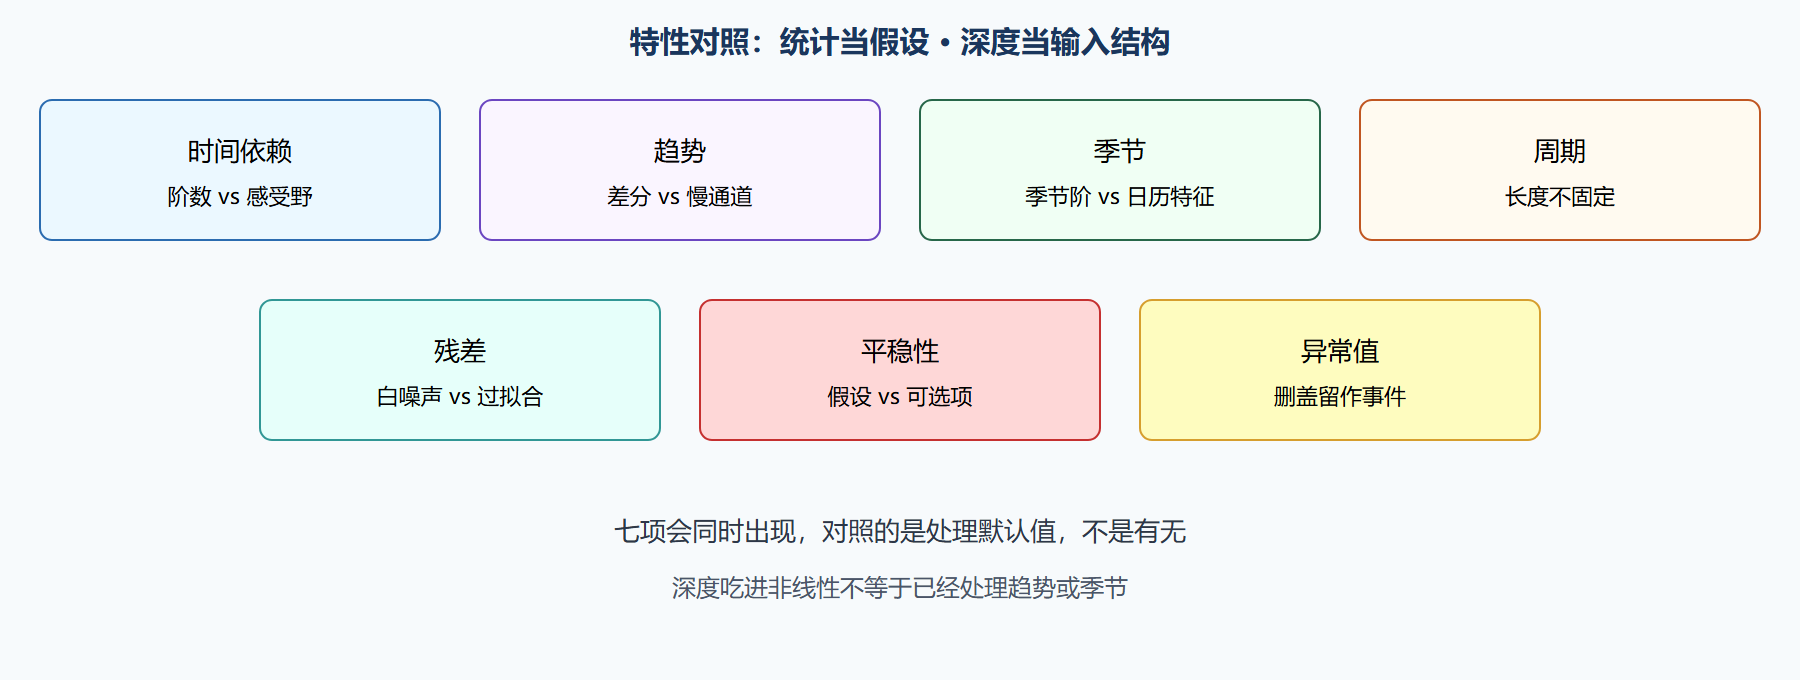
| 特性 | 统计侧默认 | 深度侧默认 | 对照时要问 |
|---|---|---|---|
| 时间依赖 | 用 ACF/PACF 定阶 | 用窗口长度和结构 | 窗口是否覆盖关键滞后 |
| 趋势 | 差分或趋势项 | 可差分可学习 | 验证段有没有拐弯 |
| 季节 | 季节差分/季节阶 | 日历特征或周期卷积 | 周期是否对齐日历 |
| 周期 | 难,长度不定 | 当慢波动来学 | 会不会和季节互相抢 |
| 残差 | 检验白噪声 | 看测试残差结构 | 是欠拟合还是过拟合 |
| 平稳性 | 通常要求 | 不强制但有帮助 | 分布漂移有多大 |
| 异常 | 稳健方法或剔除 | 对 MSE 很敏感 | 异常是故障还是信号 |
三、平稳性与异常:深度最容易装看不见的两行
平稳性指统计性质不随时间变。非平稳最常见的来源是趋势和季节。SOURCE 说趋势存在意味着非平稳,预测前通常要识别和处理。深度圈有一种说法:“网络自己能学非平稳。”有时能,有时只是把训练段的均值水平记住。换到均值已经抬升的测试年,误差会整体偏。对照实验很便宜:一份原始、一份差分,同一网络比测试误差。谁赢用谁,不要信仰。
异常值会把 MSE 拉歪,LSTM 的门也会被极端值打满。三种处置对照:确认是传感器故障就删或插值;确认是真实冲击(台风停航)就留着并加事件特征;不确定就用 MAE/Huber,降低平方惩罚。不要在训练里删、在测试里留,那是另一种泄漏。
⚠️ 常见坑:把互相关当因果。气温领先负荷,把负荷当气温的因去训,会上线笑话。
💡 关键直觉:特性表是给预处理和模型族看的菜单。没勾“非平稳”,就不要怪模型在新的一年整体偏一截。
变电站负荷同时具备:滞后 1 强自相关、滞后 96 的日季节(15 分钟采样)、工作日/周末季节、缓慢年趋势、极端高温日的异常尖峰。七行全亮。统计模型会显式写下其中几行;深度模型若窗口短于一日,日季节都看不见,再深的网络也只是在盲区里拟合。
四、用偏自相关决定窗口,而不是用习惯的 2 的幂
特性表勾完,要落到窗口长度。很多人从 16、32、64、128 扫,却从不对齐业务周期。15 分钟负荷的日季节是 96,周季节是 672。窗口 64 盖不住一天,网络再深也在盲区里拟合。统计侧用 PACF 看直接相关截在哪一阶,深度侧同样该看:滞后增益在哪一阶停。增益早停的那一阶,就是有效依赖长度,第 3 章硬伤表要用它。
趋势与平稳性的对照实验必须写成两行:原始窗口、差分窗口,同一划分同一网络。只做一行,你无法反驳“网络自己能学非平稳”这种信仰。验证段若全在同一水平年,两行都会看起来能打,结论仍不稳;尽量让验证包含一次水平变化或一次季节切换。
异常值那一行要和损失对照,不能只在预处理里删点。删了训练尖峰、留着测试尖峰,RMSE 会惩罚你“没见过的真高峰”。事件日应进特征,故障日才进剔除名单,名单在训练验证测试上共用。SOURCE 把异常与平滑并列,工程上必须先分类。
互相关那一行最容易写成因果故事。气温领先负荷两小时,合法用法是把当时的气温预报放进未来槽。用负荷去“解释”气温,或者用事后气温当真值训练,都是把相关当因果。特性表要加一列“领先还是滞后、决策时刻能否拿到”。
把七行特性写成项目里的一页纸,预处理和模型族才有共同语言。没有这页纸,第 2.2 的填充和 2.3 的滞后会各说各话。
五、七行特性怎么写进窗口和损失
特性表若不连到窗口和损失,只是名词表。主季节长度决定窗口下限;PACF 截尾决定有效路径,给第 3 章硬伤表用。趋势存在则非平稳,差分与慢通道必须两行对照。季节对齐日历,周期不齐,解释权要人标,网络不会开口。残差应无结构,有星期结构就加日历而不是加层。异常是事件则进特征,是故障则进共用剔除名单。互相关要写清领先滞后和决策时刻能否拿到。把这一页纸钉在数据契约首页,2.2 和 2.3 才不会各说各话。变电站七行全亮时,窗口短于一日等于把日季节这一行划掉。
六、特性行与后文旋钮的接线
时间依赖接到窗口长度和有效路径。趋势接到差分对照与验证段是否含拐弯。季节接到日历特征和窗口是否覆盖周期。周期接到“不要当成季节”。残差接到诊断分组。平稳性接到是否信仰网络自己能学非平稳。异常接到损失是否 MSE 以及名单是否训练测试共用。七根线少一根,后面会各调各的。例如只拉长 LSTM 去补星期残差,其实该加日历,特性表星期那一行没有接到特征工程。
画一张自己的七行表,每行写:统计默认、深度默认、我选的默认、接到哪个文件版本。这张表比再解释一遍自相关定义有用。互相关行务必加“决策时刻能否拿到”。气温领先两小时,合法的是当时预报,不是事后观测,也不是用负荷去解释昨天的气温。特性表是给预处理和模型族看的菜单,不是给论文写相关工作的名词堆。
七、特性表与切分卡必须对得上
切分卡写多步九十六,特性表窗口却只有六十四,等于用看不见完整日季节的眼睛去做日前题。切分卡写区间,特性表异常行却用删除尖峰来喂平方损失,等于先把要保的上尾剪掉再谈覆盖率。切分卡写单变量,互相关行却把事后气温写进通道。三张纸对不上,后面所有族对照都在答错题。先让窗口、异常、互相关三行去迁就切分卡,而不是让产品迁就现成窗口超参。
问题:平稳性对照实验最少要怎样做才算数?
同一划分同一网络,一份原始窗口一份差分窗口,测试误差谁低用谁。验证段必须尽量包含一次水平变化,否则两行都会看起来能打,结论锁在同一年的均值上。深度圈“网络自己能学非平稳”有时成立,有时只是记住了训练段水平。换到均值已抬升的测试年,误差整体偏。差分的积分误差要算进同一指标,不要只比差分空间里的数。趋势会拐弯时,验证还要含拐弯,否则网络只是把旧趋势外推。这一问答直接接到特性表趋势行与平稳性行,不再抽象讨论定义。
本节速览
- 时间依赖是核心,自相关、偏自相关、互相关不要混用
- 趋势导致非平稳,差分和慢通道是对照项,不是深度自动完成
- 季节对齐日历,周期长度不固定,解释权仍要人标
- 残差应无结构;深度容量大会把噪声当信号
- 异常三策:删、盖、留作事件,训练测试必须一致
- 窗口长度要覆盖关键滞后,否则特性表勾了也白勾
下一节对照预处理:缺失、异常、缩放、差分,统计默认和深度默认为什么不能混抄。