4.1 RNN族与记忆门控
4.1 RNN 族与记忆门控
本节摘要:循环网络在每个时间步共享权重,并用隐藏状态传递记忆。基本 RNN 把记忆和梯度绑在同一条非线性路径上,长依赖先死。LSTM 用遗忘门、输入门、输出门和细胞状态把读写分开;GRU 用更新门和重置门做成更瘦的版本。对照点是:门的数量、是否并行、数据少时谁更稳——不是谁更新。
读前必看
阅读完本节,你应当能够:
- 写出基本 RNN 一步更新:当前输入加上一隐藏状态
- 对照 LSTM 三门各自拦住什么,细胞状态为何更利于梯度
- 说明 GRU 少一门在什么数据规模上更划算
- 列出双向、多层堆叠的收益和泄漏风险
一、为什么要循环,而不是把窗口拍扁
SOURCE 开篇就点:时间序列点与点之间有时间依赖,MLP 假设输入独立,RNN 用记忆吃依赖。逐步计算的直觉像值班日志:这一刻的判断,要翻上一刻还没合上的本。隐藏状态就是那本还没合上的摘要,不是把全部历史复印一份。
基本更新 SOURCE 写成:隐藏状态由上一隐藏与当前输入经非线性得到,再映射到输出。权重 W_h、W_x 在每个时间步共用。展开之后像一条深网络,但参数不随长度增加。这是优雅,也是陷阱:深度等于长度,梯度要走完这条深路。
冷库 12 步窗口,基本 RNN 经常已经能打。变电站跨周窗口,基本 RNN 的 tanh 路径会把月初的冲击压没。这时不是再加一层普通 RNN 能救的,加层等于路更长。该换的是细胞通路。
h_t = tanh(W_x x_t + W_h h_{t-1} + b) y_t = W_y h_t + b_y 同一套 W 用于每一个 t
二、LSTM 三门对 GRU 两门
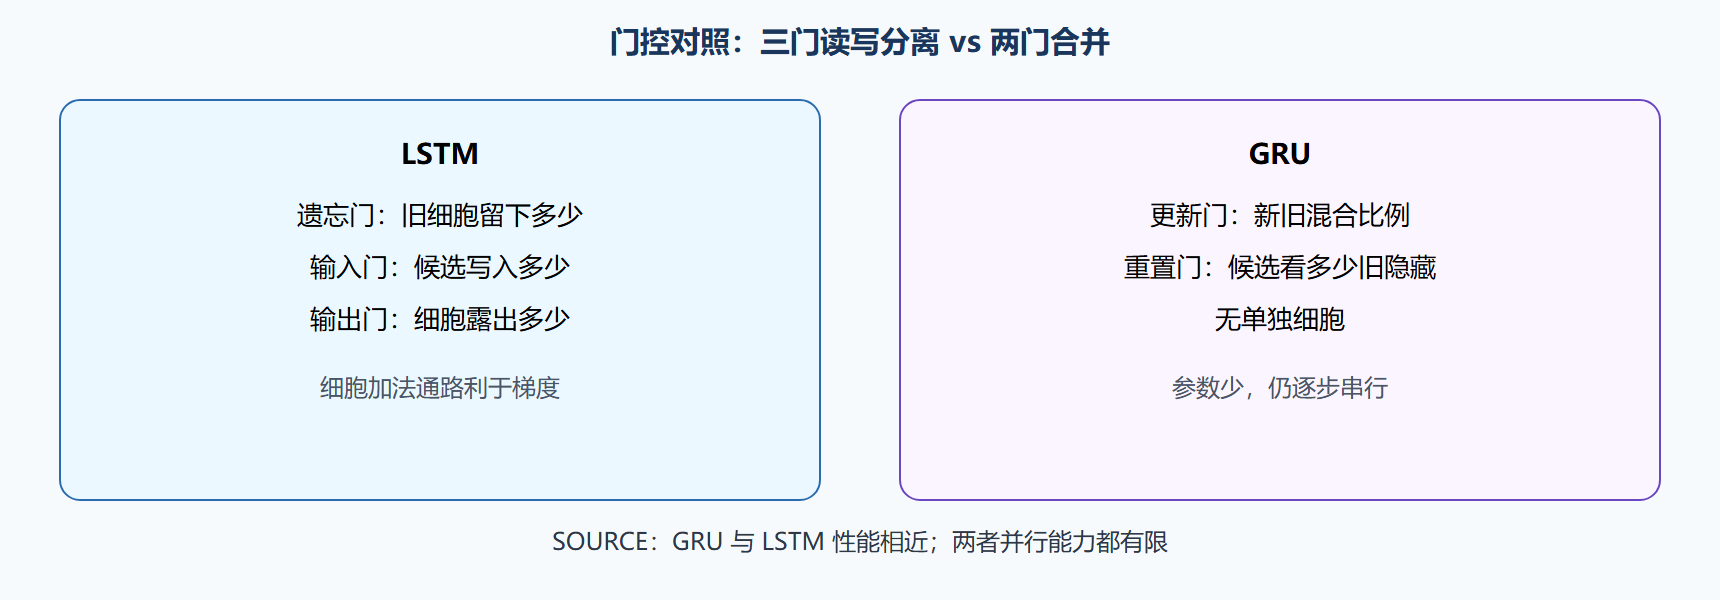
SOURCE 对 LSTM 的门清单是:遗忘门、输入门、输出门,外加候选记忆。遗忘门决定上一细胞哪些扔掉,输入门决定候选哪些写入,输出门决定细胞哪些露到隐藏状态。细胞状态更新是遗忘后的旧细胞加输入门控后的候选——这条加法路径让梯度不必每步都乘饱和的 tanh。这是相对基本 RNN 的本质对照,不是多了几个希腊字母。
GRU 把遗忘和输入合成更新门,用重置门控制候选怎么用上一隐藏,隐藏状态与记忆不再分家。SOURCE 的判断是:性能与 LSTM 相近,参数更少,训练更快;并行能力仍然有限。我的经验取舍:样本少、要先出基线,GRU;序列更长、要细控记忆,LSTM。两者都赢不了再换族,不要在门的数量上反复横跳。
双向 RNN 让未来步也流入当前,对标注任务(断点检测)有用,对预测任务默认危险:预测不能看未来。只有在做插补、且信息集允许时才开双向。多层堆叠是把一层的隐藏当下一层输入,表示能力涨,过拟合也涨。深度时间序列里两到三层门控已经很多,再深优先加残差或换 TCN,而不是 RNN 叠到八层。
图 LSTM 三门与 GRU 两门对照
| 结构 | 记忆载体 | 门数 | 并行 | 小样本 | 预测任务注意 |
|---|---|---|---|---|---|
| 基本 RNN | 隐藏状态 | 0 | 差 | 有时够 | 长窗易忘 |
| LSTM | 细胞+隐藏 | 3 | 差 | 中 | 默认稳 |
| GRU | 隐藏 | 2 | 差 | 更友好 | 先做基线 |
| 双向门控 | 双向状态 | 翻倍 | 差 | 易过拟合 | 默认关 |
三、工程上怎么对照,而不是怎么实现每一个门
实现细节各框架都有现成单元,不必手写。对照实验要锁的是:同一窗口、同一划分、同一损失。只换单元类型。隐藏维从 32、64、128 扫,不要一上来 512。Dropout 加在层间,不要加在时间步之间乱丢中间状态,除非你清楚自己在正则什么。
梯度爆炸仍可能发生,即便有门。裁剪梯度是廉价保险。学习率对门控比卷积更敏感:太大,门饱和;太小,忘不掉的东西清不掉。Adam 是 SOURCE 后文的常用默认,门控上同样适用。
预测任务的输出头:单步一个线性层;多步要么循环解码,要么一次性多输出。循环解码把预测值喂回去,和基本 RNN 一样会累积误差。这是任务形态问题,放到第 6 章,不要在这里怪 LSTM 不行。
⚠️ 常见坑:开双向 LSTM 做预报,验证集神准,因为未来点已经漏进当前状态。
💡 关键直觉:门控补的是梯度公路,不补并行。墙钟时间不可接受时,该换 TCN,而不是把 LSTM 叠厚。
港口日序列一年三百多个点,GRU 隐藏 64、两层,常常已经接近容量上限。再加大只会背年。真正的长依赖若来自年度季节,用日历通道比加细胞更对症。
四、门控对照实验的最小日志
只换单元、锁其余。日志至少六列:单元类型、隐藏维、层数、是否双向、验证主指标、测试主指标。双向默认关,打开必须写信息集理由。隐藏维 32、64、128 三档通常够看出容量是否饱和。两层以上若训练变差,先查梯度裁剪和学习率,再查是不是窗口太长让逐步展开不稳。
教师强制与否要单列。单步任务没有强制问题;多步循环解码必须在验证关闭强制。否则 4.1 的“LSTM 很好”会在 6.2 被打脸,两章结论冲突,其实是策略没对照。门控单元本身不规定输出头:线性单步、多输出、分位头都可以接。把 MSE 焊死在 LSTM 上,是把族和形态焊死。
小样本上 GRU 优先,不是因为更新,是因为参数少、SOURCE 也说性能相近。样本大、序列长、需要细控遗忘时再 LSTM。两者都打不过 MLP,停,不要在三门两门之间开宗教辩论。细胞状态可视化很少能讲给调度听,不要把“可解释”寄托在门的曲线上,那是 6.4 的事。
梯度裁剪是廉价保险,爆炸时先裁再降学习率。Dropout 放层间。时间步间随机丢状态会拆季节,除非你在做明确的正则对照。这些是门控家族的工程默认,换到 TCN 后默认会变,不要把 LSTM 的 Dropout 习惯原样搬过去。
五、门控日志六列就够
单元、隐藏维、层数、是否双向、验证主指标、测试主指标。双向默认关。多步循环解码验证必须关教师强制,否则本章“LSTM 很好”会在 6.2 被策略打脸。门控不规定输出头,MSE 不要焊死在 LSTM 上。小样本 GRU 优先,SOURCE 也说性能相近参数更少。两者都打不过 MLP 就停,不要辩论三门两门。细胞曲线对调度讲不清,可解释不要寄托在门上。梯度裁剪廉价;Dropout 放层间,时间步间乱丢会拆季节。这些默认换到 TCN 要重写,不能原样搬。
六、预测任务上双向默认是泄漏
未来步流入当前状态,插补或许合法,预报默认非法。打开必须写信息集理由。多层堆叠两到三层门控已经很多,再深优先残差或换 TCN。小样本上把隐藏维拉到 512 是在背年。教师强制与输出头策略分列,不要把多步差算在 LSTM 头上。SOURCE 对 GRU 的判断是性能相近、参数更少、仍不并行;墙钟不可接受时换族,不是把 LSTM 叠厚。
日志六列足够复现对照。梯度裁剪先于降学习率。Dropout 放层间。细胞可视化很少能对调度讲,可解释放到 6.4。港口日序列一年三百多点,GRU 隐藏 64 两层常常接近容量上限。年度季节用日历通道比加细胞对症。门控补的是梯度,不补并行,也不补你没写的节日。
问题:LSTM 和 GRU 来回横跳有没有意义?
小样本上意义很小。SOURCE 已写性能相近、GRU 更瘦。横跳消耗验证信息,不如把预算留给窗口是否对齐周期、以及多步是否关强制。细胞加法通路是相对基本 RNN 的本质对照,不是相对 GRU 的宗教。预测任务双向默认关。隐藏维三档看出饱和即可。港口年序列点少,加细胞不如加日历。墙钟不可接受时换 TCN,不是叠到八层 RNN。门控不规定 MSE 头,分位头也可以接。把单元类型当成唯一旋钮,是把族轴和形态轴焊死。日志六列复现一次对照,比实现每一个门的公式更有工程价值。
门控对照要写成可复现的六列日志,并堵上三条最常见的假胜利。第一,双向打开却不声明信息集,预报任务这就是看未来。第二,多步验证仍开教师强制,数字接近单步,上线关掉才漂,责任在策略不在三门两门。第三,隐藏维一次拉到很大,训练误差下降被当成 LSTM 赢了,其实在背年。小样本优先门控循环的瘦版本,来源是参数更少且性能相近,不是因为更新。两者都打不过拍扁下限就停。墙钟不可接受换并行卷积,不要叠八层循环。细胞状态不要当成给调度的解释。梯度裁剪当保险,层间随机丢弃当正则,时间步之间乱丢会拆季节。输出头与损失跟形态走,平方损失不要焊死在循环单元上。年度季节用日历,不靠把记忆细胞加宽来装年。
把一次门控对照当成小型审计。审计项包括:双向是否关闭、多步是否关强制、隐藏维是否在三档内饱和、测试是否原单位、是否已打过拍扁下限。五项缺一,不允许宣称循环赢了。瘦门控与三门对照只在五项都过之后才有意义,而且多数小样本项目到此可以停。墙钟超时改并行,日历没写别加细胞。输出头按点或分位接,不要把平方损失焊在单元类型上。细胞曲线不对调度展示。年度结构用日历通道。审计项写成清单贴在训练脚本顶部,换随机种子时一并检查,避免只换种子制造假的结构差异。港口点少时审计会更严,容量上限更低,更容易在下限行停住,这是健康结果。
审计清单贴上之后,换种子只允许改随机性,不允许顺便打开双向或加大隐藏维。否则你分不清增益来自结构还是来自泄漏与容量。港口点少时清单更严,停在下限行是健康的。
七、门控赢了也不等于族轴锁死
门控在单步点预测上打过拍扁下限,只说明逐步记忆对这条序列有用,不说明多步迭代、分位头、在线时延也会赢。把单步误差写进部署页,等于把后面的形态开关焊死。合法结论句式是:在当前切分卡版本、关闭教师强制、原单位指标下,瘦门控优于拍扁下限。句式里缺任何一句限定,结论就过宽。港口日点少时这句常常写不出来,停在下限行。
核心回顾
- RNN 共享权重 + 隐藏状态,展开深度等于序列长度
- 基本 RNN 梯度问题,长依赖先死,SOURCE 原文即此
- LSTM 三门 + 细胞加法通路;GRU 两门更瘦、性能相近、仍不并行
- 预测任务默认关闭双向
- 对照只换单元,锁窗口划分损失
- 门控解决不了墙钟时间,并行是下一族的戏
下一节把同一条序列交给一维卷积和 TCN,看并行感受野如何对照逐步记忆。