4.4 MLP直通与分解网络
4.4 MLP 直通与分解网络
本节摘要:多层感知机把窗口拍扁,没有逐步记忆,也没有卷积核。短窗口、特征已经手搓充分时,它经常是最稳的深度基线。后起的分解式全连接把趋势和季节拆成不同块再加总,用可加结构换一点解释。对照 RNN/TCN/Transformer:MLP 输在长度与顺序变化,赢在简单、快、小样本不容易把自己玩死。
你能学到什么
阅读完本节,你应当能够:
- 说明拍扁 MLP 的归纳偏置:位置即语义、长度锁死
- 把滞后特征 + MLP 当作必须保留的对照行
- 理解分解式网络为何把趋势块和季节块分开拟合
- 在“先上大序列模型”之前用 MLP 卡一条下限误差
一、被跳过的那一行常常赢
SOURCE 把 MLP 和其他模型并列,不是附录。很多对照实验的耻点是:LSTM 调了两周,最后发现滞后 24 维加两层全连接更低误差。原因不神秘。任务若主要是短滞后加日历,归纳偏置里的“逐步记忆”“全局对齐”都是多余容量,多余容量在小样本上背噪声。
拍扁的合法条件在第 3 章写过:窗口固定、采样率固定、位置语义稳定。负荷日前预测若永远用过去 96 点,这三个条件成立。这时 MLP 是正选之一,不是将就。非法条件:你想随时把窗口从 96 改成 672,或混入变长事件,MLP 要改输入维重训。
港口周序列一年五十多个点,上 Transformer 几乎是表演。三层 MLP、隐藏 32,加星期哑变量,才是和样本量匹配的深度。深度不等于序列族。
基线A: 滞后特征 + 线性回归 基线B: 同一滞后 + MLP 基线C: 原窗口 + LSTM/TCN/注意力 先让 B 打过 A,再让 C 打过 B C 打不过 B,就停,不要加混合
二、分解:把可加结构写回全连接
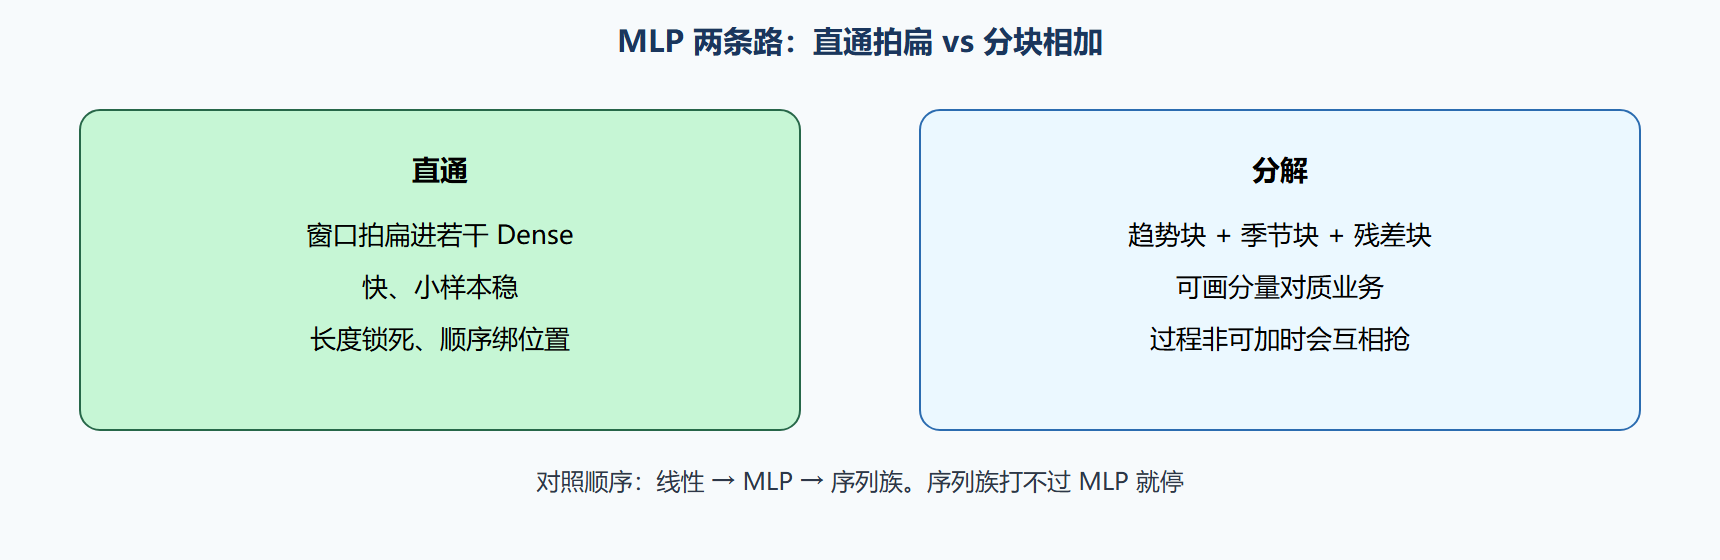
N-BEATS 一类结构的思想是:不要让一个黑盒同时吐出趋势和季节,让不同块分别拟合再相加。SOURCE 在混合与变体里没有把每个名字展开,但“分解”与时间序列经典加法模型是同一直觉。好处是:趋势块的输出可以画出来和业务对质;季节块是否呈周波形,一眼能看。坏处是:真实过程若不是可加,硬拆会互相抢残差。
对照做法:同一数据上,普通 MLP、分解式全连接、LSTM 三行。若分解式只赢在可画、不赢在误差,而业务要解释,仍可选它。误差和解释不是同一指标,第 6 章会把可解释单独开轴。不要用“可解释所以一定更准”这种偷换。
直通 MLP 的正则很重要,因为它没有共享权重的约束。Dropout、权重衰减、早停,三条里至少两条要开。隐藏维宁小勿大。输出头与任务对齐:单步一个数,多步 H 个数,区间则多分位数,不要用一个 MSE 头假装区间。
图 拍扁直通与分解相加
| 模型 | 顺序归纳 | 小样本 | 可变长度 | 解释 | 角色 |
|---|---|---|---|---|---|
| 线性滞后 | 无 | 最好 | 否 | 系数 | 绝对下限 |
| 拍扁 MLP | 位置绑定 | 好 | 否 | 弱 | 深度下限 |
| 分解全连接 | 分块可加 | 中 | 否 | 分量图 | 要解释时 |
| LSTM/TCN | 强 | 中 | TCN 弱 | 弱 | 形态复杂时 |
三、MLP 何时明确不该用
输入长度经常变;不规则事件;要共享跨站点的逐步动态;要画“模型在看哪一段历史”。这些需求把拍扁请出主位。即便如此,MLP 仍应留在实验日志第一行,作为“复杂结构至少要打过它”的门槛。SOURCE 后文评估与优化章节默认你会公平对照——没有下限的对照,只是内部不同超参的自我比赛。
多输出 MLP 一次吐 H 步,没有迭代累积,这是相对循环解码的隐藏优势。短 horizon 上很多“LSTM 多步差”其实是迭代策略差,换成多输出 MLP 就平了。把策略和模型族拆开对照,是第 6 章的主题,这里先埋这个钉子。
⚠️ 常见坑:深度项目组默认不跑 MLP,评审时拿不出“复杂结构的增益”。增益说不清,就不能为显卡预算辩护。
💡 关键直觉:MLP 是深度对照表的零点。零点不是落后,是尺子。
冷库若特征已经包含滞后 1、滞后 4、小时正弦余弦、开门事件,MLP 两层通常能吃满可预报部分。再上 LSTM 若只降一点点训练误差、测试不变,那是容量在背开门后的偶然抖动。
四、下限实验怎么写进评审材料
评审最常见的漏洞是只有序列族内部排名。材料里应有三行固定出现:季节朴素或持久、滞后线性、拍扁 MLP。深度项目若打不过第三行,申请显卡的理由不成立。打过第三行但幅度小于测量噪声,写“无显著增益”,采用 MLP,这是对照成功。
分解式全连接若误差与直通 MLP 持平,但趋势块画出的慢漂移能被业务点头,可以因解释留下分解,不要改口说它更准。反之,分解误差更差却因为图好看而采用,要在文档里写明用解释换精度,让决策者签字,不要混成“更科学”。
多输出 MLP 常被低估。固定 96 点日前任务,它没有迭代累积,墙钟短,调参面小。很多“LSTM 多步差”的内部比赛,其实没给 MLP 多输出同等待遇。本章把这个待遇写成义务。窗口将来要改长度,MLP 才退出主位,改留在日志下限行。
正则默认:权重衰减开、早停开、隐藏维从小到大。直通没有共享约束,更容易背年。看见训练损失远低于验证,先减维,不要先加分解块。分解块是结构选择,不是正则手段。
五、三行下限是显卡申请的前提
季节朴素或持久、滞后线性、拍扁 MLP 必须出现。打不过第三行,显卡理由不成立。打过但幅度小于噪声,写无显著增益、采用 MLP,这是对照成功。分解式与直通持平时,只能因分量图可对质而留下,不准改口更准;更差却因图好看而采用,要写明用解释换精度。固定 H 的多输出 MLP 无迭代累积,必须给它与 LSTM 多步同等待遇。窗口长度将来常变,MLP 才退出主位,下限行仍留。直通无共享约束,训练远好于验证时先减维,分解块不是正则。
六、尺子不是落后
零点用来量增益。没有零点,复杂结构只是内部自我比赛。线性滞后、拍扁 MLP、序列族三行,先让第二行打过第一行,再让第三行打过第二行。第三行打不过就停。分解网络用可加块换可画分量,过程非可加会互相抢残差。解释和误差分开报,不准偷换成一定更准。
固定窗口固定采样时拍扁合法。长度常变、要看对齐历史、不规则事件,拍扁退出主位但下限行仍在。多输出 MLP 没有迭代累积,短 horizon 上常被误判成模型更强,其实是策略更干净。直通正则至少开衰减和早停。评审材料缺三行下限,不接受族排名。
问题:MLP 打过 LSTM 是不是实验失败?
不是,是对照成功。说明多余序列偏置在背噪声。材料里应庆祝下限行赢了,而不是把 LSTM 再调两周直到训练误差更低。分解式持平时只因分量可对质而留,不准说更准。更差却因图好看要签字:用解释换精度。固定 96 点日前,多输出 MLP 无累积,必须给同等待遇。长度要改时拍扁退出主位,下限仍留。直通没有共享约束,训练远低于验证先减维。三行下限是显卡申请前提,缺行不接受族排名。尺子不是落后,是防止自我比赛。
下限实验写进评审章程:季节朴素或持久、滞后线性、拍扁全连接,三行缺一不审深度。第三行赢了序列族且幅度小于噪声,采用全连接,对照成功,不要再把循环调到训练误差更低来挽回面子。分解式全连接与直通持平时,只允许因趋势季节分量可对质而留下,不准改口更准;更差却因图好看,必须写明用解释换精度并让决策者签字。固定长度的多输出头没有迭代累积,必须与循环多步同等待遇,否则会把策略优势误判成模型优势。长度常变时拍扁退出主位,下限行仍留着当尺子。直通没有共享约束,训练远好于验证时先减隐藏维。没有尺子的复杂结构,只是内部自我比赛,申请算力的理由不成立。
把三行下限写成不可跳过的门禁脚本:朴素、线性、拍扁。脚本不跑完,深度实验不得开。拍扁赢了循环且增益小于噪声,门禁输出采用拍扁,实验结束。分解式只在需要分量对质时加一行,误差不优于直通就不得写更准。多输出头与迭代策略分列,避免把无累积的策略优势算成全连接更强。长度锁死是拍扁合法条件,条件破了退出主位但门禁仍要跑,因为新的序列族还是得打过新条件下的拍扁或它的替代下限。减维优先于加块。门禁日志留存,申请算力时附上。没有门禁的深度项目,对照主调不成立。把这句话写进本章要点之外的作业要求里,评审按作业收,不按架构图收。
门禁脚本应每天可重跑。数据契约一变,拍扁下限也要重跑,不能沿用上周的拍扁误差去卡本周的循环。否则尺子本身过期。过期尺子会让不该上的序列族过门,也会把该上的挡在门外。把重跑触发条件写成:窗口、采样、特征清单任一变化即触发。触发后三行数字全部刷新,再决定是否打开循环或卷积实验。这是下限行的运维,不是一次性手续。
尺子过期比没有尺子更危险。窗口或特征一变,三行下限必须重跑,再用新数字决定序列族能不能开门。否则上周拍扁误差会错放本周循环。运维触发条件写进脚本:窗口、采样、特征清单变化即刷新三行。刷新前禁止打开新的结构实验。申请算力时附上刷新时间戳。没有时间戳的下限行,评审视为未跑门禁。把这句话当作拍扁节的收尾纪律,避免下限变成墙上的旧海报。
本章回顾
- 拍扁 MLP 合法于固定窗口、固定采样、稳定位置语义
- 必须保留线性与 MLP 两行下限,序列族要打过它们才有资格
- 分解网络用可加块换可画分量,不准偷换成“一定更准”
- 小样本上多余的序列归纳偏置会背噪声
- 多输出 MLP 没有迭代累积,常被误判成“模型更强”
- 长度常变、要看对齐历史时,再换族
下一节只在单族对照已经失败时,才讨论 CNN-LSTM、TFT、集成这些混合结构。