5.1 划分策略对照
5.1 划分策略对照
本节摘要:时间序列划分必须保持时间顺序,不能随机打乱。SOURCE 把训练集、验证集、测试集写成学习、调参、最终评估三套用途,并用滑动窗口或固定窗口切。对照点是:固定切一段 vs 滚动多段、先切大段再滑窗 vs 先滑窗再抽样本。错一种,后面所有模型族比赛都是假的。
核心问题
阅读完本节,你应当能够:
- 画出训练、验证、测试在时间轴上互不重叠的三段
- 说明随机打乱为何等于让模型看见未来的分布
- 对照固定窗口与滚动窗口各自的偏差-方差
- 检查滑窗右端是否越过划分点
一、打乱是分类的习惯,预报的事故
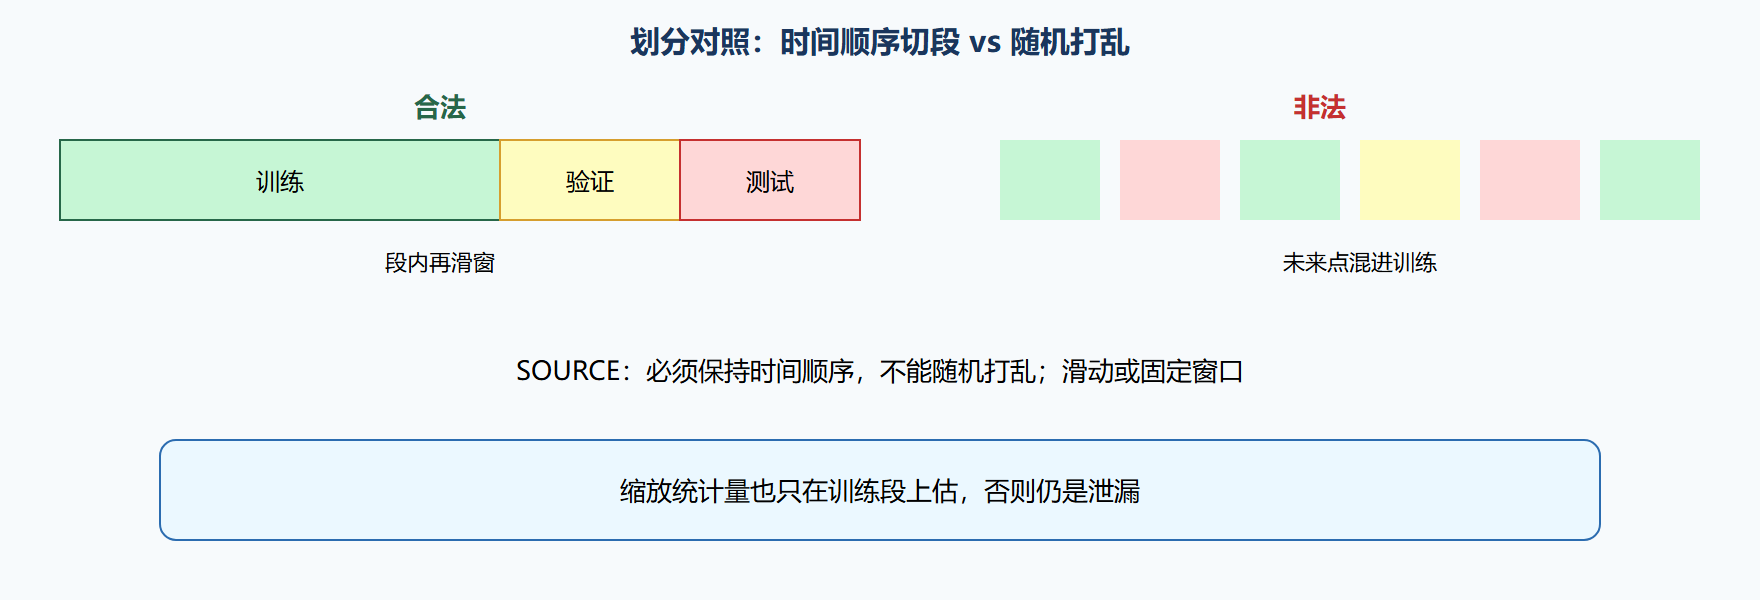
表格分类里随机划分是为了让三套数据同分布。时间序列的分布会走,同分布假设先不成立;更糟的是打乱之后,训练样本的“未来”会出现在测试样本的“过去”里。网络会从泄漏的未来学会明年的水平,测试误差漂亮,上线第一周就现形。
SOURCE 的顺序是历史数据按时间流向训练、验证、测试,再流向真正的未来预测。三套用途不许混:训练更新权重,验证选超参和早停,测试只评一次。用测试去选模型,测试就变成了第二验证,你不再有无偏的未来。
变电站至少要让测试段覆盖完整季节:只测春天,夏天的高温负荷没见过。验证段也尽量含一个完整小周期,否则早停会停在偶然波动上。样本少做不到“三段都含全年”时,用滚动划分多次评估,报告分布而不是一个点。
时间轴 → |---- 训练 ----|-- 验证 --|-- 测试 --| 未来 先切这三段,再在各段内部滑窗 窗口右端不得跨过段界去借点
图 合法划分对照非法打乱
二、固定切分对滚动切分
固定切分:例如前 70% 训练、接着 15% 验证、最后 15% 测试。实现简单,报告一个数字。风险是:测试段恰好碰到一次极端高温或一次设备故障,结论被单次事件绑架。
滚动(或走步)切分:多次把终点往前推,每次都用该终点之前训练、紧邻验证、再往后一小段测试。得到一串误差,能看模型在不同时期稳不稳。代价是训练次数翻倍,也更容易不小心让某次训练看见了另一次的测试。纪律是:每一次滚动的测试段,对该次而言都是未来,用完就封存。
SOURCE 说通常采用滑动窗口或固定窗口。滑动窗口在这里有两层含义:样本构造的滑窗,以及评估的滚动切分。两者都要“只向过去看”。
| 策略 | 优点 | 代价 | 适用 |
|---|---|---|---|
| 固定三段 | 简单、可复现 | 单次测试可能偏 | 序列长、季节完整 |
| 滚动多段 | 看到时期差异 | 算力、纪律 | 短序列或疑似漂移 |
| 先滑窗再随机抽 | 实现省事 | 必泄漏 | 不要用 |
| 净化间隔 | 减少边界相关 | 丢掉一些样本 | 强季节跨界时 |
净化间隔:训练段末尾和验证段开头之间丢掉一个窗口长度,避免两个窗口大量重叠却分属两套。不是人人需要,季节很强、窗口很长时值得对照一次。
三、泄漏体检清单
上线前我用五问:窗口是否跨段?缩放是否用了全局最大最小?已知未来协变量是否用了事后观测?滚动统计是否含目标未来?双向网络是否打开?五问有一个是,对照作废。
公交到站若按车辆 ID 随机分训练测试,看起来没打乱时间,但同一线路的未来班次可能因 ID 分到训练。分组也要按时间,不要按实体随机,除非你做的是跨线路迁移且信息集允许。
⚠️ 常见坑:交叉验证直接套用打乱式 K 折。时间序列要用沿时间的折,每一折的测试都在训练之后。
💡 关键直觉:划分是信息集的边界。越界的那几个点,足够让深度模型学会作弊。
四、滚动划分怎么避免自己泄漏自己
每次滚动,训练终点、验证终点、测试终点都要写进表。下一次滚动的训练可以包含上一次的测试吗?若你在做真正的走步评估,上一次测试已经变成历史,可以进训练,但那次测试数字已经冻结,不能因为模型更新了就改写旧报告。两套账:评估账只写当时发出的预测;研究账可以事后重训看“若当时有更多数据会怎样”,两账不许合成一张夸大的表。
固定切分的测试段要覆盖完整季节。只测春天,夏季高温全是分布外,深度可能显得很差,其实是没见过夏天——这应进 5.5 诊断,而不是据此淘汰整族。样本短到盖不住四季,用滚动多段,报告中位数和最差段,不要只报最好段。
按实体随机分(按变电站 ID、按线路)看起来没打乱时间,仍可能把同一时期的空间相关泄漏过去。若任务是预报某站未来,划分仍按时间。只有任务是“新站点冷启动、允许用同时期别的站”时,才按实体分,并在信息集里写明。SOURCE 的硬性是时间顺序;实体切分是额外的信息集声明,不是替代。
净化间隔是否启用,用对照说话:丢掉一个窗口长度的边界样本,验证指标若几乎不变,就不必永久丢掉那些点。季节极强、窗口很长时,边界重叠会让验证过于乐观,这时间隔值得留。
五、两套账:发出账与研究账
滚动之后,上一次测试已成历史,可以进下一次训练,但那次测试数字冻结,不许因模型更新改写旧报告。发出账只写当时预测;研究账可以事后重训看若有更多数据会怎样。两账合成一张表就是夸大。固定切分测试要覆盖完整季节,只测春天不能据此淘汰整族。按实体随机分可能泄漏同时期空间相关;预报某站未来仍按时间切。净化间隔用对照决定,指标几乎不变就不必永久丢点。SOURCE 硬性是时间顺序,实体切分只能当额外信息集声明。
六、泄漏五问上线前必做
窗口跨段?缩放用了全局最大最小?协变量用了事后观测?滚动统计含目标未来?双向打开?一问为是,对照作废。交叉验证要用沿时间的折,每一折测试都在训练之后。测试段尽量完整季节,否则结论锁在一个季节。滚动多段报告分布,不要只报最好段。按车辆 ID 随机分可能把同线路未来班次分进训练,分组也要按时间,除非任务是跨实体迁移且信息集允许。SOURCE:必须保持时间顺序,不能随机打乱。划分是信息集边界,越界几个点够让深度学会作弊。
问题:滚动评估能不能改写上一次的测试数字?
不能。上一次测试数字冻结。下一次训练可以包含那段已成历史的数据,但发出账与研究账分开。合成一张表会夸大。固定切分只测春天不能淘汰整族,夏天可能是分布外。按实体随机分会漏同时期空间相关。净化间隔用对照决定。泄漏五问写入脚本注释。时间序列交叉验证每一折测试在训练之后。SOURCE 禁止随机打乱。缩放统计量也只在训练段估,否则仍泄漏。越界几个点够让深度作弊,划分是信息集边界不是手续。
划分对照的法律是信息集边界。训练改权重,验证调参,测试只评一次。先切大段再滑窗,右端不越界。滚动时上一次测试数字冻结,即使那段数据后来进入下一次训练,发出账也不许改写。研究账可以事后重训,两账不得合成夸大表。测试尽量覆盖完整季节,只测春天不能据此淘汰整族。按实体随机分可能把同时期空间相关泄漏过去,预报某站未来仍按时间切。泄漏五问:跨段窗口、全局缩放、事后协变量、含未来的滚动、双向网络,一问为是对照作废。交叉验证每一折测试都在训练之后。缩放统计量只在训练段估计。越界几个点够让深度学会作弊,所以划分不是手续是边界。
把划分当成发预测时的法律文本。文本写清三段终点、滑窗是否段内、缩放 fit 范围、滚动时旧测试数字冻结、发出账与研究账分开。法律文本与权重同版本。泄漏五问写成断言,失败即停训。春天测试不能代表夏天,最差段要报。实体随机分要额外声明信息集。净化间隔用对照决定去留。交叉验证折必须时间有序。法律文本缺页,模型族比赛没有裁判。把文本读给不写代码的调度听,听得懂才算写清楚。听不懂通常是因为把打乱式表格习惯混进来了。SOURCE 禁止随机打乱这一句,应出现在法律文本第一行。越界点很少就能让深度作弊,所以边界要窄,不要靠事后良心。
法律文本要让调度听懂三段终点。听不懂往往是因为夹杂了打乱习惯。第一行写禁止随机打乱。断言失败停训,不要警告后继续。最差段与中位段一起报,避免只展示春天。版本号与权重同行。文本缺页就没有裁判,比赛作废。把听懂作为验收,比把文本写得很长更重要。
调度听懂三段终点,划分才算写清楚。听不懂就删掉打乱习惯,把禁止随机打乱放第一行。断言失败必须停训。最差段与中位段一起报。版本与权重同行。文本缺页没有裁判。验收是听懂,不是把法律文本写到没人读。越界很少的点就能让深度作弊,所以边界要窄。把听懂录音或会签留在评估包里,下一班才能接着守这条边界。
七、划分版本与切分卡版本同号
切分卡升到多步版本,划分若仍用单步窗口终点,测试段看起来合法,题目已经换了。两套版本号必须印在同一页眉。滚动发出账冻结的数字,也要标注对应的切分卡版本,否则后人会把点预测账和多步账画在一张趋势图上,误以为模型变差了。
要点速记
- 禁止随机打乱,SOURCE 硬性要求时间顺序
- 训练改权重、验证调参、测试只评一次
- 先切大段再滑窗,窗口右端不越界
- 固定切分简单,滚动切分能暴露漂移
- 缩放、协变量、滚动统计、双向,都是泄漏通道
- 测试段尽量覆盖完整季节,否则结论锁在一个季节里
下一节让损失函数跟输出形态对齐:点预测的 MSE 和区间的分位数损失,不是同一场比赛。