1.1 定义、分类与应用场景
1.1 定义、分类与应用场景
本节摘要:对话系统是什么、分几类、用在哪。本节给出对话系统的定义、三种主流分类(任务型、闲聊型、问答型)与典型应用场景,帮你判断"我要做的系统属于哪类"。
学习目标
阅读完本节,你应当能够:
- 给对话系统下定义
- 区分三类对话系统
- 说出典型应用场景
- 判断自己项目的类型
- 建立分类思维
一、问题与直觉
"聊天机器人和对话系统是一回事吗?"——对话系统是"让机器通过自然语言与人交互"的系统,聊天机器人是它的一个应用形态。核心分类看"目的":要完成任务(任务型)、要陪聊(闲聊型)、要答问题(问答型)。目的决定架构。
二、核心原理
2.1 三类对话系统
三类系统按"目的"区分,架构复杂度不同:
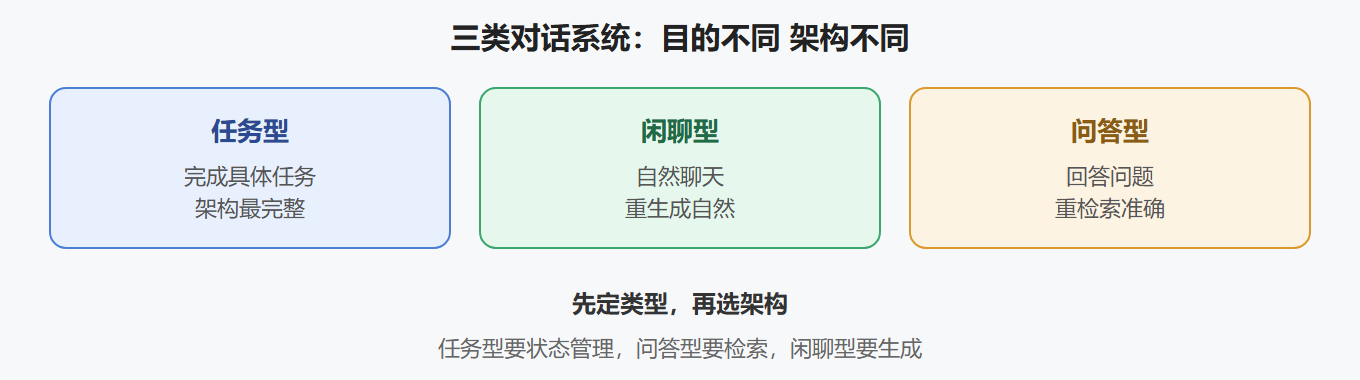
| 类型 | 目的 | 例子 |
|---|---|---|
| 任务型 | 完成具体任务 | 客服、订票 |
| 闲聊型 | 自然聊天 | 陪聊机器人 |
| 问答型 | 回答问题 | 知识问答 |
💡 关键直觉:类型决定架构复杂度——任务型要"管状态、调外部系统",闲聊型重"生成自然",问答型重"检索准确"。先定类型,再选技术。
2.2 应用场景
三、工程实践要点
3.1 项目类型自检
我的系统要完成什么目标? 用户会问什么类型的问题? 需要调用外部系统吗? 需要多轮对话吗?
⚠️ 常见误区:把问答系统当成全功能对话系统。问答型只需"检索-回答",任务型需要完整 NLU-DM-NLG——先想清楚需求,别过度设计。
3.2 场景速查
| 场景 | 关键能力 |
|---|---|
| 客服 | 意图识别 + 知识库 |
| 语音助手 | 语音 + 多轮 + 任务 |
| 问答 | 检索 + 生成 |
| 陪练 | 生成 + 角色 |
要点速记
- 要点一:对话系统 = 自然语言人机交互系统
- 要点二:三类——任务、闲聊、问答
- 要点三:类型决定架构复杂度
- 要点四:客服、语音助手、问答、陪练是典型场景
- 要点五:先定类型再选技术
- 要点六:别过度设计
定义清楚了,下一节看"内部构造"——核心构成模块。
深度扩展:三类系统怎么评估、怎么选型
"分类"不止是概念,它直接决定你用什么指标验收、用什么架构实现。下面展开三类系统的验收视角和工程选择。
任务型:核心验收指标是任务成功率与平均对话轮数。成功率指用户目标(订票、下单、查余额)最终达成的比例;轮数衡量效率——能两轮办完的事拖到五轮,说明流程设计有问题。工程上任务型需要完整的三段式架构:NLU 负责听懂意图与槽位,DM 负责记住进度、决定下一步动作,NLG 负责把决策变成人话,同时要接外部系统完成真实操作。它架构最重,但行为最可控、最容易用数据优化。
问答型:核心验收指标是答案准确率与覆盖率。实现上分两条路线:检索式(从知识库/文档里找到最相关片段返回,信息准、可溯源)和生成式(用大模型综合知识后生成答案,自然但可能"编造")。生产系统常用"检索优先 + 生成润色"的组合,把准确率放在第一位。
闲聊型:核心验收指标是回复的自然度与多样性。它没有明确"任务终点",评估主要靠人工打分或用户留存、对话长度等间接信号。实现上以生成式对话为主,难点是保持角色一致性、避免重复空洞。
选型时可以做一个"需求三分"自检:
1. 用户有明确目标吗? → 有 = 任务型,无 = 闲聊型 2. 答案以事实为准吗? → 是 = 问答型(检索优先) 3. 需要多轮和外部操作吗? → 是 = 任务型三段式
现实中很多系统是混合体:智能客服既能查政策(问答),也能办业务(任务),还能寒暄两句(闲聊)。理解分类不是为了贴标签,而是为了看清"这套系统最重的那根柱子是什么",从而把资源投到正确的地方。
动手练习:给三个产品分类
拿三个真实产品练分类判断:银行智能客服、手机语音助手、百科知识问答机器人。分别判断它们属于哪一类、以哪根"柱子"为主。银行客服以任务型为主(查账、办业务)兼有问答;语音助手是混合体(设闹钟是任务、闲聊是生成);百科问答以检索式问答为主。分类的意义在于决定先投入什么:银行客服先做意图与流程,语音助手先做生成质量与多轮,百科问答先做检索准确率与知识库建设。做完这个练习再回头看本节开头"先定类型,再选技术"这句话,体会会更深。