3.5 NLU 模型与技术
3.5 NLU 模型与技术
本节摘要:意图识别、槽位填充用什么实现?本节梳理 NLU 技术路线(规则、传统机器学习、深度学习、预训练模型、大模型)、各代的适用场景,以及"怎么选 NLU 技术"的决策思路。
阅读收获
阅读完本节,你应当能够:
- 说出 NLU 技术路线
- 对比各代技术
- 选择合适的技术
- 理解大模型的作用
- 规划 NLU 实现
一、问题与直觉
"NLU 用什么做?"——答案分几代:规则(关键词)、机器学习(统计分类)、深度学习(神经网络)、预训练模型(BERT 等)、大模型(少样本)。技术选择看"数据量 + 场景复杂度 + 成本"。
二、核心原理
技术选型看场景:
2.1 技术演进
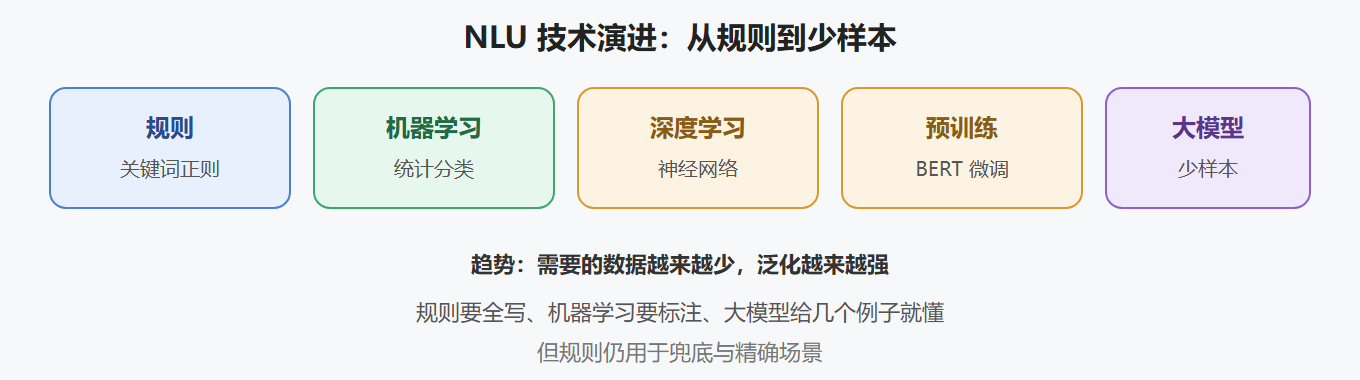
2.2 技术选型对比
| 技术 | 数据需求 | 泛化 | 成本 |
|---|---|---|---|
| 规则 | 无 | 差 | 低 |
| 机器学习 | 多标注 | 中 | 中 |
| 深度学习 | 中 | 好 | 中高 |
| 预训练 | 少 | 很好 | 高 |
| 大模型 | 极少 | 最好 | 高 |
三、工程实践要点
3.1 选型决策
小场景:规则够用 标准业务:预训练模型微调 冷启动/灵活:大模型少样本 混合:规则兜底 + 模型为主
💡 关键直觉:务实做法是"混搭"——大模型负责理解与泛化,规则负责精确与兜底。别迷信单一技术。
3.2 大模型的 NLU 用法
少样本:给几个例子,模型学会新意图 Few-shot 分类:提示词里带示例 抽取:让模型直接抽槽位
⚠️ 常见坑:大模型 NLU 的"幻觉"与延迟。少样本灵活但可能"自信地错"、响应慢——生产要置信度阈值与规则兜底。
要点串联
- 要点一:五代路线——规则到少样本
- 要点二:趋势是数据越来越少、泛化越强
- 要点三:选型看数据、场景、成本
- 要点四:务实做法是混搭
- 要点五:规则仍用于兜底与精确
- 要点六:大模型要配置信度与兜底
NLU 全部讲完,第 4 章进入"大脑"——对话管理 DM。
深度扩展:预训练模型微调的流程与"混搭"决策表
前文的选型对比讲了"数据少用规则、数据多用模型",这里把最主流的路线——预训练模型微调——的完整流程走一遍,并给一张可对照的决策表。
微调流程四步:准备数据(把话术整理成"文本 → 意图标签 / 序列标注"格式并划分训练/验证/测试集)→ 选基座(中文任务常用中文预训练模型)→ 训练与调参(关注学习率、epoch、早停,防过拟合)→ 评估与部署(用测试集看准确率/召回,低于阈值回补数据)。一个典型的时间分配:数据整理与清洗约占七成,真正训练只占三成——数据质量决定上限,模型只决定接近上限的程度。
微调 vs 大模型 Few-shot 的决策表
| 条件 | 选择 | 理由 |
|---|---|---|
| 数据多、意图标准、QPS 高 | 预训练微调 | 稳定、可控、单次推理便宜 |
| 冷启动、意图常变、规模小 | 大模型 Few-shot | 零训练、改提示即上线 |
| 话术固定、场景简单 | 规则 | 零成本、完全可控 |
| 合规要求高、需解释 | 规则/小模型 | 输出可审计 |
| 混合需求 | 规则 + 微调 + Few-shot 分层 | 各取其长 |
生产混搭样例:路由规则(闲聊直接走生成、任务意图走微调模型)、主干意图用微调分类器、长尾意图与新增槽位用大模型 Few-shot 兜底、所有结果经置信度校验——低置信走澄清或规则兜底。这套结构的好处是每一层的失败都有下一层接住,不至于让模型"自信地错"。
评估与迭代:线上要监控的不仅是准确率,还有低置信占比、澄清率、任务完成率等下游指标——NLU 改得"准"不代表对话"顺",最终以任务完成率为准。每次迭代遵循"线上错误样本 → 补标注 → 重训 → 回归"的闭环,NLU 就会越用越准。
动手练习:给一个场景做技术选型
把选型思路用到一个具体场景里检验一下:为一款"查询公积金余额"的小程序做 NLU,话术高度模板化("查余额""看看我公积金还有多少"),用户量不大但合规要求高。按前文的决策表,你会选哪条路线?合理的判断是:话术固定、合规要解释、量小 → 规则或小模型即可,不必上大模型。再对比一个反例:一个开放式的"旅游规划"助手,用户表达千变万化、意图清单会持续扩展 → 大模型 Few-shot 更合适。两个例子放在一起,你应该能体会到选型没有"最好的技术",只有"最匹配当前数据、场景、成本与合规约束的组合"。动手把你手头已知的一个产品需求按这个思路列一张对比表,选型能力就在这个过程中建立起来。