5.2 统计式与深度学习生成
5.2 统计式与深度学习生成(Seq2Seq、Transformer)
本节摘要:模板生成死板,深度学习生成"自然"。本节讲清 Seq2Seq 与 Transformer 的生成原理、训练数据形态、以及"自然但有风险"的平衡——什么时候用深度生成。
学习目标
阅读完本节,你应当能够:
- 理解 Seq2Seq 原理
- 理解 Transformer 生成
- 准备训练数据
- 控制生成质量
- 判断何时用深度生成
一、问题与直觉
"模板太死板,怎么生成得更自然?"——深度学习生成:用大量"对话-回复"数据训练模型,让模型自己学会怎么说人话。GPT 等大模型就是这个路线的极致。自然度高,但"胡说八道"的风险也高——可控性要额外手段补。
二、核心原理
深度生成的链路:
2.1 生成原理
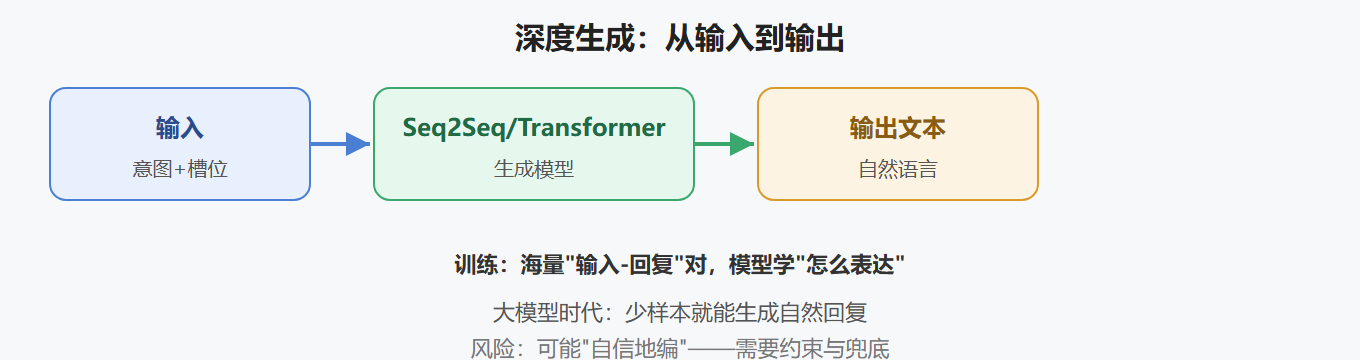
2.2 与模板的对比
| 维度 | 模板 | 深度生成 |
|---|---|---|
| 自然度 | 中 | 高 |
| 可控性 | 高 | 低 |
| 数据需求 | 无 | 多(或大模型) |
| 幻觉风险 | 无 | 有 |
三、工程实践要点
3.1 训练数据形态
输入:意图 + 槽位(或对话历史) 输出:标准回复 数据量:数千到数万对
💡 关键直觉:深度生成的"自然"靠数据,风险也靠数据——数据里的错误表达、不当内容,模型都会学走。数据质量是生成质量的根基。
3.2 控制生成质量
| 手段 | 做法 |
|---|---|
| 约束解码 | 关键词/格式约束 |
| 温度控制 | 低温度更稳 |
| 模板兜底 | 高风险场景回模板 |
| 内容审核 | 输出过滤 |
⚠️ 常见坑:全自由生成。大模型回复自然但可能跑题、编造、越界——重要场景用"模板骨架 + 模型润色"或"生成 + 审核"。
3.3 何时用深度生成
闲聊场景 → 深度生成(自然优先) 任务场景 → 模板为主(可控优先) 混合 → 骨架模板 + 局部生成
要点串联
- 要点一:深度生成 = 数据训练 + 模型生成
- 要点二:自然度高,幻觉风险高
- 要点三:数据质量是生成质量的根基
- 要点四:约束解码、温度、审核控制质量
- 要点五:任务场景模板优先
- 要点六:混搭是务实方案
生成会了,下一节提质量——文本多样性、流畅性与自然性。
深度扩展:自回归解码的生成流程与 BLEU 评估
深度生成模型(Seq2Seq、Transformer、大模型)都靠"自回归解码"产出一句话——逐个词地预测下一个词。理解这个流程,就理解了"为什么输出有随机性、为什么会有幻觉"。
自回归解码流程:模型接收输入(意图+槽位,或整段对话历史),把它编码成上下文向量,然后一个词一个词地生成:
输入: 意图=BOOK_FLIGHT, 槽位={date:明天, dest:上海} 生成第1词: P("明天"|上下文)=0.5 P("好的"|上下文)=0.3 → 采样选一个 生成第2词: P("我"|上下文,"明天")=0.4 ... → 继续 直到生成结束符,得到完整句子
解码策略影响输出:贪心解码(每次取概率最大的词)最稳定但可能单调重复;采样(按概率分布随机取)更有多样性但容易跑题;温度参数控制分布软硬——温度低趋近贪心,温度高更发散。这就是前文"低温度更稳、高温度更多样"的机制来源。
训练数据形态:训练时喂的是"输入 → 期望输出"的对子,数据质量直接决定生成质量。任务型对话的生成训练数据常组织为"结构化结果 → 标准话术":
输入: {action: confirm, slots: {date:明天, dest:上海}} 输出: "确认是明天出发去上海,对吗?"
如何评估生成质量:常用的自动指标是 BLEU——把生成句子与参考答案做 n-gram 重叠度计算,值越高代表越接近参考。但 BLEU 有硬伤:它奖励"逐字接近参考",而"说人话"本来允许多种表达,所以 BLEU 高分不等于自然。工程实践要"自动指标粗筛 + 人工评估把关":BLEU 用于回归监控(版本间别变差),自然度、准确性、一致性靠人工抽样打分。生成质量的上限由数据决定,下限由解码策略兜住——想自然,把训练数据做好;想可控,把解码约束加上。
动手练习:为生成写一份"兜底规则"
设计一套"生成 + 兜底"的规则,练习控制生成质量。场景:任务型对话的回复生成。请列出四类必须走模板(不走模型)的信息:金额、时间、订单号、账号;再列出允许模型发挥的部分:开场寒暄、结果总结。写完后为"模型输出跑偏"设计两条兜底:一是关键词/格式校验不过时回退到模板;二是敏感信息(金额等)无论模型怎么说,一律以结构化数据为准重新渲染。最后自测一句真实输出,检查其中每条数字是否都与结构化数据一致。这个练习的核心是体会"模板骨架 + 模型润色"到底怎么分工——所有不可错的信息交给模板,所有可自由的内容交给模型,这条原则能避免大多数生成事故。