5.4 语音合成(TTS)接口与应用
5.4 语音合成(TTS)接口与应用
本节摘要:语音交互是对话系统的自然延伸。本节讲清 TTS 的角色(文字变声音)、接入方式、语音质量维度(自然、韵律、情感)、以及"语音助手 = ASR + 对话系统 + TTS"的完整链路。
你能学到什么
阅读完本节,你应当能够:
- 理解 TTS 的作用
- 接入 TTS 接口
- 评估语音质量
- 理解语音助手链路
- 规划语音应用
一、问题与直觉
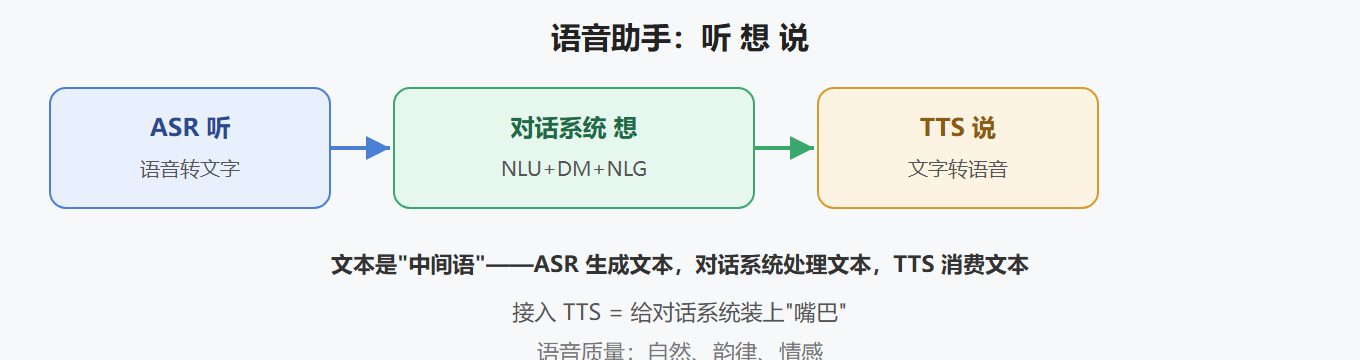
"对话系统怎么'开口说话'?"——靠 TTS(语音合成):把生成的文本变成声音播放。语音助手 = 听(ASR)+ 想(对话系统)+ 说(TTS)。TTS 是对话系统"出口的声音形态"。
二、核心原理
语音交互的完整链路:
2.1 语音助手链路
2.2 TTS 质量维度
| 维度 | 含义 |
|---|---|
| 自然度 | 像不像真人 |
| 韵律 | 停顿、语调 |
| 情感 | 语气情绪 |
💡 关键直觉:文本是"中间语"——语音助手全程处理文本,TTS 只在出口把文本变声音。接入 TTS 不改对话系统,只加"嘴巴"。
三、工程实践要点
3.1 接入 TTS(概念)
# 概念:NLG 输出文本 → TTS 转语音 → 播放 text = nlg_result # 对话系统的文本回复 audio = tts.synthesize(text) # 转语音 play(audio) # 播放
3.2 TTS 应用注意
| 注意 | 说明 |
|---|---|
| 延迟 | 语音交互实时性要求高 |
| 打断 | 支持随时插话 |
| 多音字 | 发音准确性 |
| 缓存 | 常用回复缓存语音 |
⚠️ 常见坑:忽略"可打断"。语音交互里用户随时会插话——不支持打断,体验像"对着音箱自言自语"。
3.3 语音场景判断
免手场景(开车、做饭)→ 语音合适 无障碍需求 → 语音合适 长文本阅读 → 文字更合适
要点速记
- 要点一:TTS = 文字变声音
- 要点二:语音助手 = ASR + 对话系统 + TTS
- 要点三:文本是中间语
- 要点四:质量看自然、韵律、情感
- 要点五:可打断是语音交互关键
- 要点六:按场景选文字或语音
五章全部收尾。回到导读页的章节地图——从"听懂(NLU)"到"想清(DM)"再到"说出(NLG)",你已握有对话系统的完整地图。选一个真实场景,动手设计并构建你的第一个对话系统。
深度扩展:TTS 技术路线与语音质量的工程把控
前文讲了 TTS 的接入与质量维度,这里补上技术路线的演变,以及接入语音场景时容易被忽略的工程细节。
TTS 的三代路线:
拼接式:从真人录音库里拼出语音片段 优点:自然、还原真人音色;缺点:需要海量录音,无法说新词 参数式:用声学模型预测频谱再合成 优点:灵活;缺点:早期音质机械感强 神经式(现代主流):端到端文本→语音(音色、韵律、情感都可控) 优点:自然度高、可定制音色;缺点:计算量较大
现代语音助手基本都走神经式 TTS,配合说话人建模还能做多音色、多情感。
语音交互的四个工程细节:一是延迟预算——语音交互对实时性要求高,TTS 前段缓存常用回复的语音结果,降低首次出声延迟;二是打断处理——用户随时插话,系统要能停止当前播报并进入聆听,做不好体验像"对音箱自言自语";三是多音字与数字读法——"重庆"的"重"、金额"10000"读"一万"还是"一万零",需要用规则或文本规范模块先处理;四是副语言信息——停顿、重音、语气词影响听感,神经式 TTS 可通过标注(情绪、语速)控制。
语音质量评估:客观指标有 MOS(平均意见得分,人工 1~5 打分)、字错率(合成语音转文字后与原文比对)。主观评估更要贴近场景:让真人听"免手场景"的实际播报,判断是否听得清、节奏是否自然、情绪是否匹配内容。最后做一个链路检查:ASR(用户→文字)→ 对话系统(文字→回复)→ TTS(回复→语音)全链路跑通并记录各段延迟,确保整体体验在可接受范围内。语音不是"加个喇叭",而是一条要独立优化的链路。
动手练习:设计一次"免手场景"播报
选一个具体的免手场景(比如车载导航询问"要不要切换路线"),设计一段完整的语音交互流程:ASR 收到用户语音 → 对话系统理解并决策 → TTS 播报确认话术。请写出播报话术并标出三点:这句话会不会太长(免手场景话术要短、信息量要够);关键信息(新路线时间差)是否靠重音或停顿强调;用户插话时系统能否中断播报。再设想一个边界情况:用户在嘈杂环境说了一句含噪音的话,ASR 转文字出错——此时对话系统该怎么兜底?合理的做法是像第 2 章错误处理讲的那样,触发一次简短澄清("您是说重新规划路线吗?")而非直接执行。把这条链路完整走一遍,你就能看到"语音不是加个喇叭"的真正含义。