3.2 策略优化
3.2 策略优化
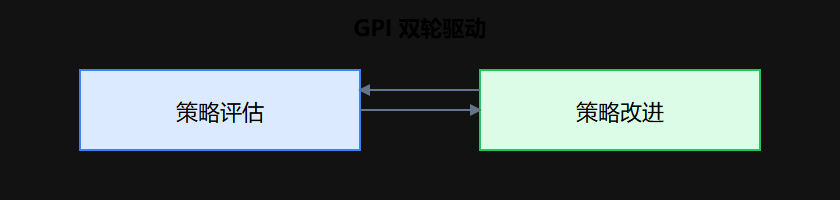
本节摘要:Control 目标:找最优 π* 最大化累积回报。策略迭代(评估→贪心改进)与价值迭代(直接迭代 Bellman 最优方程)。GPI 框架:评估与改进交替逼近最优。
本节导航
- 写出策略改进的贪心规则 argmax_a Q(s,a)
- 对比策略迭代与价值迭代
- 说明 GPI 中评估与改进如何协同
问题驱动
现象:策略评估收敛了,但回报仍低 → 可能卡在次优 π,需策略改进。
现象:已知 P,R 的小 MDP,表格法可精确解 → 用 Policy Iteration 或 Value Iteration。
策略迭代
- 初始化 π
- 策略评估:求 V^π(迭代至收敛)
- 策略改进:π'(s) = argmax_a Σ_{s'} P(s'|s,a)[R+γV^π(s')]
- 若 π'=π 则停,否则 π←π' 回到 2
价值迭代
直接迭代 Bellman 最优方程:
V_{k+1}(s) = max_a Σ_{s'} P(s'|s,a)[R + γ V_k(s')]
收敛后 π(s) = argmax_a Q(s,a)。每轮同时评估+改进,不需完整评估内循环。
| 算法 | 内层评估 | 典型场景 |
|---|---|---|
| 策略迭代 | 到收敛 | 评估便宜 |
| 价值迭代 | 一步 | 大状态空间 DP |
广义策略迭代 GPI
评估与改进持续交互,V 与 π 共同向最优逼近——Q-learning、SARSA 也是 GPI 实例(采样版)。
⚠️ 常见坑:改进用 V 但动作选择没取 max——策略迭代第二步必须用 Q 或上式 argmax。
💡 关键直觉:Control = Prediction + 贪心;无模型时 Q-learning 跳过显式 π 直接学 Q*。
一节小结
- Control 求 π*
- 策略迭代:评估↔改进至稳定
- 价值迭代:max Bellman 一步迭代
- GPI 统一框架
- 贪心改进:π(s)=argmax Q
深度扩展:策略迭代与价值迭代的分工与取舍
"评估 + 改进"反复交替能逼近最优策略,这是强化学习的统一思路(GPI)。但策略迭代和价值迭代在"评估做多彻底"上分道扬镳,这里把差别讲透,并给一个判断用哪个的场景清单。
策略迭代:评估做到收敛 → 再改进 优点:改进一步的"方向"更可靠 代价:每轮评估要迭代很多次(内循环贵) 价值迭代:只评估一步 → 就改进 优点:每轮便宜,收敛到最优价值后再解出策略 代价:前期改进方向粗糙
一个直觉类比:策略迭代像"先仔细量一次体温,再决定吃药量";价值迭代像"边量边调,每步只微调一点"。状态空间小、转移概率已知时,两者差别不大;状态空间大时,价值迭代通常更省(省掉了昂贵的内层完整评估);而策略迭代在"每轮评估成本低"的场景(比如有解析解或快速求值手段)更占优。
贪心改进为什么正确:策略改进定理告诉我们,只要新策略在每步都不差于旧策略的 Q 值,整体表现就不会变差。表格法里"对每个状态取 argmax_a Q(s,a)"就能保证这一点。这也是为什么无模型控制算法(Q-learning、SARSA)的改进都围绕"取 Q 最大的动作"展开——它们只是把这个定理放到了采样环境里执行。
GPI 的统一视角:把"评估"与"改进"看作两个咬合的齿轮,前者的输出喂给后者,后者的结果又改变前者要评估的对象。只要两个齿轮都在转,即使都做得不完美(评估没收敛、改进不彻底),整体仍在朝最优逼近——这个"不完美也进步"的性质是强化学习最优雅的地方,也是第 4 章里 MC/TD 控制算法能工作的理论根基。
控制场景的选择清单:小状态空间、已知模型 → 策略迭代或价值迭代都行(价值迭代实现更简单);大状态空间、已知模型 → 价值迭代;无模型 → 跳转第 4 章的 MC/TD 控制(Q-learning/SARSA),它们本质是 GPI 的采样版本——用经验样本代替精确期望。
动手练习:对比两种迭代的"轮数账"
用数值对比体会策略迭代与价值迭代的取舍。假设一个小 MDP 状态数为 20,策略评估每轮要迭代 50 次才收敛,控制需要 30 轮"评估+改进"循环——策略迭代的总内层迭代是 30×50=1500 次;而价值迭代每轮只做一步更新,大约 500 次迭代后价值收敛,之后再解一次策略。算这笔账后你会发现:价值迭代的总步数更少,但它的每次"一步更新"内部要对所有动作取 max(计算量略高);策略迭代总步数多,但每步是简单的期望求和。规模小、模型已知时两者差距可忽略;规模一大,"少做完整评估"的价值迭代通常胜出。
请再思考一个问题:如果每次策略评估不需要迭代到完全收敛、只做三轮就切去改进,会怎样?——这正是"部分策略评估"的思想,也是价值迭代的极端形式(只做一轮)。广义策略迭代(GPI)的核心结论就是:评估不用做完美,改进不用做彻底,两者交替推进仍能收敛到最优。理解了这个"不完美也进步"的性质,你再看 Q-learning 这类采样算法时,就不会纠结"它评估也没收敛、改进也不彻底,凭什么能工作"——它只是把 GPI 的宽容性用到了极致。