1.1 单体的病灶:三个可量化的指标
1.1 单体的病灶:三个可量化的指标
摘要:判断一个单体"病没病、病到什么程度",不能靠"感觉变乱"这种描述。本文给出三个可量化指标——耦合度、变更频率、故障半径,并把它们落成一张能直接勾选的体检清单。这是整套微服务决策的第一份病历。
说"我们的代码库很乱"是没用的,因为没人会承认自己负责的部分是乱源。真正有用的是把它变成能够指着某个具体证据说话的数字。我们围绕那台订单单体,逐个指标测一遍。
先问三句话,代替一句"该拆了"
- 改一个功能,要不要同时改三个模块?
- 每次上线,是不是所有模块一起上?
- 一个接口挂了,是不是整站跟着挂?
三个问题都是"是",这台单体基本可以确认病变;三个都是"否",那它可能只是"年龄大",不一定非动刀。麻烦的是大多数单体答出来是"一半是、一半否"。所以我们不能只看答案,要看背后的三个量化指标。
指标一:耦合度,看"牵一发动全身"有多重
耦合度不好直接度量,但有两个很好的代理:同一次提交改动的文件分布,和跨模块调用条数。前者看的是"一个需求要动几处地方",后者看"运行时要互相找多少次"。
拿 Git 提交历史做例子:统计最近 200 个 commit,看每个 commit 里有没有"订单"和"用户"的文件同时被改。如果这种"跨模块同改"的 commit 比例超过三成,说明订单和用户已经焊死在一块了。跨模块调用数我们稍后会在 1.3 节用一张调用图来画,现在先记住结论:调用越多、环越长,拆的时候越疼,因为它意味着切一刀要断很多根线。
指标二:变更频率,找"热点模块"
把代码库按目录分组,统计最近三个月每个模块的提交次数。高高低低太正常了,我们要找的是那个把其他模块都比下去的孤峰——通常就是业务频繁迭代或重构最凶的地方。
下面这段是我们给订单单体目录做热度统计的示意(按真实测量逻辑,去掉了无关的装饰):
# 统计最近 90 天每个模块的提交热度 # 输出: 模块名, 提交次数, 半衰期天数(最近一次提交距上次的天数中位数) hotspot --dirs ./order-module ./user-module ./payment-module \ --since 90d --format table
结果往往这样:订单模块每周都有十来次提交,用户模块一个月才动两三次,支付模块半年没动。热点模块就是最先要独立的 candidate——它迭代快、团队常改、代码最该自治;而半年不动的支付模块,现在拆它纯属给自己添乱。
指标三:故障半径,看一次故障的影响力
把最近一年的故障记录拿出来,看每一起故障影响到了哪些模块、波及了多少请求。单体最拧巴的地方就在这里:订单的 Redis 配置写错,结果登录也挂了,因为大家共享同一个运行时、同一份内存。
这条链就是"一损俱损"的机理:一个局部小故障,通过共享资源和同步调用逐步放大成整机雪崩。故障半径=1 意味着每次事故全站陪葬,这正是微服务想解决的。但请反过来想:如果你们的故障半径本来就只打到自己(比如模块之间本来就隔离得好),那微服务的最大卖点对你就没那么大吸引力。
一张可勾选的体检清单
把上面三个指标落成清单,团队开一次会就能拍板前两栏;数据能自动生成就填入第三栏。是"Yes"的行越多,倾向于动刀的证据越足。
| 体检项 | 问法 | 订单单体实录 |
|---|---|---|
| 耦合度·跨模块同改 | 单次提交同时动跨模块文件的占比 | 约 35%,偏高 |
| 变更频率·热点孤峰 | 是否存在远高于平均的模块 | 订单模块是孤峰 |
| 故障半径·全站陪葬 | 是否任一故障都会波及大部分请求 | 是,多次 |
| 部署节奏 | 是否必须整体构建整体上线 | 是,一次上全量 |
| 团队规模 | 一个代码库是否多人同时改 | 是,且常冲突 |
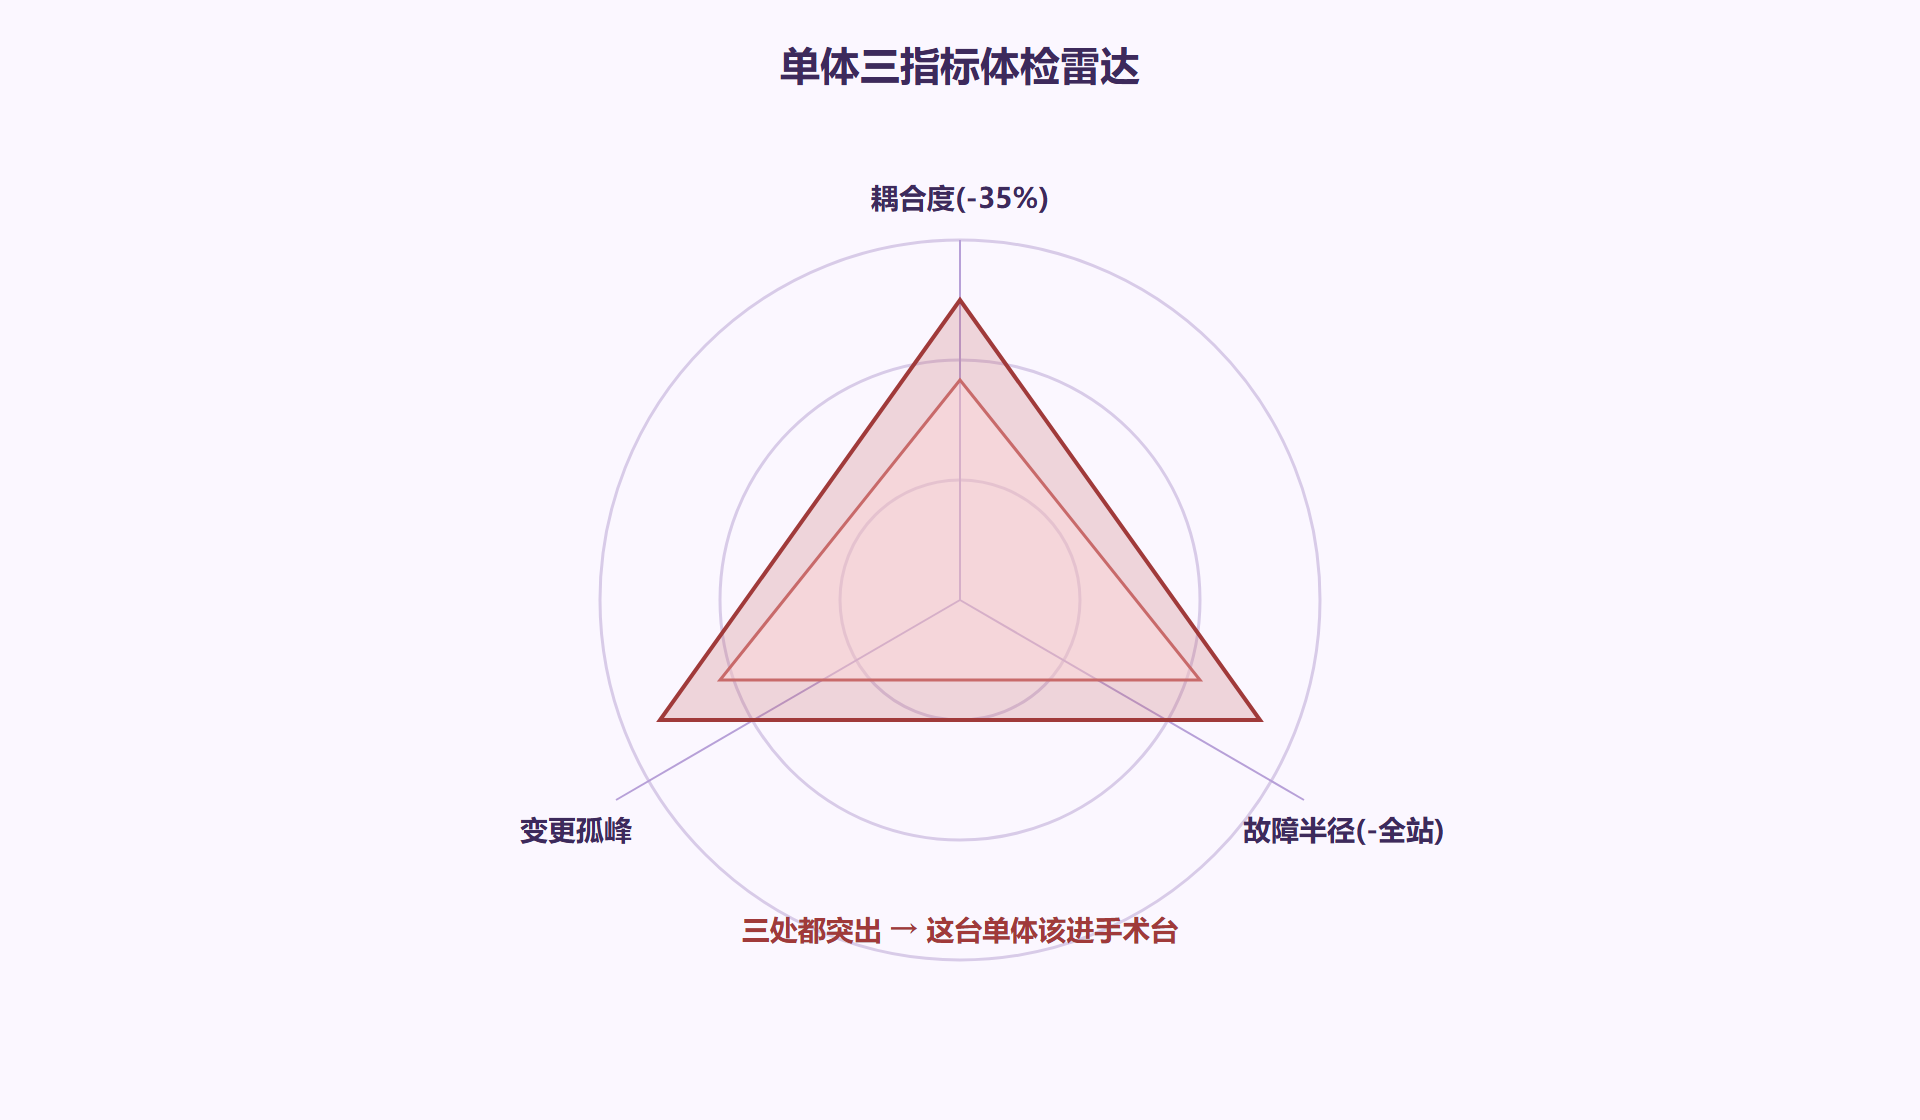
把三个指标画成一张雷达图,一眼就能判断"哪几个角突出、该不该动刀":
三指标体检雷达:突出即病灶
陷阱:把"老"当成"病"
最容易误判的是把"代码写得烂、缺测试、没人敢改"当成"单体的原罪"。这三样在微服务里一样会存在,而且分布到十几个服务后更难收拾。架构可以拆,技术债不会因为你拆了就消失。 所以本章 1.2 节把收益和代价摆在同一张桌上,正是要你在动手前想清楚:你买到的自由,是不是用你付得起的代价换来的。
三个指标怎么转成一句可以复述的诊断结论
量化的意义不仅是被"看着更像报名",更在于它给了你一句能对着团队复述的病历。试着把上面那套数据收拢成这样一段话:
"我们的订单单体,最近 90 天订单模块的热度是其他模块的约 6 倍,但它和用户模块的代码在最近 200 次提交里跨模块同改了约 35%;过去一年任何一次支付相关的故障都波及了整个应用。"
这句话一出口,不用再举例子、不用再争"到底哪乱"。三个数字把"哪里热、哪里焊死、坏起来多大面积"一次讲完。别小看这一步——大多数人讨论微服务时吵的是立场,而有量化数据的人吵的是边界。判断该拆谁、不该拆谁,靠的就是这些能指着说的数字。
反过来也要警惕一串整齐漂亮的数带来的错觉。这些指标反映的更多是"代码的组织形态"和"交付的节奏",它不能直接替你回答"值不值得拆"。例如耦合度高也可能只是代码规范差、模块化做得不好,拆不拆是后面 1.2 节算账的事。指标的作用是让病灶可见,不是让结论自动成立。
别让指标变成另一场"数字游戏"
指标一旦开跑,很容易被另一个东西带偏:追求数字好看。订单模块三个月改了九十次,是它真的需要频繁改,还是代码没沉淀好、每改一次都要重新踩一遍坑?耦合度从 35% 降到 20%,是你真把边界理清了,还是只是把改动藏进了更深的抽象里?数字不会自己撒谎,但它特别容易被"拿来证明一个既定的结论"。所以这道体检工序,最好由不背这个 KPI 的人来做——至少让数据在"要不要拆"这件事上中立地说话。它的本分是把病灶照出来,至于动不动刀、怎么动刀,是下一节要和成本一起摆上台面的账。
本节要点
-
三个指标都要落到"能指着说"的数字,才能让体检从吵架变成对线
-
耦合度看"跨模块同改比例"和"调用条数",越高拆起来越疼
-
变更频率找热点孤峰:迭代快、变更多、团队常碰的模块优先拆
-
故障半径看"一损俱损":共享资源加同步调用是雪崩的放大器
-
三个指标都能转成可勾选的体检清单,避免拍脑袋
-
技术债与架构无关:拆了不代表变干净