4.1 数据库每服务:切开数据源
4.1 数据库每服务:切开数据源
摘要:"数据库每服务"(Database per Service)是微服务数据策略的第一性原理:每个服务拥有并只拥有自己那份数据的写入权。本文讲清数据所有权的含义、为什么几乎必须这样做,以及切分时最难缠的三个陷阱——共享死库、跨库事务、和"我也想共享又怕共享"的中间态。
服务拆开了,数据库还在吗?很多团队的第一次尝试,是"服务拆了,表还共享"——每个服务照旧读写同一张订单表。结果是什么?第 2 章讲过的"共享表就是不自然的耦合"立刻在数据层面爆炸:两个服务各自偷偷改表结构,上线前才发现互相踩脚。微服务的数据策略,第一步就是回答"这份数据归谁"。
数据所有权:一份数据只有一个写主
"数据库每服务"不是一句口号,它定义的是数据所有权:每个服务是它所管数据的唯一写入者,别人想动它的数据,只能通过它的接口,不许直接写它的表。打个比方,订单库只属于订单服务,库存库里只有库存服务敢写;积分想读订单,得走订单服务的 API,而不是去打开订单库的 ddl 对着改。
数据拥有权带来的三个直接好处:可独立演化(改自己的表不影响别人)、可独立伸缩(各库各存各的磁盘/稀罕的读写比例)、故障隔离(一份库挂了只影响拥有它的服务)。这三条正好呼应对单体的诊断——它们都是把"共享"这个最大的耦合来源给断了根。
把"归谁所有"画成一条权责边界,比段落更清楚——同一张桌上,服务之间的数据只能靠 API 传,不能直接下手:
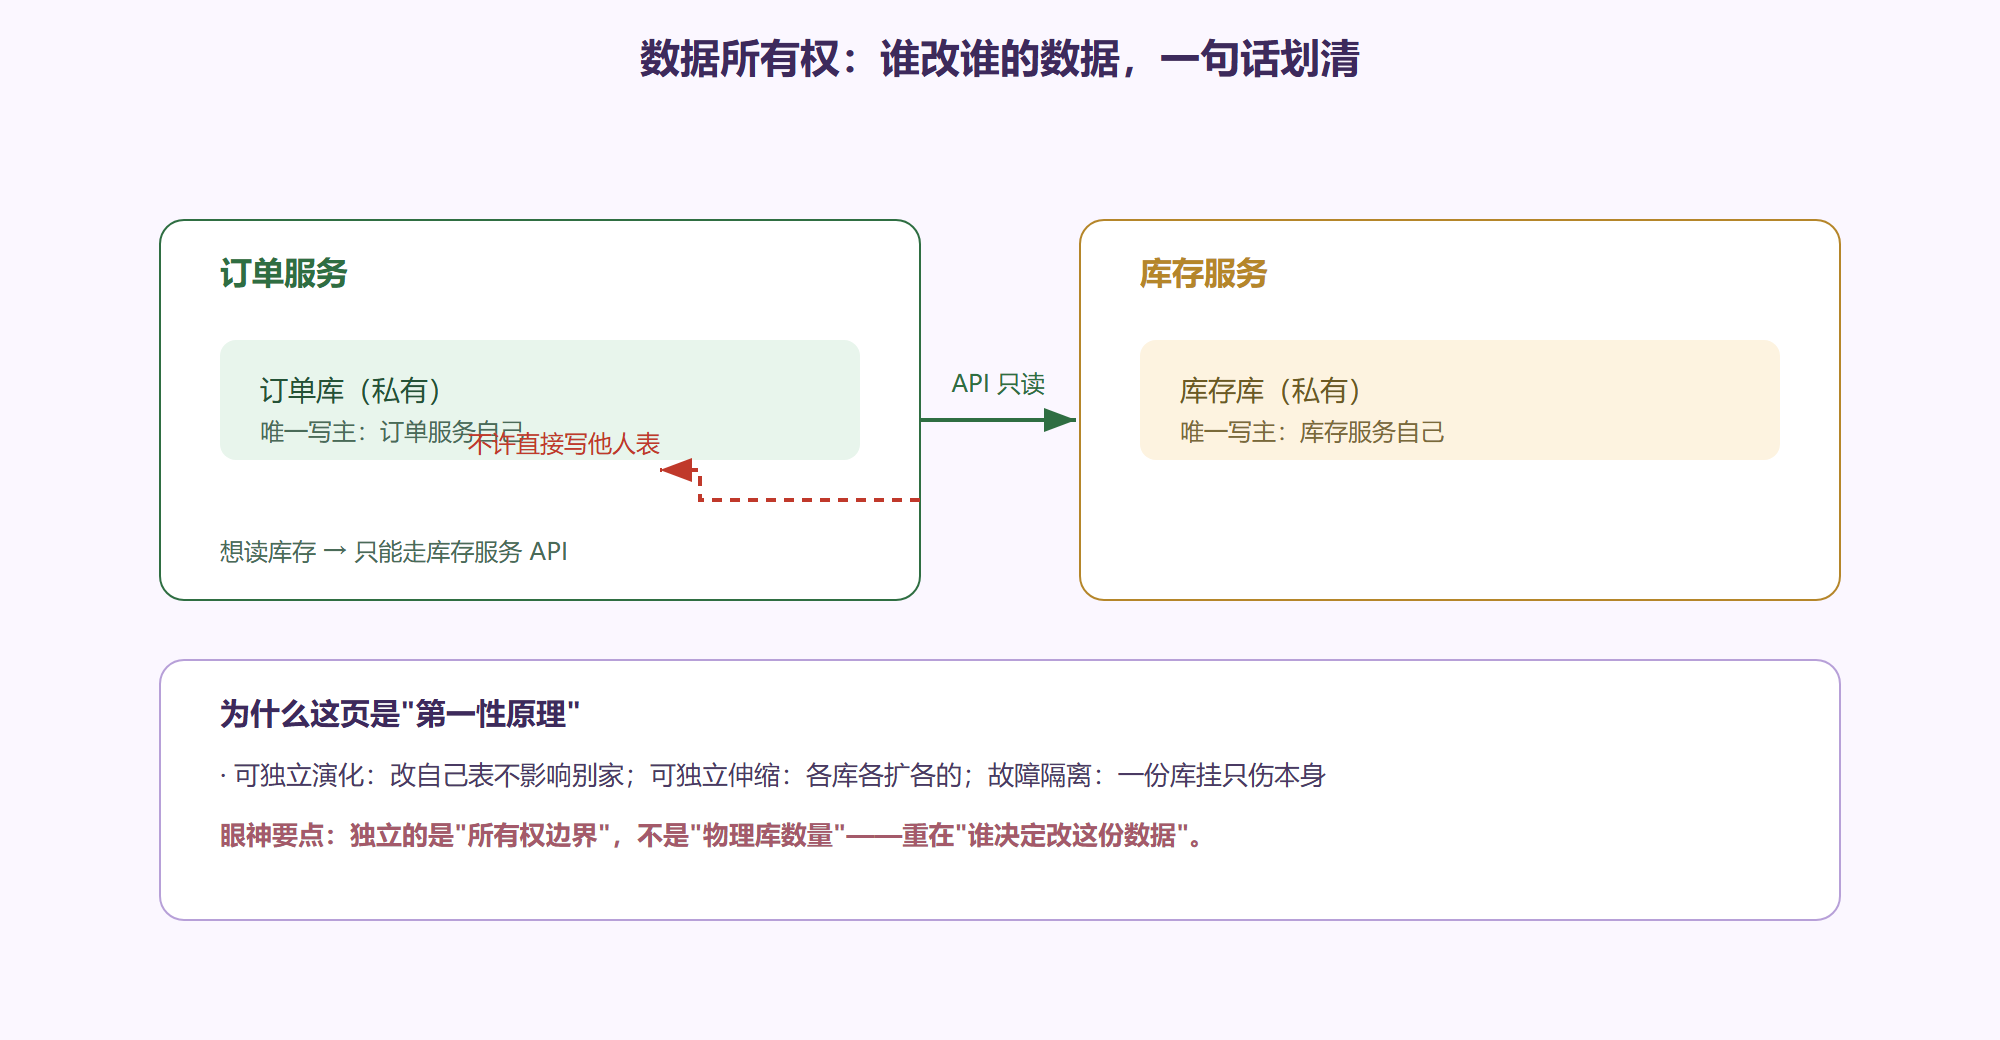
边界一旦画死,"共享表"这颗最毒的耦合就被从根上断了。
从"共享一张表"到"每人一张表",是一条必走的路
有人会问:我们只是内部系统,共用一个数据库会不会没事?
会没事,直到它出事。共享表的第一宗罪是隐式耦合:你根本无法保证两个服务不同时踩到表结构,一旦耦合,就违背了服务和表一起独立的初衷。第二宗罪是弹性失去意义:如果所有服务都读同一张库,你没法针对订单密集区单独扩库。第三宗罪是迁移时最难受:等业务复杂了再改所有权,成本是指数上升的。所以即便是中小内部系统,也建议尽早把"数据归谁"理清,而不是贪一时省事共用库。
切分时的三个真陷阱
划清边界不难,难在切的时候总有几个坑等着:
坑一:留着"共享死库"。表分了不少,但留下一个"大家都依赖的什么都要的杂库"(比如一个"配置库"“字典库”),谁都来写。它就是个没拆干净的共享表,会把拆分收益吃掉大半。正解:该库名正言顺地归一个服务所有,别人通过它的 API 读。
坑二:把"跨服务事务"当成本地事务写。习惯在单体里"一个事务里改订单又改库存"的工程师,在拆分后会条件反射地写一个跨两个库的事务。这在技术上未必直接报错,但会引入分布式事务的复杂度——强一致的代价我们都算过。正确的姿势放到下一节 4.2,用 Saga 的最终一致来接。
坑三:"我就看看,不写"就以为没耦合。只读共享也耦合。靠"我就顺手查一下别的服务的表"来办业务,等于把别的服务的数据复制了一份语义进自己脑子,对方改了表你全盲。哪怕只是读,也请走对方公开的只读接口,或者用 4.3 的只读副本。数据接触面越小,越安全。
一条实用提醒:别把"数据库每服务"极端化
有些团队走极端:一个服务一个库,甚至一个服务代码都能拆成一千个表一堆库,弄得迁移时开销巨大、跨服务查询成灾难。务实的中道是:独立的是"数据的所有权边界",而不是"物理库的数量"。满足"每个服务只写自己那份数据、不直连别人的库"这个语义,就可以成立;至于是物理上分几个实例、要不要共用一个连接池,可以按性能和容量灵活安排。重点在"谁决定改这份数据",不在"库拆得有多碎"。
一个更细的分工:连"写",也要分清"本服务写 + 跨服务写"
"数据库每服务"最常见的一句话误会,是把它当成"每个服务有一台数据库实例"——于是动辄几十个库,运维与迁移成本瞬间爆炸。请扣回我们第 2 章那句话:独立的是"数据所有权边界",不是"物理库的数量"。真正做到关键的,是每份数据有一个且只有一个"写主"(哪个服务有权直接改它),在语义上清晰,至于它是物理上各一套、还是共享一个连接池,属于性能与容量的选择。
落到"读"和"写"的细分工,有三个更值得记的口径:
- 本服务自己领域的数据,当然自己写——这是所有权的地基。
- 需要别的服务数据时,"读"走对方接口,或走 4.3 讲的只读副本,绝不直连对方库表。
- "写"别复制——如果两个服务都在改同一条业务记录,那说明这条记录的"写主"没定清,职责在打架,迟早数据错乱。这类"双写"往往是订单和库存、订单和支付之间最常见的混乱源,也正要用 4.2 的 Saga 去理清谁先谁后、谁补偿谁。
把"一份数据只有一个写主"这一条钉死,你就先从根上断掉了共享表那类最毒的耦合。至于"要不要为一个只有十个字段的配置服务单独起一个库",答案常常是"不必"——只要它的写主是唯一的,共享底层存储并不可耻,重点是语义上不互相改。
切开数据,先拆读、不急着拆写
"数据库每服务"最让人肾上腺素飙升的,是把写也彻底分家。但实操里最稳的开场常常是反过来的:先只拆"读",暂时不动"写"。理由很实际——读是只读、可以灰度切换、出错了回滚成本低;而写一旦拆开,跨库事务、双写对账、Saga 补偿全都得跟着上线,复杂度陡增。一个常见且稳妥的路径:先让一个服务通过只读副本接手某一块的读流量,观察稳定后再一点点把写主迁移过去。这样切分,每一步都小、都可回退,正好呼应第 1 章讲的绞杀者式创口——数据的所有权不必一次性切换,允许它像爬坡一样,一天比一天更侧重新服务。
本节要点
- 数据库每服务的核心是数据所有权:一份数据只有一个写主
- 独立性、弹性、故障隔离都来自"断了共享"这条根
- 共享表/共享库是最高危的未切净耦合,务必尽早理清归属
- 只读共享也是耦合,别用"我就查一下"搪塞
- 独立的是所有权边界而非库数量,别把"拆得碎"当成就