5.2 Kubernetes 编排:叫号排台与自我修复
5.2 Kubernetes 编排:叫号排台与自我修复
摘要:Docker 把服务打包好了,可几十个服务谁部署到哪、谁挂了谁顶上、流量怎么分发,还是没人管。Kubernetes 用"声明式期望状态 + 控制环路"把这一整套自动化。本文讲清它的核心心智模型,讲透它怎么自动调度、自我修复,也承认它极高门槛——什么时候才值得上。
Docker 照顾的是"一个服务一次运行",Kubernetes(下称 k8s)照顾的是"几十个服务在一个集群里排兵布阵"。没有它,你只靠脚本 docker run,迟早被几十面镜像、几百个容器的扩缩和故障搞得焦头烂额。k8s 就是把这些"调度与自愈"的脏活,变成一台自动叫号排台的机器。
心智模型:我只声明"想要什么",不吩咐"怎么做"
k8s 最反直觉、也最值得掌握的点是声明式:
- 你不说"把订单服务扩到 3 个实例、每个实例部署到 node2",而是说"订单服务期望有 3 个副本,端口 8080,镜像 v1.2"。
- 剩下的"放哪个节点、不够了怎么补、挂了怎么重启",全部交给 k8s 自己去凑齐。
它靠一套**控制环路(control loop)**实现:不断比对你声明的期望状态和集群当前实际状态,有差距就动手拉齐,把"自我修复"变成家常便饭。
这意味着一件事:k8s 是"状态收敛器"。你不用写"挂了就拉一个新的"这种脚本,你只需要保证期望状态没错,剩下的交给它。
最小名词表:Pod、Deployment、Service、自动伸缩
讲功能前先认人:
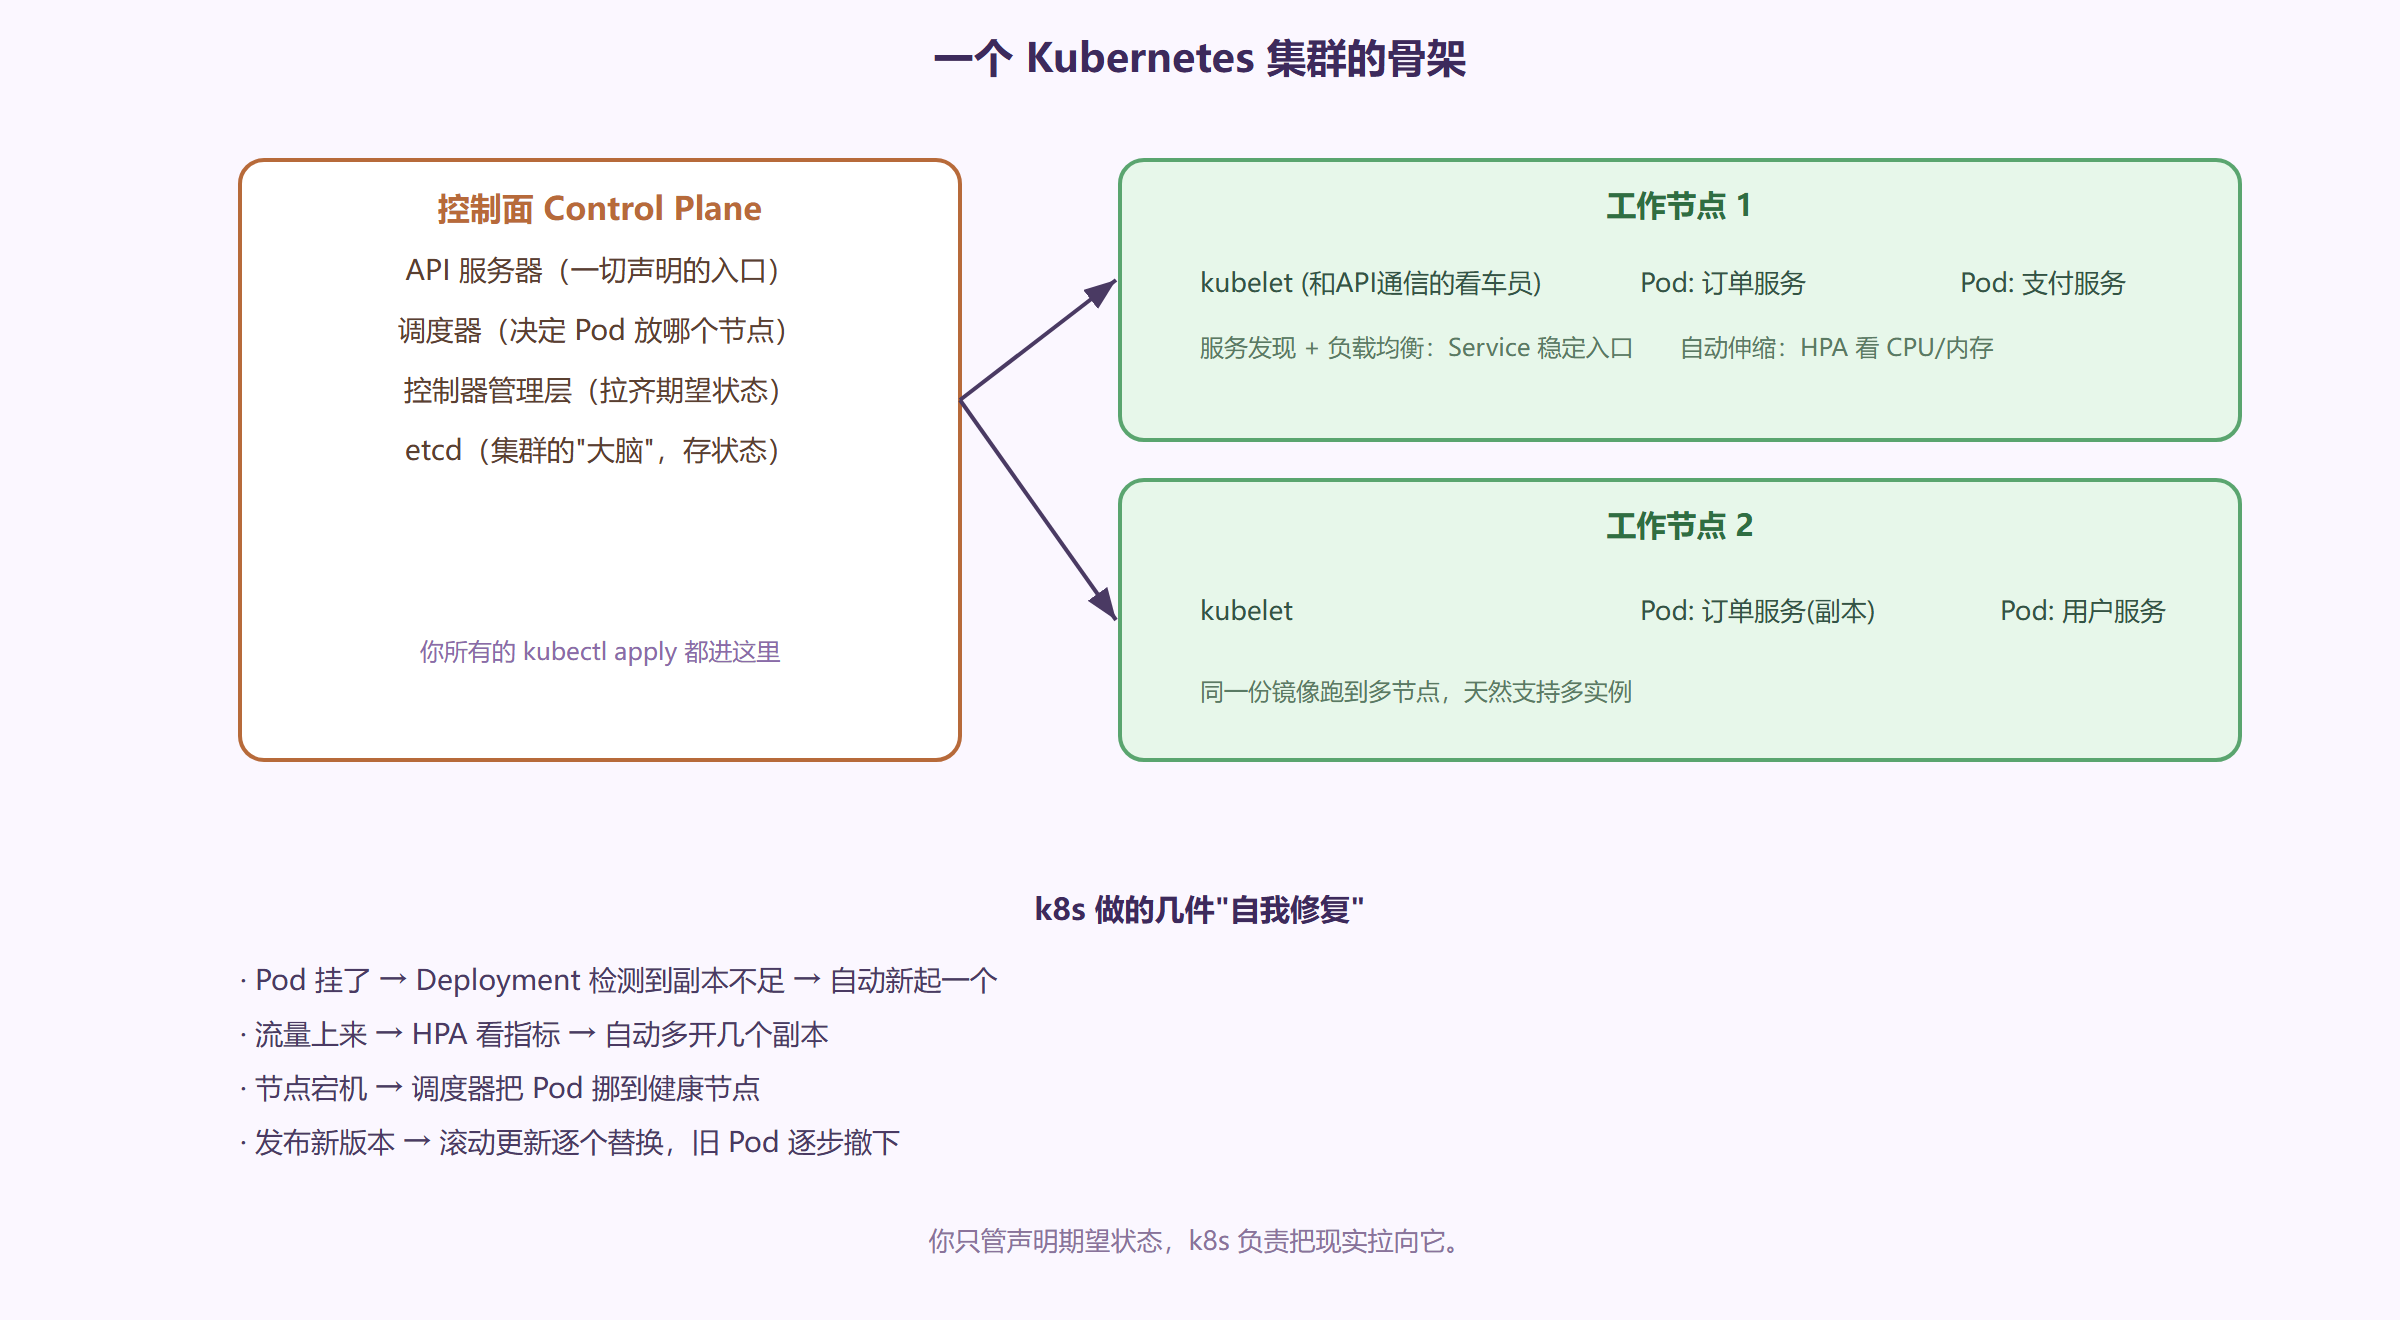
- Pod:k8s 里最小的调度单元,通常包一个(或极少数几个紧绑)容器,共享网络和存储。它才是"一个实例"。
- Deployment:声明"我要多少副本、用哪个镜像",负责无状态服务的扩缩与滚动更新——它是那份"期望状态"的载体。
- Service:给一组 Pod 一个稳定的入口和负载均衡,Pods 死了重建、IP 变来变去,Service 名不变。这也是我们在第 3 章讲"服务发现"时提到的"用平台自带发现最省心"的主角。
配合自动伸缩(HPA),k8s 能根据 CPU/内存这类指标自动增减副本:流量上来多开几个 Pod,下去了收回几个。
一张图看集群分工
从"叫号"看它的价值,也看它的门槛
k8s 一揽子解决了容器编排里最头疼的几件事——自动调度、自我修复、服务发现、自动伸缩、滚动发布。这是它成为事实标准的原因。
但它的代价同样浮出水面:概念多、门槛高、运维重。控制面本身要高可用,etcd 要会排障,网络、存储、安全一个个都要配。对一个只有几个服务的小团队,上一个 k8s 集群的成本往往比收益大得多。所以判断标准别含糊:
- 该上:服务多(如十几个起)、需要自动伸缩、多环境多团队协作、有专职的运维/平台人力。
- 别急:服务个位数、暂无伸缩需求、团队小、没有专门基建人力——先用便宜的容器部署 + 脚本顶住,等痛点真实出现再上。
很多"上了 k8s 后被折磨"的团队,不是 k8s 不好,是入场时机太早。这套道理和我们前面讲"别为了高级而 CQRS""别为潮流而拆服务"完全一致:先有真痛点,再选对工具。
陷阱:让 Pod 半死不活还不退出
k8s 的"自愈"依赖它能不能准确判断"你死了"。如果你通过 kubelet 探活(liveness probe)、就绪(readiness)这些探针配得稀里糊涂,k8s 可能把一个"卡死但进程还在"的旧 Pod 一直留着,流量照样打进去,那"自动重启"就成了摆设。一句话:卷子上的自愈能力,取决于你探针写得准不准。这是 k8s 使用里最常见也最隐蔽的一个坑。
卷与有状态服务:无状态之外的那块硬骨头
前面讲的 Pod、Deployment 都默认服务是"无状态"的——实例死了,换个新的重新起来即可,什么数据都不用担心。可现实里总有些数据需要")留"下来:数据库库文件、缓存持久化、文件上传。这就引出 k8s 里比"副本数"更难的一份:持久化存储。
方案大致分两级。第一级是卷(Volume / PersistentVolumeClaim):给 Pod 挂一块能留存的存储,Pod 重启、漂移到一个新节点,数据还能找回来。这是把"用完就丢"的容器,变成能托住有状态数据的地基。第二级是有状态工作负载(StatefulSet):当你要"有序启动、每个副本有稳定唯一标识、存储按副本单独持久"时——比如一套主从数据库、一个需要固定 ID 的队列——普通 Deployment 就摆不平了,才轮到 StatefulSet 出场。
要泼的冷水在这里:不要天真地以为 k8s 能替你把数据库集群管得天衣无缝。k8s 里"编排容器"很顺,但"运维真数据库(备份、主从切换、脑裂防控)"仍是运维的深水区。现实中很多团队把数据库这类的有状态服务放在 k8s 之外单独托管,只让无状态的业务服务进集群,先换来九成的好处,再随时间逐步探索有状态方案。先无状态进 k8s,再有状态者谨慎搬,是进来最稳的开局姿势。
一个推进顺序:别让 k8s 的"光环"赶在你之前
很多团队上一套 k8s,是被它"自愈、伸缩、高可用"的光环推着走的,结果仓促迁移、运维跟不上、事故频出。更稳的推进顺序是顺着痛点一格格走:先确认"真有几十个服务、真需要自动伸缩",再上编排;先把无状态业务迁进去,把探针、网络、存储这些地基一点点配稳,再往有状态和高级特性扩展。记住一个朴素的判断:k8s 是用来"养得起更多服务"的,不是用来"证明团队很先进"的。 如果你们现在连容器化、探针、镜像仓都没理顺,那最该补的不是 k8s,而是先把基础做扎实。工具的光环不解决痛点,只有匹配痛点的投入才不会变成新的包袱。
本节要点
- k8s 是声明式的"状态收敛器":声明期望,控制环路拉齐现实
- Pod=调度单元,Deployment=期望状态,Service=稳定入口+负载均衡
- 自动调度、自愈、服务发现、伸缩、滚动发布一次齐活
- 门槛高:概念多、控制面要高可用;小团队别急着上
- "能自愈"的前提是把 probe 探针配准,否则就是摆设