6.1 熔断器:对坏掉的调用直接短路
6.1 熔断器:对坏掉的调用直接短路
摘要:当下游服务已经开始故障,再往它身上持续发请求不仅没用,还会把故障放大。熔断器像家里的空气开关:故障率高就"跳闸",不再调下游,负载低了再试探恢复。本文讲清它的三态心智模型、失败率怎么触发、以及熔断时返回什么、恢复的节奏。
想想一个场景:支付服务开始超时,但你不知道,还在拼命往它身上打请求。结果每条下单都等它超时才失败,下单体验一落千丈,线程池还被越堆越多。更糟的是,这些请求还在加剧支付服务本身的过载,让修复更难。熔断器的价值就是:当你判断"这条路已经坏了",就干脆不再往里面送请求,把无效的存量工作刹住。
电路的三态:闭合、开路、半开
熔断器名字取自电路——断路器。它有三个状态,对应三种行为:
- 闭合(Closed):一切正常,请求照常流向下游。但它在悄悄统计失败率,一旦超过阈值,啪地切换。
- 开路(Open):判断下游坏了,此刻直接短路——请求不再到达下游,立刻返回"熔断中"的失败或降级结果。开路会持续一个冷却时间,给下游一点喘息和恢复机会。
- 半开(Half-open):冷却时间到,放几个"试探请求"过去看看下游缓过来没有。成功则回到闭合,失败则退回开路。
这套机构的精髓在于:它不试图去"修"下游,而是先把"让情况更糟"的节奏停下来。短路的那段时间,系统少做了大量必然失败的工作,等于给下游和整个依赖它的业务同时降了压。
一张图把三态的切换节奏收拢到一起,比文字更直白——看它是怎么"越玩越决绝"的:
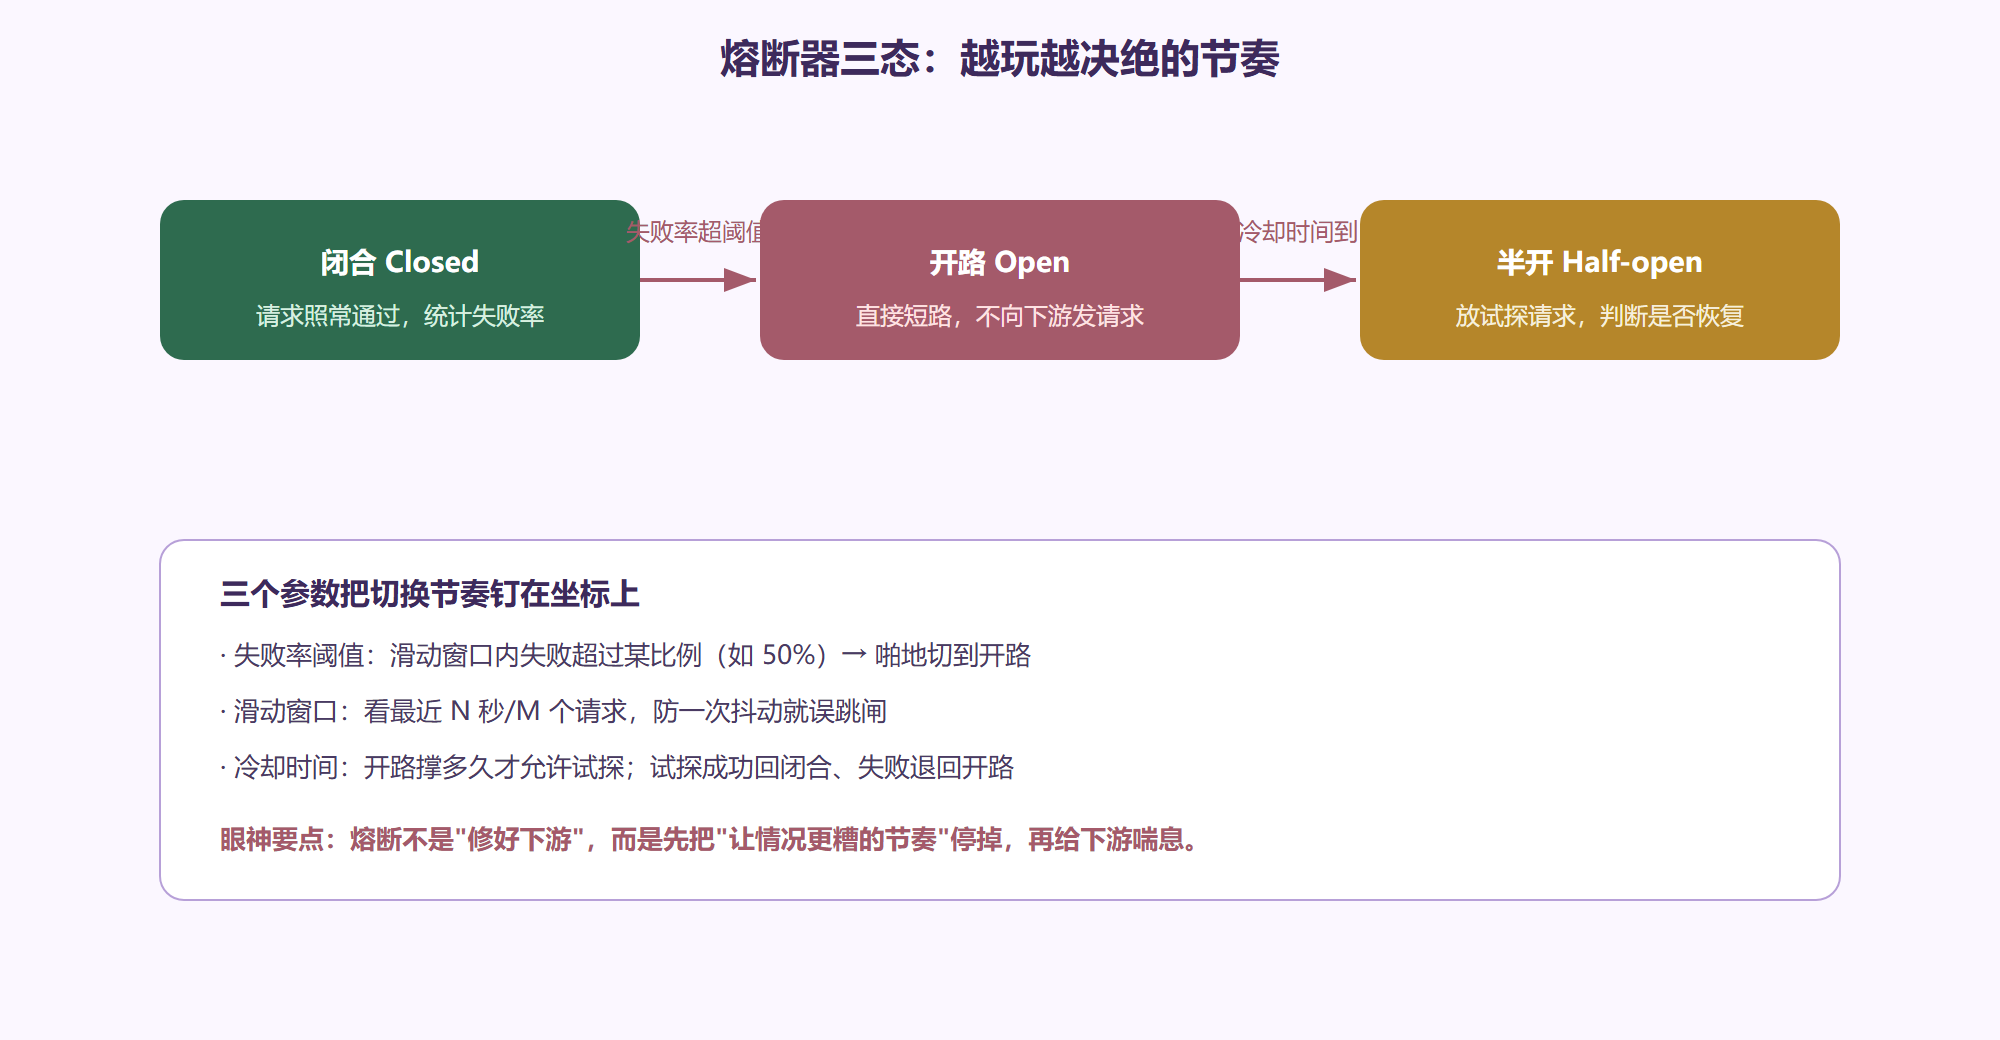
奥妙在它"越玩越往坏了想"的方向:起初正常(闭合),一旦证据确凿就翻脸短路(开路),给点缓冲后小心翼翼地试探(半开),试探不成马上又缩回去。
触发与恢复:阈值、窗口、冷却要一起调
熔断的开关由几个参数撑起来:
- 失败率阈值:比如滑动窗口内请求失败率超过 50%,就跳闸。
- 滑动窗口:统计最近 N 秒或最近 M 个请求,别被几次抖动就误熔断。
- 冷却时间:开路要撑多长时间再允许试探(比如几十秒)。
// 示意:熔断判定不进去实现细节,只表达"统计失败率"的意图 CircuitBreaker cb = new CircuitBreaker() .failureRateThreshold(50) // 失败率超 50% 开启 .slidingWindow(10, "SECONDS") // 看最近 10 秒的请求 .openState(duration = 30s) // 开路保持 30 秒后进半开 .permitHalfOpen(3); // 半开时放 3 个试探请求
三个参数是联动的:窗口太短会误伤(一次抖动就跳闸),冷却太短会让坏服务的试探后果乐此不疲,太长又让恢复变慢。落地时没有标准答案,要靠线上 P95/P99 和故障复盘反复调。
熔断时返回什么:别让短路变成"黑洞"
熔断要接的下游是"熔断后给调用方什么"。常见的四种:
- 快速失败:立刻返回"服务暂不可用",让主流程去兜(比如让下单显示"支付维护中")。
- 降级响应:返回一个静态的、可接受的"次一级"结果(第 6.2 讲降级)。
- 缓存兜底:返回上次成功的缓存结果,适合读接口。
- 排队/异步:把请求暂存,等下游恢复再处理。
关键不是"短路顺便什么都不给",而是给一个调用方"知道下一步该怎么办"的明确信号。那种"短路了但直接抛空指针给前端一坨 undefined"的,等于把熔断做成了新的故障源。
一处容易看漏的全局视角:熔断要和重试别打架
熔断与重试这对兄弟最容易互相坑——如果重试逻辑放在熔断外侧,而熔断已经判开路,你每个重试都会从已短路的熔断器里再打一遍;反过来若重试把已经熔断的下游又打回半开,就会把试探请求淹没在大量重试里。正确的分层是:先看熔断器开没开,开了就别重试,直接走降级;只有熔断器闭合、能正常通过时,才允许对合格外抖动做轻量重试。这两个机制的编排逻辑,很多线上事故恰恰栽在这。
陷阱:熔断器装了下游却不做"出口兜底"
装了熔断器只算装了一半。另一半是:熔断触发时,你的上层有没有对应的可用性预案? 如果没降级、没缓存、没提示,那熔断只是在"优雅地失败",用户体验依然是坏的,只是坏的层次更体面。故障有时候无法避免,但"怎么失败"是可以提前设计的——这正是"面向失败设计"要交的作业。
一个常被问到的分界:熔断和限流,到底谁管谁
熔断和限流看着都是"挡流量",其实分工完全不同,讲清楚能少走不少弯路。熔断保护的是"下游已经坏了,别再送请求",依据是失败率;限流保护的是"我自己快撑不住了,别再进请求",依据是每秒请求量。 一个看外部(你依赖的那家有没有坏),一个看自身(你的系统资源够不够)。
所以两者经常一起上,但触发机制和观察维度两码事:熔断是按结果(失败率高)触发的,限流是按输入(请求量超限)触发的。分不清这个,你会犯两种典型错——把限流设成"只要失败就往里多放"来帮熔断,或者把熔断设成"请求一多就短路",结果把正常增长也当故障误伤。结论:熔断看失败率、限流看请求量,各看各的,协作不混淆。
熔断参数开箱只是起点,麻烦永远在线上
框架自带的默认熔断参数能跑,但远不足以开箱即用——真正麻烦在线下。默认的失败率阈值、窗口大小、冷却时间,是针对平均服务调的,你的服务却有自己的脾气:有的偶发抖动多、有的真实故障率高、有的恢复慢。所以要先把观察口径打出来——用分位数和按调用来源、失败类型的维度,看现有流量在什么失败率下让体验劣化,再据此把参数调到该跳才跳、不至于误伤的档位。参数调完之后,熔断器的价值在运行中才真正显现——它不是装上去就一劳永逸的开关,是要和每次故障复盘一起,反复被校验和校准的器官。
本节要点
-
一条心法:熔断是"面向失败设计"里最值得先装的一味药,但记得给它配好"出口"
-
熔断器三态:闭合正常、开路短路、半开试探
-
开路时不再向下游发请求,给坏路和依赖它的业务同时降压
-
失败率阈值、滑动窗口、冷却时间三参数联动,要靠数据调
-
熔断要接"降级/缓存/快速失败",别让人手撕一堆 undefined
-
熔断与重试别打架:开路就不重试,直接降级