1.1 数学与统计基础
1.1 数学与统计基础
本节摘要:数学不是面试的门槛,而是讲清算法原理的语言。本节聚焦线性代数(矩阵分解、特征值、SVD)、概率统计(分布、贝叶斯、极大似然)、信息论(熵、交叉熵、KL 散度)这三块在机器学习里真正用到的工具,重点讲"用在哪、为什么用",而不是罗列公式。理解了交叉熵为什么是分类的标配损失、协方差矩阵为什么是 PCA 的核心,后面任何模型你都能快速归位。
学习目标
阅读完本节,你应当能够:
- 说清矩阵特征值分解与奇异值分解(SVD)的区别和各自用途
- 解释协方差矩阵为什么是 PCA 的核心,并推导 PCA 的降维步骤
- 用贝叶斯公式重新表述"模型从数据中学到参数"这件事
- 讲清极大似然估计与最大后验估计(MAP)的关系,并指出 L2 正则是 MAP 的特例
- 从熵出发推导交叉熵,解释它为什么适合做分类损失
- 说清 KL 散度的非对称性及其在变分推断、知识蒸馏里的角色
从一道面试真题说起
很多人准备数学部分的方式是"把公式背一遍",结果面试官一问"为什么分类用交叉熵不用均方误差"就卡住了。问题出在我们把数学当成了需要记忆的符号,而不是理解算法的语言。
真正的痛点是这样的:算法的本质都是在做某种"优化"——找一个参数让某个目标函数最小(或最大)。要理解这个优化过程为什么这么做,你必须知道目标函数从哪来。比如逻辑回归的交叉熵损失,它不是拍脑袋定的,而是从"假设标签服从伯努利分布,求使观测数据出现概率最大的参数"这个极大似然推导出来的。懂了这条链路,你才能回答"为什么不用均方误差"——因为均方误差对应的是高斯噪声假设,对分类问题的概率语义不成立。
所以本节不堆公式,而是把每个数学工具还原到它"被发明出来解决的问题"上。线性代数是描述数据变换的语言,概率统计是描述不确定性的语言,信息论是衡量分布差异的语言。三者合起来,就是机器学习的数学骨架。
二、核心原理
2.1 线性代数:数据与变换的语言
机器学习里的数据几乎都是矩阵:一张图片是三维张量,一个 batch 是四维张量,一段文本的词嵌入是二维矩阵。线性代数回答的核心问题是"这个矩阵有什么结构"。
特征值分解(EVD) 针对方阵 A,找到一组特征向量 v 和特征值 \lambda,使得 Av = \lambda v。几何意义是:矩阵作用在特征向量上只做拉伸,不改变方向。PCA 就是用这个——数据的协方差矩阵的特征向量就是主成分方向,特征值就是该方向上的方差大小。
奇异值分解(SVD) 是特征值分解对任意矩阵的推广:任意 m \times n 矩阵 A 都能分解成 A = U\Sigma V^T。它比 EVD 更通用,因为实际数据矩阵很少是方阵。推荐系统里的协同过滤、图像压缩、LSA(潜在语义分析)都用 SVD。PCA 也可以用 SVD 实现,而且数值上更稳定。
💡 关键直觉:PCA 和 SVD 做的事高度重合。对中心化后的数据矩阵做 SVD,右奇异向量就是主成分。工程上几乎都用 SVD 算 PCA,因为不用显式构造协方差矩阵,数值更稳。
向量范数 是衡量向量"大小"的工具,最常用的是 L1 范数(分量绝对值之和)和 L2 范数(欧氏长度)。它们在正则化里直接对应 L1/L2 正则,带来稀疏性 vs 平滑性的差异,这个在 1.2 节会展开。
2.2 概率统计:不确定性的语言
机器学习的本质是从有限数据推断背后的规律,这个推断过程必须用概率语言来描述,因为数据有限就意味着结论不确定。
贝叶斯公式 是这条线的核心:P(\theta|D) = \frac{P(D|\theta)P(\theta)}{P(D)}。它把"已知数据 D,参数 \theta 是多少"这件事拆成了三部分:似然 P(D|\theta)(这个参数下数据出现的概率)、先验 P(\theta)(数据之前我们对参数的信念)、后验 P(\theta|D)(数据之后更新的信念)。
这个公式重塑了我们对"学习"的理解。频率学派只认似然,认为参数是固定的未知量,用极大似然估计(MLE)找让数据出现概率最大的参数。贝叶斯学派引入先验,认为参数本身也是随机变量,用最大后验估计(MAP)找后验最大的参数。
💡 关键直觉:MAP 就是带正则化的 MLE。当先验是高斯分布时,MAP 等价于 L2 正则化的 MLE;当先验是拉普拉斯分布时,MAP 等价于 L1 正则化的 MLE。这条链路把"正则化"这个工程技巧和"贝叶斯先验"这个概率概念统一了起来。
常见分布 要记住几个:伯努利(二分类标签)、分类分布(多分类标签)、高斯(回归残差假设)、多项式(词频)。逻辑回归的交叉熵损失,就是假设标签服从伯努利分布、用 MLE 推出来的。
2.3 信息论:衡量差异的语言
信息论是衡量"信息和不确定性"的工具,在 ML 里主要用来度量两个概率分布的差异。
熵 H(p) = -\sum p_i \log p_i 描述分布 p 的不确定性。均匀分布熵最大(最不确定),确定性分布熵为零(完全确定)。
交叉熵 H(p, q) = -\sum p_i \log q_i 描述"用分布 q 编码来自分布 p 的数据"所需的平均位数。它和熵的关系是 H(p, q) = H(p) + D_{KL}(p||q),即交叉熵 = 真实熵 + KL 散度。
KL 散度 D_{KL}(p||q) = \sum p_i \log \frac{p_i}{q_i} 衡量两个分布的差异,永远非负,当且仅当 p=q 时为零。
这条链路解释了为什么分类用交叉熵:训练时真实分布 p 是固定的(标签的 one-hot),最小化交叉熵等价于最小化 KL 散度,也就是让模型预测分布 q 逼近真实分布 p。而且因为 H(p) 固定,最小化交叉熵和最小化 KL 散度的梯度完全一样。
| 损失函数 | 适用场景 | 隐含的概率假设 | 梯度特性 |
|---|---|---|---|
| 交叉熵 | 分类 | 标签服从伯努利/分类分布 | 预测错得越离谱梯度越大 |
| 均方误差 | 回归 | 残差服从高斯分布 | 梯度和预测误差线性 |
| 合页损失 | SVM | 间隔最大化 | 只对边界内的样本有梯度 |
| KL 散度 | 蒸馏/VLB | 让一分布逼近另一分布 | 对小概率事件敏感 |
三、工程实践要点
3.1 PCA 的实战步骤
把 PCA 从理论落到代码,步骤其实很机械,但要理解每一步在干什么。
import numpy as np def pca(X, k): # 1. 中心化:减去均值,让数据围绕原点 X_centered = X - X.mean(axis=0) # 2. 算协方差矩阵(特征数 x 特征数) cov = np.cov(X_centered, rowvar=False) # 3. 特征值分解,按特征值从大到小排 eigenvalues, eigenvectors = np.linalg.eigh(cov) idx = np.argsort(eigenvalues)[::-1][:k] # 4. 取前 k 个特征向量作为投影矩阵 W = eigenvectors[:, idx] # 5. 投影 return X_centered @ W
这里有个工程坑:如果特征数远大于样本数,协方差矩阵会很大且奇异,直接分解数值不稳。这种情况用 SVD 更好——对数据矩阵直接做 SVD,跳过协方差矩阵这一步。
⚠️ 常见坑:PCA 降维前一定要标准化。如果某个特征的量纲远大于其他特征(比如收入是万元级、年龄是个位数),协方差矩阵会被那个大特征主导,PCA 选出的主成分只是"方差最大的那个特征",而不是真正的数据结构方向。
3.2 正则化作为贝叶斯先验的实践意义
理解"正则化 = 先验"后,你在面对一个新问题时就能自己推导该用什么正则。比如你想让模型参数稀疏(特征选择),就引入拉普拉斯先验,等价于 L1 正则;想让参数平滑(避免过拟合),引入高斯先验,等价于 L2 正则。这不是死记,而是从需求反推。
| 先验类型 | 对应正则 | 参数性质 | 典型应用 |
|---|---|---|---|
| 高斯分布 | L2(权重衰减) | 小而密集 | 深度学习默认 |
| 拉普拉斯分布 | L1 | 稀疏 | 特征选择、Lasso |
| 无先验(均匀) | 无正则 | MLE | 数据充足时 |
3.3 交叉熵的数值稳定性
直接按公式写交叉熵 -\sum p_i \log q_i 会遇到数值问题:当 q_i 接近 0 时,\log q_i 趋于负无穷。工程上的标准做法是让模型输出 logits(未经 softmax 的原始分数),然后用带 log-sum-exp 技巧的稳定实现。
def stable_cross_entropy(logits, labels): # logits: 模型原始输出,未过 softmax # labels: 整数标签 log_sum_exp = np.log(np.sum(np.exp(logits - logits.max(axis=1, keepdims=True)))) + logits.max(axis=1) correct = logits[np.arange(len(labels)), labels] return np.mean(log_sum_exp - correct)
这里减去 logits.max 是 log-sum-exp 技巧的核心,它把指数运算的动态范围压下来,避免上溢。面试时能讲清这个技巧,说明你不是只会调 API。
本节要点回顾
- 线性代数的核心是矩阵分解:EVD 针对方阵、SVD 针对任意矩阵,PCA 推荐用 SVD 实现,数值更稳。
- 协方差矩阵是 PCA 的核心,特征向量是主成分方向,特征值是方差大小;降维前必须标准化。
- 贝叶斯公式重塑了"学习":MLE 只看似然,MAP 引入先验,先验是高斯等价 L2 正则、是拉普拉斯等价 L1 正则。
- 交叉熵是分类标配损失,因为它对应伯努利/分类分布的极大似然,且最小化它等价于最小化 KL 散度。
- KL 散度非对称,D_{KL}(p||q) \neq D_{KL}(q||p),这在变分推断和知识蒸馏里要特别注意方向。
- 信息论的熵、交叉熵、KL 散度是一条链:交叉熵 = 熵 + KL 散度,理解这条链就理解了为什么分类用交叉熵。
下一节我们进入经典 ML 算法,看偏差方差、过拟合、正则化这些概念如何在 SVM、决策树、集成学习里具体落地。
四、数学概念的面试追问链
数学部分的面试题很少直接考计算,考的是"你能不能把数学和机器学习现象连起来"。这里整理几条高频追问链,每条都从第一问出发,模拟面试官会怎么往下挖。
第一条链围绕特征值分解展开。第一问通常是"特征值和特征向量的几何意义是什么",标准答案是"矩阵乘法在这个方向上只做伸缩不改变方向,伸缩比例就是特征值"。但真正拉开差距的是第二问:"PCA 为什么和特征值有关?"答案的因果链是:PCA 要找投影后方差最大的方向,而投影方差等于数据协方差矩阵的特征值,所以主成分就是协方差矩阵特征值最大的前 k 个特征向量。第三问可能接着挖:"协方差矩阵为什么是半正定的?"——因为对任意向量,二次型等于投影方差,方差非负。能一路答到第三问的候选人,数学院这一关基本稳了。
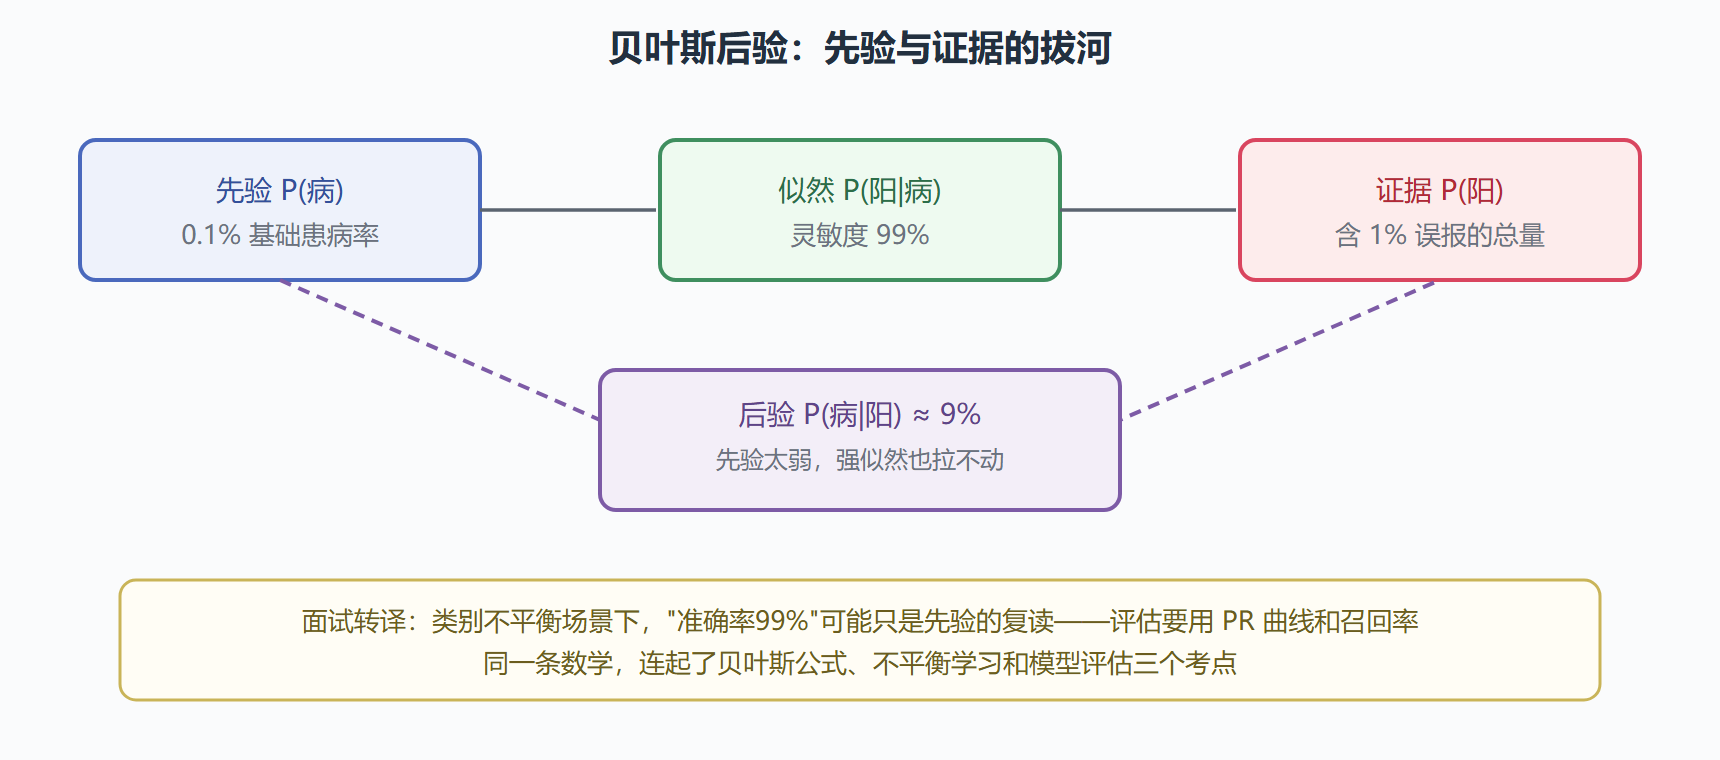
第二条链围绕条件概率和贝叶斯。表面考公式,实际考"先验和似然谁说了算"。一个经典场景:某疾病患病率千分之一,检测准确率 99%,检测阳性后真实患病概率是多少?答案是约 9%。这道题的本质是:当先验极小时,即使似然很强,后验也上不去。这解释了为什么类别极不平衡时,"准确率 99%"的模型可能毫无价值——多数类先验太强了。
第三条链考采样和中心极限定理。为什么 bootstrap 有效?因为经验分布是真实分布的渐进无偏估计,有放回重采样相当于从经验分布里抽新样本。为什么随机森林要 bagging?因为对不稳定的学习器做平均能显著降方差,而决策树恰恰极不稳定。注意这条链的最后一步:它同时回答了第 2 节集成学习的"为什么",数学和算法在这里合流了。
准备这部分时,不要背公式推导的每一步,把力气花在"每个数学工具对应机器学习里的哪个现象"上。面试官真正想确认的是:你看到算法行为异常时,能不能退回到数学层面找原因。