1.3 深度学习基础
1.3 深度学习基础
本节摘要:深度学习把"特征工程"自动化了,代价是要训练一个可微分的大函数。本节把这个训练过程拆成四块积木:前向传播算损失、反向传播算梯度、优化器更新参数、归一化与正则稳住训练。再讲清 CNN(卷积)、RNN(时序)、Transformer(自注意力)三大架构各自针对什么问题设计。读完你会理解为什么 ResNet 要用残差连接、为什么 LSTM 能缓解梯度消失、为什么 Transformer 能并行——这些都是 CV 和 NLP 章节的共同地基。
学习目标
阅读完本节,你应当能够:
- 在白板上推演反向传播的链式法则,解释梯度消失和梯度爆炸的成因
- 对比 Sigmoid、ReLU、Leaky ReLU、GELU 的优缺点,说清为什么 ReLU 成为主流
- 讲清 BatchNorm 在训练和推理时的行为差异,以及为什么它对 batch size 敏感
- 对比 SGD、Momentum、Adam 的更新机制,解释 Adam 的偏差校正
- 说清 CNN 卷积层的参数共享和局部连接为什么适合处理图像
- 解释 LSTM 三个门的作用,以及它如何缓解朴素 RNN 的梯度消失
- 从 Self-Attention 出发推演 Transformer,说清它为什么能并行训练
一、问题与直觉
传统机器学习的痛点是"特征工程"——你得手动设计特征(比如 HOG、SIFT),特征好不好直接决定模型上限。这件事极其依赖领域知识,且无法端到端优化。深度学习的突破在于:用一个可微分的深度函数,让模型自己从原始数据学特征,所有参数一起用梯度下降优化。
但"可微分"这件事一旦做深,立刻遇到两个工程难题。第一,网络变深后梯度怎么传——链式法则连乘几十层,要么梯度消失(参数不更新),要么梯度爆炸(参数乱跳)。第二,不同层的输入分布会随训练漂移,让后面的层无所适从。整个深度学习工程化的历史,就是围绕这两个难题打补丁:激活函数换 ReLU 解决梯度消失的一部分、BatchNorm 稳住分布、残差连接让梯度直接回传、优化器用自适应学习率。
所以本节的组织逻辑是:先把"前向算损失、反向传梯度、优化器更新"这个闭环讲透,再看每个积木解决闭环里的哪个痛点。CNN、RNN、Transformer 是这个闭环在不同数据结构上的特化——CNN 处理空间局部性、RNN 处理时序依赖、Transformer 用注意力绕开时序串行。三者共享同一套训练机制。
二、核心原理
2.1 反向传播:链式法则的工业化
前向传播是数据从输入流到输出,算出损失。反向传播是把损失对每个参数的梯度,从输出倒着算回输入。它依赖的就是链式法则:复合函数的导数等于各层导数的乘积。
反向传播的工业实现依赖计算图:把前向过程建成一个有向无环图,每个节点是一个运算,每个运算预先注册自己的局部导数。反向时按拓扑序倒着遍历,把局部导数连乘起来。PyTorch 的自动求导就是这个机制。
梯度消失和梯度爆炸的根源就在"连乘"。假设每层导数的典型值是 \gamma,L 层网络的梯度约为 \gamma^L。\gamma < 1 时指数衰减(消失),\gamma > 1 时指数爆炸。Sigmoid 的导数最大是 0.25,深网络里用 Sigmoid 必然梯度消失。
2.2 激活函数:从 Sigmoid 到 ReLU
激活函数给网络引入非线性。没有非线性,多层线性层等价于一层。
| 激活函数 | 公式 | 优点 | 缺点 |
|---|---|---|---|
| Sigmoid | \frac{1}{1+e^{-x}} | 输出在 (0,1),可解释为概率 | 导数最大 0.25,深网络梯度消失;非零中心 |
| Tanh | \frac{e^x-e^{-x}}{e^x+e^{-x}} | 零中心,比 Sigmoid 收敛快 | 仍有饱和区 |
| ReLU | \max(0, x) | 计算快、不饱和、缓解梯度消失 | 负区神经元死亡 |
| Leaky ReLU | \max(0.01x, x) | 解决死亡 ReLU | 多一个超参 |
| GELU | x \cdot \Phi(x) | 光滑、Transformer 默认 | 计算稍复杂 |
💡 关键直觉:ReLU 成为深度学习主流不是因为它"更强",而是因为它简单——正区导数为 1,梯度能无损回传,负区导数为 0 直接截断。这种稀疏激活反而让网络学到了稀疏表示。死亡 ReLU 是它唯一的硬伤,Leaky ReLU 和 GELU 是两种修补方向。
2.3 归一化:稳住训练
BatchNorm 把每个 mini-batch 的激活值标准化为零均值单位方差,再用两个可学习参数 \gamma, \beta 做仿射变换。它的核心洞察是:随着训练进行,前面层的参数更新会让后面层的输入分布漂移(内部协变量偏移),BatchNorm 把这个漂移压住,让每层的输入分布稳定。
⚠️ 常见坑:BatchNorm 在训练和推理时行为不同。训练时用当前 batch 的统计量,推理时用训练期累计的滑动平均。这意味着 BatchNorm 对 batch size 敏感——batch 太小,统计量不准,训练会抖。这就是为什么很多小 batch 场景(如目标检测)改用 GroupNorm 或 LayerNorm。
LayerNorm 对单个样本的所有特征做归一化,不依赖 batch,所以 Transformer 和 RNN 都用它。InstanceNorm 对单张图片单通道归一化,用于风格迁移。
2.4 优化器:从 SGD 到 Adam
优化器的核心问题:怎么用梯度更新参数。SGD 是最简单的——梯度和学习率的乘积。但 SGD 在鞍点附近会卡住,且对所有参数用同一学习率。
| 优化器 | 更新机制 | 特点 |
|---|---|---|
| SGD | w \leftarrow w - \eta g | 最简单,调好能收敛到更优解 |
| Momentum | v \leftarrow \beta v + g,w \leftarrow w - \eta v | 累积动量冲过鞍点 |
| Adagrad | 累积平方梯度做分母 | 自适应学习率,但累积过多最终不更新 |
| RMSprop | 指数滑动平均平方梯度 | 解决 Adagrad 不更新问题 |
| Adam | Momentum + RMSprop | 一阶二阶矩都估计,主流默认 |
Adam 的精髓是把动量(一阶矩的滑动平均)和自适应学习率(二阶矩的滑动平均)结合,并对初始阶段做偏差校正(因为初始的滑动平均偏向零)。
class SimpleAdam: def __init__(self, params, lr=1e-3, beta1=0.9, beta2=0.999, eps=1e-8): self.params = params self.lr, self.b1, self.b2, self.eps = lr, beta1, beta2, eps self.m = [0] * len(params) # 一阶矩 self.v = [0] * len(params) # 二阶矩 self.t = 0 def step(self, grads): self.t += 1 for i, (p, g) in enumerate(zip(self.params, grads)): self.m[i] = self.b1 * self.m[i] + (1 - self.b1) * g self.v[i] = self.b2 * self.v[i] + (1 - self.b2) * g * g m_hat = self.m[i] / (1 - self.b1 ** self.t) # 偏差校正 v_hat = self.v[i] / (1 - self.b2 ** self.t) self.params[i] = p - self.lr * m_hat / (v_hat ** 0.5 + self.eps)
💡 关键直觉:Adam 是默认选择,但 SGD + Momentum 在图像任务上常能收敛到更优的极小值(更好的泛化)。这不是玄学——自适应学习率让 Adam 容易陷入"宽而浅"的解,而 SGD 走的是"窄而深"的解。需要 SOTA 泛化时可以试 SGD,工程上追求快速收敛就用 Adam。
2.5 三大架构积木
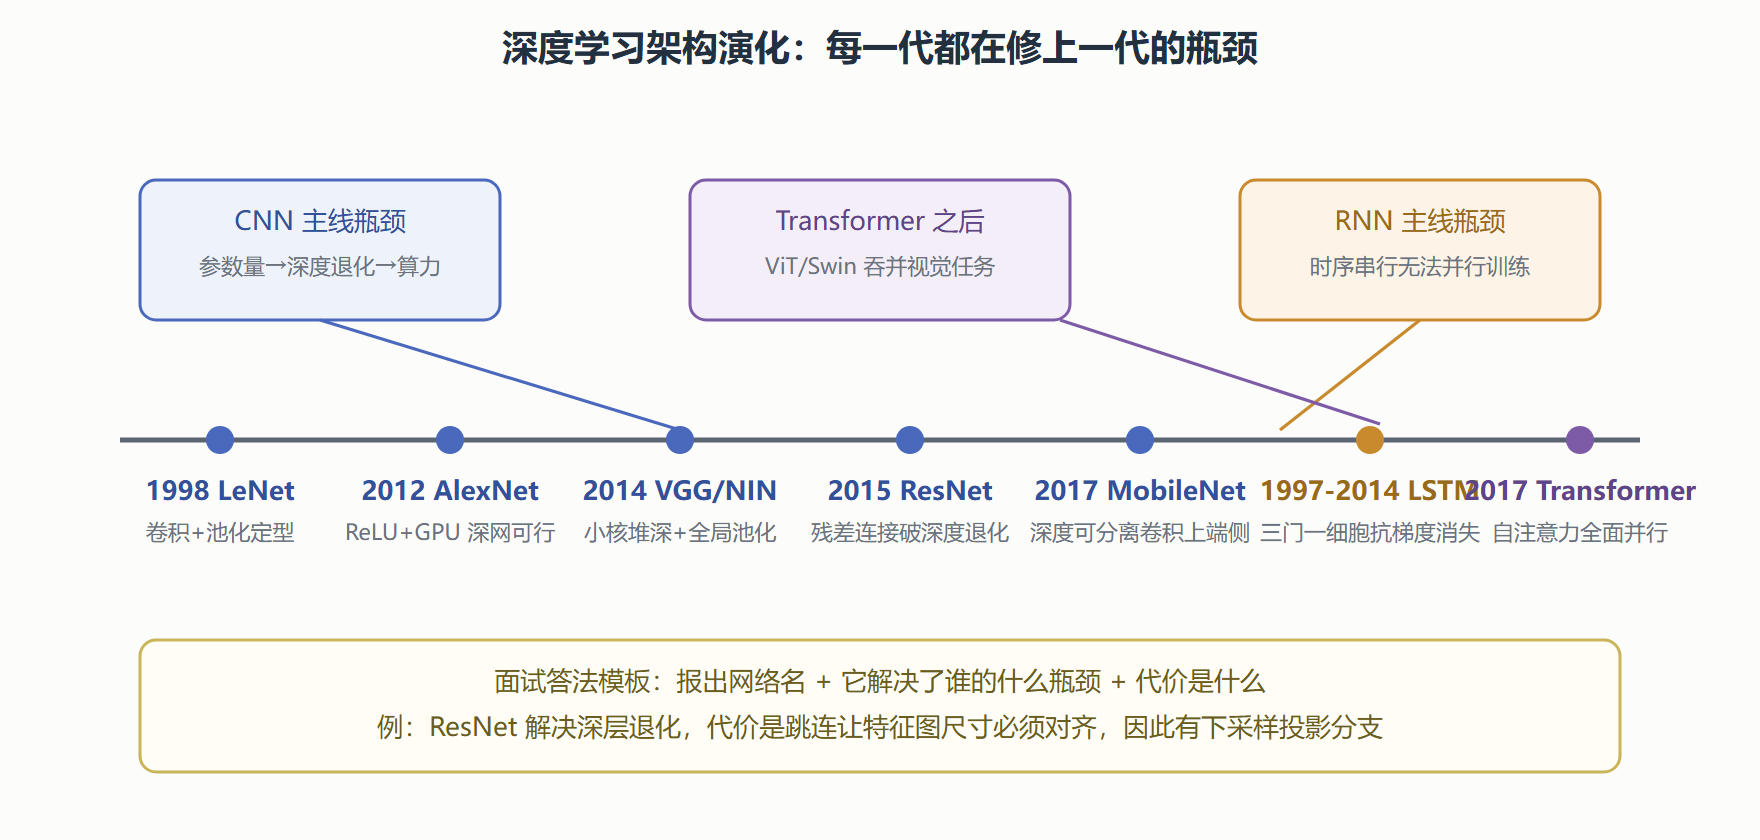
CNN(卷积神经网络) 针对图像的空间局部性设计。全连接层处理图像参数量爆炸,CNN 用两个先验解决:参数共享(同一个卷积核在整张图上复用)和局部连接(每个输出只看局部区域)。卷积层提取局部特征,池化层降采样并提供平移不变性。LeNet → AlexNet → VGG → ResNet → MobileNet 这条演进线,每代都在解决前代的瓶颈。
RNN(循环神经网络) 针对序列数据的时序依赖设计。它维护一个隐状态,在每个时间步用当前输入和上一步隐状态更新自己。朴素 RNN 的问题是梯度消失——反向传播穿过时间步时连乘导致梯度消失,长程依赖学不到。LSTM 引入三个门(遗忘门、输入门、输出门)和一个细胞状态,让梯度有一条"高速通道"直接流过,缓解了长程依赖问题。GRU 是 LSTM 的简化版,合并了几个门,参数更少。
Transformer 用自注意力绕开了 RNN 的时序串行。Self-Attention 让序列里每个位置同时看到所有其他位置,计算可以完全并行。核心是 Query-Key-Value 机制:每个位置生成 Q、K、V 三个向量,用 Q 和所有 K 算注意力权重,再用权重对所有 V 加权求和。多头注意力是并行跑多组 QKV,捕捉不同子空间的关系。位置编码补上 Transformer 本身没有的位置信息。
三、工程实践要点
3.1 残差连接为什么这么重要
ResNet 的核心创新是残差连接:把输入直接加到输出上,让网络学的是残差 F(x) = H(x) - x 而不是 H(x) 本身。
class ResidualBlock: def __init__(self, in_ch, out_ch): self.conv1 = Conv2d(in_ch, out_ch) self.conv2 = Conv2d(out_ch, out_ch) self.bn1 = BatchNorm2d(out_ch) self.bn2 = BatchNorm2d(out_ch) def forward(self, x): out = relu(self.bn1(self.conv1(x))) out = self.bn2(self.conv2(out)) return relu(out + x) # 残差相加
这件事的深远意义在于梯度:反向传播时,梯度有一条"加法直通"的路径,不必经过卷积层的连乘,直接从输出流回输入。这就是为什么 ResNet 能训到 152 层而普通 CNN 训到 30 多层就开始退化。后来 Transformer、Diffusion 几乎所有深网络都用残差连接,它是现代深度架构的标配。
3.2 Dropout 的工程细节
Dropout 在训练时随机把一部分神经元的输出置零,推理时不 dropout 但要把输出按保留概率缩放。它的作用是防过拟合,相当于每次训练一个子网络、推理时做集成。
def dropout(x, p, training): if not training or p == 0: return x mask = (np.random.rand(*x.shape) > p) / (1 - p) # 倒置 dropout return x * mask
⚠️ 常见坑:标准实现用"倒置 dropout"——训练时除以 (1-p) 把期望拉回来,推理时不用动。如果你训练时没除,推理时必须乘 (1-p),否则数值会偏。现代框架默认都是倒置,但你得知道原理,否则改自定义层会踩坑。
3.3 学习率调度
固定学习率训不动现代网络。常用调度策略:预热(warmup)+ 余弦衰减。预热阶段把学习率从零线性升到峰值,避免初始阶段梯度方向乱导致发散;之后用余弦曲线缓慢降到接近零,让后期精细收敛。
| 阶段 | 学习率 | 目的 |
|---|---|---|
| 预热 | 0 → 峰值 | 稳定初期,避免随机初始化导致的梯度爆炸 |
| 主收敛 | 峰值 | 主要参数更新 |
| 衰减 | 峰值 → 接近 0 | 精细收敛,找最优极小值 |
3.4 三大架构的选型直觉
| 数据类型 | 首选架构 | 原因 |
|---|---|---|
| 图像、视频 | CNN / ViT | 空间局部性,参数共享高效 |
| 时序、短文本 | RNN / LSTM | 时序依赖,参数量小 |
| 长文本、Transformer 任务 | Transformer | 并行训练,长程依赖强 |
| 多模态 | Transformer | 统一架构,跨模态注意力 |
到 2026 年,Transformer 在多数任务上已经统一了架构选择,但 CNN 在移动端(参数效率高)、RNN 在资源受限的边缘设备上仍有不可替代的位置。
本节要点回顾
- 反向传播是链式法则的工业化,依赖计算图和自动求导;梯度消失/爆炸的根源是连乘。
- ReLU 成为主流因为正区导数为 1 让梯度无损回传,死亡 ReLU 是其硬伤,Leaky ReLU/GELU 是修补。
- BatchNorm 稳住分布,训练用 batch 统计量、推理用滑动平均,对 batch size 敏感;Transformer/RNN 用 LayerNorm。
- Adam 是默认优化器,一阶二阶矩都估计,有偏差校正;追求 SOTA 泛化可试 SGD+Momentum。
- CNN 用参数共享和局部连接处理图像,演进线 LeNet→AlexNet→VGG→ResNet→MobileNet。
- LSTM 用三门一细胞缓解 RNN 梯度消失,残差连接是现代深网络的标配。
- Transformer 用自注意力并行化,绕开 RNN 串行;预热加余弦衰减是标准学习率调度。
下一章我们把这些深度学习积木应用到图像世界,看 CNN 如何演化出目标检测、语义分割、图像生成等一整套 CV 任务体系。
四、三大架构的演化时间线
把 CNN、RNN、Transformer 放在一条时间线上看,深度学习的架构史就是一部"解决上一个架构瓶颈"的历史。这条线在面试里经常以"你了解哪些经典网络、它们各自解决了什么问题"的形式出现,比背网络结构更重要的是说清演进动机。
顺带补一个容易被追问的细节:ViT 为什么在中等数据量下打不过 CNN,大数据量下反超?因为卷积的归纳偏置(局部性、平移等变)在小数据上是免费的正则,大数据下模型自己能学出来,偏置反而成了天花板。这个答案同时展示了你对"归纳偏置"的理解,是拉开区分度的加分点。