2.2 经典 CV 模型与核心任务
2.2 经典 CV 模型与核心任务
本节摘要:CNN 的演进史就是一部"解决瓶颈"的历史——LeNet 证明卷积可行,AlexNet 让深度学习起飞,VGG 探索了深度,ResNet 解决了深层网络的退化,MobileNet 把它装进手机。围绕这些 backbone,演化出分类、检测、分割、实例分割四大任务。本节把每代架构的设计动机讲清——为什么 VGG 用 3×3 小核、为什么 ResNet 加残差、为什么 YOLO 用单阶段、为什么 U-Net 用跳跃连接,让你能回答"这个设计解决了什么问题"。
学习目标
阅读完本节,你应当能够:
- 说清 LeNet、AlexNet、VGG、ResNet、MobileNet 每代架构的关键创新
- 解释感受野概念,讲清为什么深层网络需要更大的感受野
- 对比 R-CNN 系列与 YOLO 系列的设计哲学,说清两阶段与单阶段的精度速度权衡
- 讲清 IoU、mAP 的计算方式,以及非极大值抑制 NMS 的作用
- 说清 FCN、U-Net、DeepLab 在语义分割上的关键创新
- 解释 Mask R-CNN 如何在检测基础上扩展到实例分割
- 面对追问"换个数据集/任务怎么办"能给出 backbone 选型方案
一、问题与直觉
学 CV 模型最容易踩的坑是"背架构图"——记住 ResNet 长什么样、YOLO 长什么样,但不理解为什么长成这样。这种学法面试官一追问"为什么 VGG 用两个 3×3 而不是一个 5×5"就崩了。
真正的理解脉络是:每代架构都在解决前代的瓶颈。LeNet 时代算力不够,只能浅网络小输入;AlexNet 用 GPU 和 ReLU 把深度学习推上台面;VGG 想加深但发现单纯堆层数效率低,于是验证了小卷积核堆叠的威力;ResNet 想继续加深却发现"退化现象"(更深反而更差),于是引入残差连接;MobileNet 面对移动端算力限制,发明了深度可分离卷积。这不是孤立的知识点,而是一条"瓶颈 → 创新 → 新瓶颈"的因果链。
四大任务也是层层递进的。分类只回答"图里是什么",检测要回答"在哪里、是什么",分割要到像素级回答"每个像素属于什么",实例分割还要区分"同类的不同个体"。每个任务需要不同的网络头部,但共享同一套 backbone。理解了这条线,你才能根据任务选对架构。
二、核心原理
2.1 CNN backbone 演进
LeNet 是最早的 CNN,5 层卷积用于手写数字识别。它证明了卷积 + 池化 + 全连接这套结构可行。
AlexNet 是深度学习的引爆点。它在 ImageNet 上把错误率从 26% 降到 15%,关键创新:用 ReLU 替代 Sigmoid(解决梯度问题)、用 Dropout 防过拟合、用 GPU 并行训练、用数据增强扩充数据。
VGG 的核心洞察是"两个 3×3 卷积的感受野等于一个 5×5,但参数更少、非线性更多"。这种小卷积核堆叠成为后续架构的标准做法。
ResNet 解决的是"退化现象"——网络深到一定程度,训练误差反而上升(不是过拟合,是优化困难)。残差连接让网络学的是 F(x) = H(x) - x 而不是 H(x),梯度可以经由"加法直通"无损回传,于是能训到 152 层甚至更深。
MobileNet 面对移动端算力限制,发明了深度可分离卷积:把标准卷积拆成逐通道卷积(depthwise)+ 逐点卷积(pointwise),参数量和计算量降为原来的 1/8 到 1/9。
| 架构 | 关键创新 | 解决的瓶颈 | 典型层数 |
|---|---|---|---|
| LeNet | 卷积+池化+全连接 | 传统方法无法处理图像 | 5 |
| AlexNet | ReLU、Dropout、GPU | Sigmoid 梯度消失、算力 | 8 |
| VGG | 小卷积核堆叠 | 大核参数多 | 16/19 |
| ResNet | 残差连接 | 深网络退化 | 50/101/152 |
| MobileNet | 深度可分离卷积 | 移动端算力 | 28 |
💡 关键直觉:感受野是理解 CNN 演进的关键。感受野是输出上一个像素对应输入上的区域大小。浅层感受野小,看到的是边缘纹理;深层感受野大,看到的是物体整体。VGG 用小核堆叠扩大感受野,ResNet 用深网络换大感受野,FPN 用多尺度特征图同时提供不同感受野——都是为了"看得够大"。
2.2 目标检测:两阶段 vs 单阶段
目标检测要同时做定位(画框)和分类(标类)。这是 CV 最核心也最复杂的任务之一。
两阶段检测器 先生成候选区域(region proposal),再对每个候选区域分类和精修。R-CNN 系列是代表:
- R-CNN:用 Selective Search 生成 2000 个候选框,每个独立过 CNN,极慢
- Fast R-CNN:候选框共享一次前向,引入 RoI Pooling
- Faster R-CNN:用 RPN(区域提议网络)替代 Selective Search,端到端训练
单阶段检测器 直接在特征图上预测框和类别,一次前向完成。YOLO 系列是代表:
YOLO 把图像划成 S \times S 网格,每个网格负责预测中心落在自己区域的目标,预测 B 个边界框和 C 个类别概率。优点是快(一次前向),缺点是对小目标和密集目标效果差。后续 YOLOv3/v5/v8 持续改进:引入多尺度预测、Anchor Box 优化、训练技巧。
Anchor Box 是检测器里一个关键概念。不同物体形状不同(人高瘦、车宽扁),固定的框预测形状能力有限。Anchor 是预设的一组不同长宽比的框,网络预测的是相对 Anchor 的偏移量,这比直接预测框坐标更容易学。
SSD 用多尺度特征图预测,在不同层检测不同大小的目标。RetinaNet 提出 Focal Loss 解决单阶段检测器的"类别不平衡"问题——背景框远多于前景框,标准交叉熵让模型偏向预测背景,Focal Loss 降低易分类样本的权重。
| 维度 | 两阶段(Faster R-CNN) | 单阶段(YOLO) |
|---|---|---|
| 流程 | 提议 + 分类精修 | 直接预测 |
| 精度 | 高 | 中等 |
| 速度 | 慢 | 快 |
| 小目标 | 好 | 较差 |
| 适用 | 离线高精度 | 实时检测 |
2.3 评估指标:IoU 与 mAP
IoU(交并比) 是预测框和真实框的交集面积除以并集面积。IoU > 0.5 通常算检测正确。
mAP(平均精度均值) 是检测任务的标配指标。计算方式:对每个类别,按置信度排序预测框,画 Precision-Recall 曲线,算曲线下面积(AP),再对所有类别取平均(mAP)。COCO 数据集用 IoU 阈值从 0.5 到 0.95 每隔 0.05 算一次 mAP 再平均,更严格。
NMS(非极大值抑制) 解决"同一个目标被多个重叠框检测到"的问题:按置信度排序,保留最高的框,删除和它 IoU 大于阈值的其它框,循环直到处理完。
2.4 语义分割与实例分割
语义分割 给每个像素分配类别,不区分同类实例。代表模型:
- FCN(全卷积网络) 把全连接层换成卷积,输出和输入同尺寸的分割图
- U-Net 编码器-解码器结构 + 跳跃连接,医学影像标配
- DeepLab 用空洞卷积扩大感受野而不损失分辨率,加 ASPP 多尺度
U-Net 的跳跃连接是关键创新:编码器在下采样时丢失了空间细节(边界、位置),解码器在上采样时通过跳跃连接把这些细节找回来。这个思想和 ResNet 的残差连接异曲同工——都是让信息有"直通"的路径。
实例分割 在语义分割基础上还要区分同类不同实例。Mask R-CNN 在 Faster R-CNN 基础上加一个掩码分支,对每个检测到的实例额外预测像素级掩码。
三、工程实践要点
3.1 backbone 选型决策
def select_backbone(task, latency_budget, accuracy_target): if task == "classification" and latency_budget == "high": return "ResNet50 或 ViT-B" elif task == "detection_realtime": return "YOLOv8 + CSPDarknet" elif task == "segmentation_medical": return "U-Net + ResNet 编码器" elif latency_budget == "mobile": return "MobileNetV3 或 EfficientNet-Lite" return "ResNet50 默认"
⚠️ 常见坑:不要盲目追新。ViT 在大规模预训练后精度领先,但小数据集上不如 ResNet,且推理慢。工程选型要平衡精度、速度、数据量、部署环境,不是看哪篇论文最新。
3.2 长尾分布的处理
真实数据集往往类别极不平衡(自动驾驶里"路"的像素远多于"行人")。三种对策:
| 方法 | 做法 | 适用 |
|---|---|---|
| 重采样 | 过采样少类,欠采样多类 | 训练阶段 |
| 重加权 | 少类样本权重高 | 损失函数 |
| Focal Loss | 降低易分类样本权重 | 单阶段检测 |
3.3 模型压缩四件套
部署到移动端或边缘设备时,模型太大跑不动。四种压缩手段:
| 方法 | 原理 | 压缩比 | 精度损失 |
|---|---|---|---|
| 剪枝 | 删掉不重要的权重或通道 | 2-5× | 小 |
| 量化 | 用 8 位整数替代 32 位浮点 | 4× | 小 |
| 知识蒸馏 | 大模型教小模型 | 取决于学生 | 中 |
| 轻量化设计 | 直接设计小模型(MobileNet) | 5-10× | 中 |
💡 关键直觉:剪枝和蒸馏可以组合。先用大模型蒸馏出中等模型,再对中等模型剪枝量化,最后用 ONNX/TensorRT 部署,整个流水线能把一个 ResNet50 压到能在手机上实时跑。面试时能讲清这套流水线,说明你有实际部署经验。
3.4 检测任务的数据准备
检测数据标注比分类贵得多——每个目标要画框并标类。工程上要关注:
- 标注一致性(多人标注同一目标框的差异)
- 小目标占比(小目标检测难,需要专门增强)
- 困难样本挖掘(OHEM 让网络重点关注难分类样本)
面试速记卡
- CNN 演进是解决瓶颈的历史:LeNet 证明可行、AlexNet 起飞、VGG 探深度、ResNet 解决退化、MobileNet 装进手机。
- 感受野是理解架构的钥匙,浅层看纹理、深层看整体;FPN 多尺度同时提供不同感受野。
- 两阶段精度高、单阶段速度快,Faster R-CNN 用 RPN 替代手工提议,YOLO 用网格直接预测。
- Anchor Box 让网络预测偏移量而非坐标,Focal Loss 解决单阶段检测器类别不平衡。
- IoU 衡量框重叠、mAP 衡量检测精度,COCO 用多 IoU 阈值更严格,NMS 去重复框。
- U-Net 跳跃连接找回下采样丢失的细节,DeepLab 空洞卷积扩大感受野,Mask R-CNN 加掩码分支做实例分割。
- 部署压缩四件套:剪枝、量化、蒸馏、轻量化设计,可组合使用。
下一节把模型从论文落到生产,看迁移学习、数据增强、部署优化的工程实战。
四、检测模型选型的对比矩阵
目标检测的面试题最后常落在"你的项目为什么选这个模型"。这里给一张把主流检测模型放进统一坐标系的对比矩阵,横轴是推理速度,纵轴是精度,气泡大小代表参数量。背下每个模型的具体数字没意义,记住它们的相对位置和背后的取舍逻辑才有用。
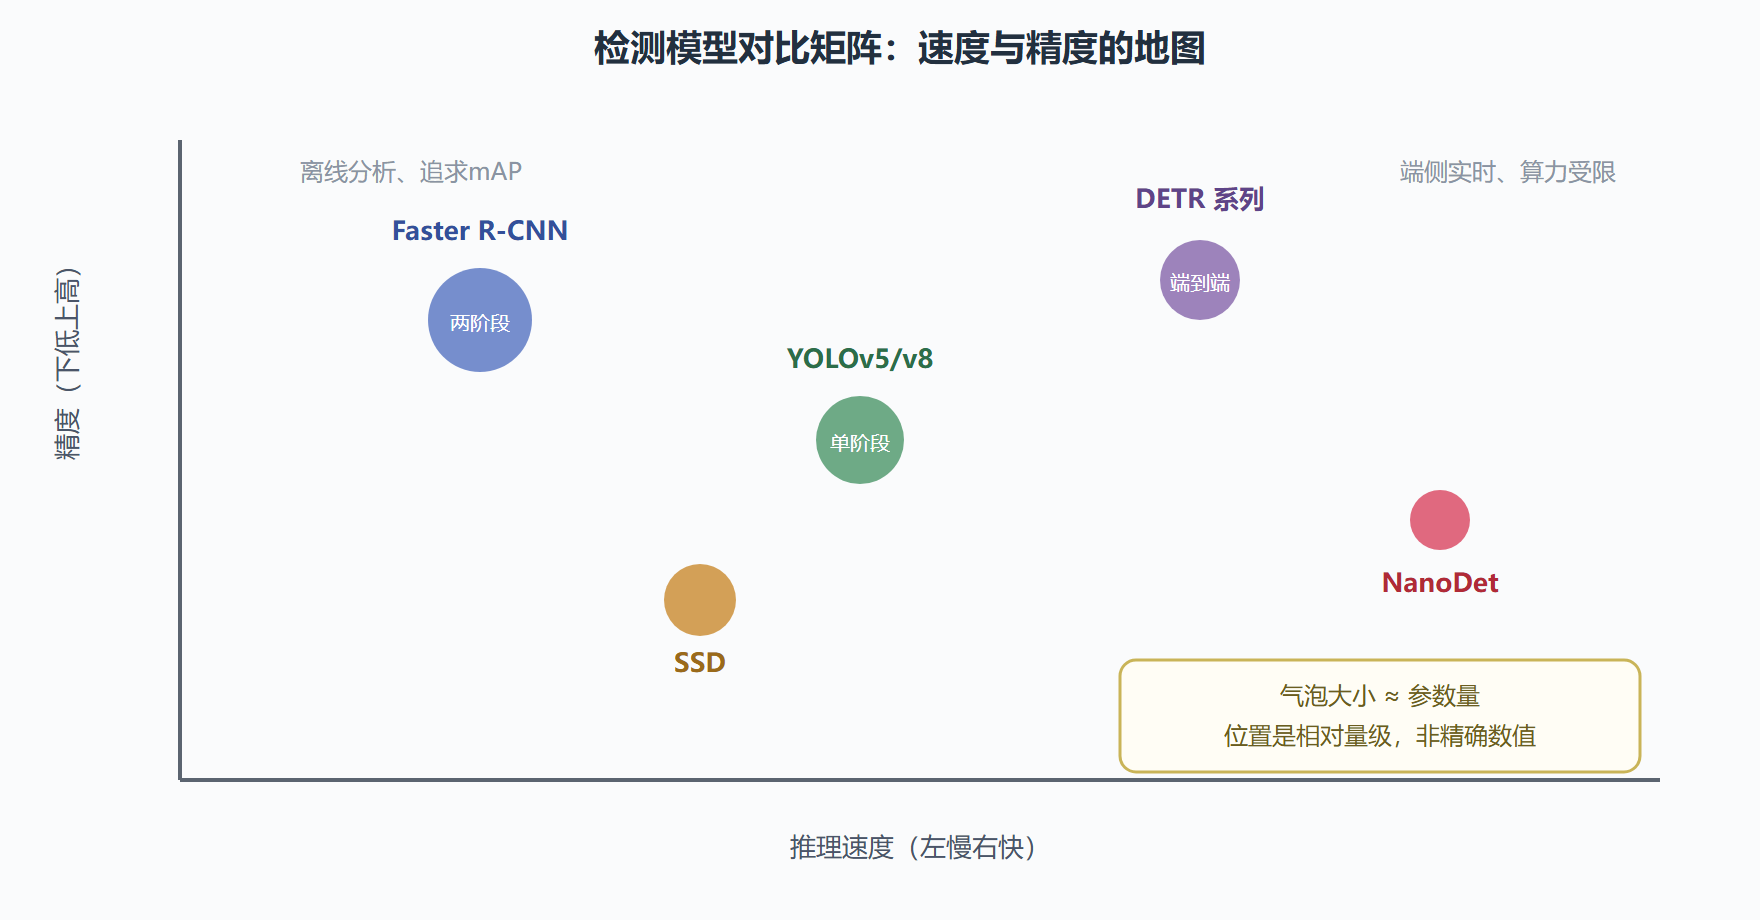
从这张图能读出三条选型规则。其一,离线场景(质检报告、视频离线分析)直接上两阶段或 DETR 系列,精度优先,速度无所谓。其二,端侧实时场景(机器人、手机 AR)落在右下区域,用轻量单阶段模型加量化压缩,牺牲精度换帧率。其三,服务器端实时(视频监控云端分析)在中间地带,YOLO 系列的中大模型是甜点位。面试时把你的项目约束(帧率要求、硬件、小目标还是大目标)映射到这张图上说出选择,比报一串 benchmark 数字有说服力得多。
还有一个高频追问:小目标检测为什么难、怎么办?难在两处——下采样后小目标的特征像素太少,以及小目标在 anchor 分配时正样本稀缺。对策也顺着因果来:提高输入分辨率或加高分辨率检测头(FPN 的 P2 层)、用更密的 anchor 或 anchor-free 的中心点分配、数据上做小目标的复制粘贴增强。能这样从成因推对策,说明你不是在背答案。
补一句白板常客:卷积层输出尺寸的计算口诀是输入减核加一除以步长再向下取整,配合填充项则分子加两倍填充。这个公式在笔试里出现率高到值得当成乘法口诀来记,算错一个尺寸后续全错,务必亲手推三遍以上形成肌肉记忆。