1.1 性能调优目标、指标与常见瓶颈
1.1 性能调优目标、指标与常见瓶颈
本节摘要:调优前先明确目标——是降延迟还是提吞吐?看哪些指标?瓶颈在哪?本节讲清楚调优目标(SLA 驱动)、核心指标(吞吐/延迟/并发/资源)、常见瓶颈分类,让你调优有方向。
调优目标:SLA 驱动
调优不是"越快越好",是"满足 SLA"。SLA(服务等级协议)定义业务可接受的性能边界:
- 延迟 SLA:如 P99 < 200ms(99% 请求 200ms 内响应)。
- 吞吐 SLA:如支撑 5000 QPS。
- 可用性 SLA:如 99.9% 可用(年停机 < 8.76 小时)。
调优目标分两类:
- 问题驱动:现有系统不满足 SLA,要救。如慢查询导致超时。
- 容量驱动:业务增长,提前优化支撑更大负载。如双 11 前扩容调优。
明确目标后,调优才有方向——不是"调到最快",是"调到满足 SLA 且成本可控"。过度优化(超出 SLA 很多)浪费资源,是过度工程。
核心性能指标
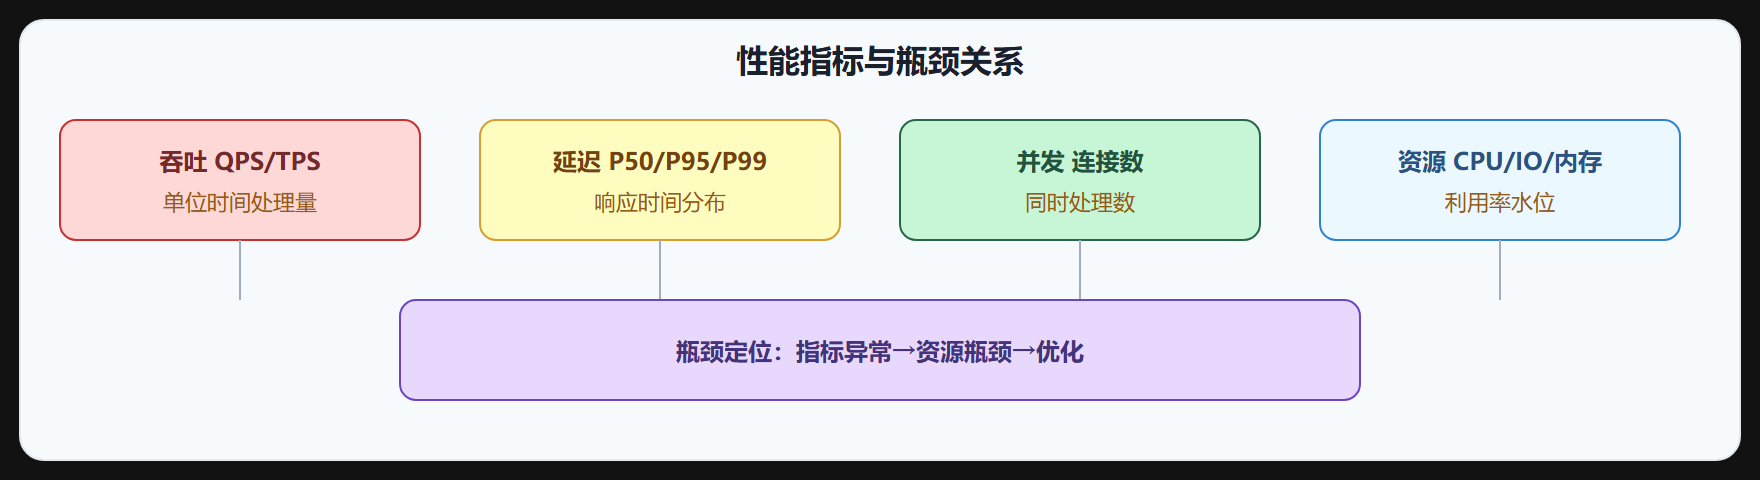
调优看四大类指标:
1. 吞吐指标
- QPS(Queries Per Second):每秒查询数。
- TPS(Transactions Per Second):每秒事务数。
- 吞吐量:单位时间处理的数据量(如 MB/s)。
- 直觉:系统"能干多少活"。
2. 延迟指标
- 平均响应时间:所有请求平均耗时。易被长尾掩盖。
- P50/P95/P99/P999:50%/95%/99%/99.9% 请求的响应时间。P99 比平均更能反映用户体验。
- 尾延迟:最慢的 1% 请求。对交互系统关键(用户感知最慢的)。
- 直觉:系统"干得快不快"。
3. 并发指标
- 并发连接数:当前活跃连接。
- 活跃事务数:正在执行的事务。
- 锁等待数:等待锁的会话。
- 直觉:系统"能同时干多少"。
4. 资源指标
- CPU 利用率:CPU 使用率,>80% 可能瓶颈。
- 内存利用率:含缓存命中率、缓冲池使用。
- I/O:磁盘读写 IOPS、吞吐、等待时间。
- 网络:带宽利用率、延迟、重传。
- 直觉:系统"资源用满没"。
指标的关系
吞吐和延迟是权衡——提高吞吐往往增加延迟(如批量处理)。并发和资源是因果——高并发消耗资源。
关键规律:
- Little 定律:并发 = 吞吐 × 延迟。如 1000 QPS × 0.1s = 100 并发。
- 利用率延迟曲线:资源利用率低时延迟稳定,超 70-80% 后延迟指数上升(排队效应)。
- P99 vs 平均:平均可能好看但 P99 糟(少数慢请求拖累体验)。
调优要平衡——不能只看一个指标。如提吞吐到 10000 QPS 但 P99 从 100ms 飙到 5s,是失败优化。
常见瓶颈分类
数据库瓶颈按层分:
1. SQL 层瓶颈(最常见,~80% 问题)
- 慢查询——无索引、索引失效、查询写法差。
- N+1 查询——ORM 循环查询。
- 大结果集——SELECT * 返回过多。
2. 架构层瓶颈
- 表设计差——大宽表、冗余、范式不当。
- 单表过大——未分区分片。
- 关联过多——多表 JOIN 拖慢。
3. 配置层瓶颈
- 内存不足——缓冲池小,频繁磁盘 IO。
- 连接数不够——连接池小,请求排队。
- 锁竞争——事务长、隔离级别高。
4. 维护层瓶颈
- 统计信息过期——优化器选错计划。
- 碎片——索引/表碎片拖慢 IO。
- 锁等待——长事务阻塞。
5. 硬件层瓶颈
- CPU 满——复杂查询/排序/聚合。
- 磁盘慢——机械盘、IO 等待。
- 内存小——缓存命中率低。
- 网络延迟——跨机房、带宽不足。
瓶颈定位原则
定位瓶颈的原则:
1. 从上到下:先 SQL(最常见)→ 架构 → 配置 → 硬件。别一上来就加硬件。
2. 数据驱动:用监控数据定位,不靠猜。看慢查询日志、执行计划、资源监控。
3. 单一变量:一次改一个,验证效果,别同时改多个(分不清谁起作用)。
4. 二八原则:80% 问题来自 20% 查询。找最慢的几个查询优化,收益最大。
5. 瓶颈转移:优化一层后瓶颈转移到下层。如优化 SQL 后 CPU 降但 IO 升,IO 成新瓶颈,继续优化。
⚠️ 常见误读:以为"调优就是调到最快"。调优是满足 SLA 且成本可控,不是无限快。过度优化是浪费。且要看 P99 不只平均——平均好看但 P99 糟是失败。
💡 关键直觉:调优目标 SLA 驱动(延迟 P99/吞吐 QPS/可用性),问题驱动或容量驱动。四大指标——吞吐(QPS/TPS)、延迟(P50/P95/P99,P99 比平均重要)、并发(连接/事务/锁)、资源(CPU/内存/IO/网络)。Little 定律(并发=吞吐×延迟)、利用率超 70-80% 延迟指数升。瓶颈五层——SQL(80%)、架构、配置、维护、硬件。定位从上到下、数据驱动、单一变量、二八原则、瓶颈转移。
收获清单
- 调优目标:SLA 驱动(延迟 P99/吞吐 QPS/可用性 99.9%),问题驱动(救)或容量驱动(预防),满足 SLA 且成本可控,非无限快。
- 吞吐指标:QPS、TPS、吞吐量,系统"能干多少活"。
- 延迟指标:平均(易被长尾掩盖)、P50/P95/P99/P999(P99 反映体验)、尾延迟,"干得快不快"。
- 并发指标:并发连接、活跃事务、锁等待,"能同时干多少"。
- 资源指标:CPU(>80% 瓶颈)、内存(缓存命中)、IO(IOPS/等待)、网络(带宽/延迟)。
- 指标关系:Little 定律(并发=吞吐×延迟)、利用率延迟曲线(超 70-80% 延迟指数升)、P99 vs 平均(看 P99 不只平均)。
- 瓶颈五层:SQL(无索引/N+1/大结果集,~80%)、架构(表设计/单表大/关联多)、配置(内存/连接/锁)、维护(统计过期/碎片/长事务)、硬件(CPU/磁盘/内存/网络)。
- 定位原则:从上到下(先 SQL)、数据驱动(监控不猜)、单一变量(一次改一个)、二八原则(80% 问题 20% 查询)、瓶颈转移(优化一层瓶颈转移下层)。
两种指标体系的对比:运营口径 vs 工程口径
同一家公司里,运营和工程对"性能好"的定义经常打架。运营口径看平均值——"平均响应 80 毫秒,挺好";工程口径看分位数——"P99 是 4 秒,每一百次请求就有一次卡顿"。两个口径都没说谎,但结论相反。原因在统计分布:数据库响应时间典型呈重尾分布,少数慢查询(缓存未命中、锁等待、后台任务挤占)把平均值拉得尚可,却把尾部拉得很长。对报表类后台,平均值口径足够;对交易类在线系统,用户感知的是"最糟的那次",必须盯 P95 以上。
再对比一组容易混淆的指标对:QPS 与并发数。压测报告常写"支持 5000 QPS",但这句话没有意义,除非同时给出延迟——按 Little 定律,5000 QPS × 50 毫秒意味着 250 个并发在系统内;如果延迟是 500 毫秒,同样的并发只剩 500 QPS。所以验收口径要写成"P99 ≤ 100 毫秒前提下 ≥ 3000 QPS"这种双指标形式,只承诺一端都是数字游戏。
资源利用率指标也有口径陷阱:CPU 平均利用率 60% 看似健康,但若每分钟的峰值都冲到 95%,说明系统在周期性地排队(比如整点统计任务)。所以资源指标要看两个维度——均值看容量水位,峰值看排队风险。经验阈值对比如下:均值 70% 以上、或峰值持续 90% 以上,就该扩容或优化;低于 30% 则可能在为不需要的性能付费。
五层瓶颈的典型信号对照
把五层瓶颈的"指纹"整理成对照表,定位时可按图索骥。SQL 层的指纹是:少量查询占用绝大多数时间(慢查询日志里前十条占比超六成)、单查询逻辑读高但物理读低、CPU 用户态占比高。架构层的指纹是:单表行数过大带来的统计信息漂移、JOIN 中间结果集膨胀、锁等待集中在少数热点行。配置层的指纹最典型:缓冲池命中率低(低于 95% 就要警惕)、临时表落盘比例高、连接排队但 CPU 不忙。维护层的指纹是:执行计划突然变差但查询没改过(统计信息过期的经典表现)、空间持续增长但行数没涨(碎片)。硬件层的指纹是:IO 等待占比高且换页频繁、网络重传率上升。
值得强调的是指纹组合的排除力。比如"CPU 满 + 缓冲池命中率高 + 慢查询集中在排序聚合"指向 CPU 型负载(SQL 层优化或换更强 CPU);"CPU 闲 + IO 等待高 + 命中率低"指向内存不足(加缓冲池或加内存);"资源都不满但延迟高"则大概率是锁等待或调度排队——资源指标全是绿的系统照样可以很慢,这是新人最容易困惑的场景,原因往往是瓶颈不在"算力"而在"排队"。
一个真实的指标误读案例
某电商订单库季度汇报:平均响应时间从 120 毫秒降到 70 毫秒,团队庆祝。三个月后客服投诉暴涨。复盘发现:一次索引优化让 95% 的查询从 150 毫秒降到 40 毫秒,但剩余 5% 的复杂报表查询从 800 毫秒恶化到 3 秒(新索引改变了优化器选择,报表走了错误的连接顺序)。平均值被多数查询的改善拉低,尾部被少数查询的恶化拉爆。教训有三条:第一,性能汇报必须同时看均值和 P95/P99;第二,任何优化上线前要对"查询类型分布"分层验证,不能只看聚合值;第三,监控要按查询指纹(相同模板的查询归为一类)分桶统计,聚合数字会撒谎,分桶数字不会。这个案例也解释了为什么成熟的数据库监控产品都内置"查询指纹聚合"功能——它就是把"平均值陷阱"从工具层面堵死的手段。
四大瓶颈的资源画像互证法
单看一个指标容易误诊,四个瓶颈资源(CPU、内存、IO、锁)的指标要交叉互证。给一组互证模式:CPU 高且 IO 低——大概率是计算型 SQL(排序、函数、解析大结果集),去第 2 章找语句问题;CPU 低且 IO 高——典型的 IO 瓶颈,可能是缓冲池太小、也可能是全表扫描的物理读,两者要去不同层修;内存压力高且 IO 以读为主——缓冲池命中率下降,加大内存或缩小工作集;IO 以写为主且日志类文件居多——检查写入放大(索引过多、页分裂频繁)与日志参数;各项资源都不高但等待严重——八成是锁或队列问题,等待事件才是真相所在。这套互证法把"数据库慢"这个模糊主诉翻译成有方向的假设,是排障的第一步,也是本教程反复强调"等待事件优先于资源利用率"的原因——资源利用率告诉你忙不忙,等待事件告诉你卡在哪。养成先看等待再看利用率的习惯,排障效率会有质的提升。
等待事件:瓶颈诊断的第一入口
四大资源的画像互证之后,更精细的定位要靠等待事件——数据库把"会话在等什么"记录成带语义的事件,是瓶颈诊断的第一入口。读等待事件的三层方法:第一层,聚合排队——按事件类型聚合等待时间,排前三的等待就是全局瓶颈的画像(比如"锁等待占六成"与"IO 读等待占六成"是两个完全不同的故事);第二层,关联会话——从高等待的会话反查它正在执行的 SQL 与执行计划,把"系统慢"落到"这几条语句慢";第三层,时间线切片——把等待事件按时间轴展开,与变更记录(发布、参数调整、数据导入)对齐,慢的开始时间常与某个变更精确重合。三层方法组成的漏斗,把模糊的性能主诉收敛到具体的优化对象——这套漏斗值得每个值班工程师练到肌肉记忆。最后提醒等待事件的阅读礼仪:单看"什么等待最多"容易误导(高频小等待累计值大但无关痛痒),要同时看平均等待时长与影响会话数,三个维度交叉才能排出真正值得攻击的目标。