2.1 索引设计与优化
2.1 索引设计与优化
本节摘要:索引是 SQL 优化的第一利器,但乱加反害。本节讲清楚 B+树索引原理、复合索引最左前缀、覆盖索引、选择性原则、索引失效场景,让你加对索引。
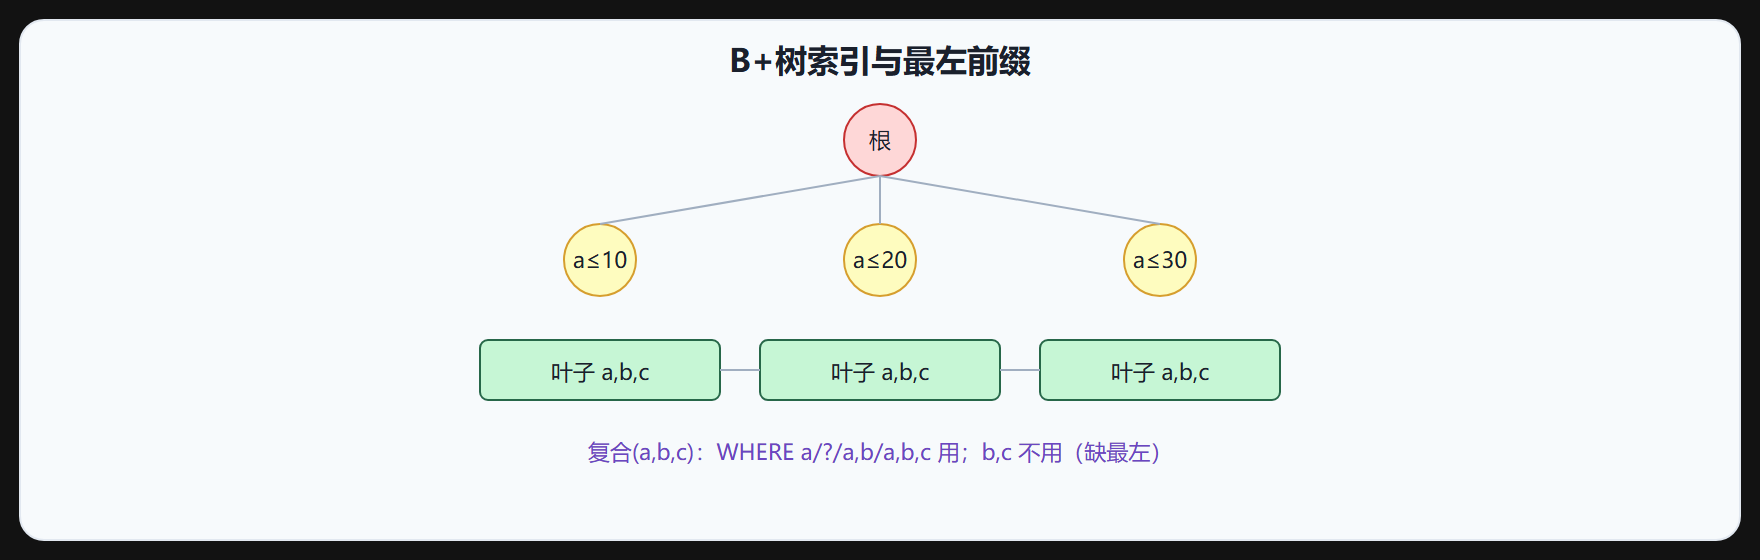
索引为什么快
索引是"目录"——让数据库快速定位数据而非全表扫描。
B+树索引(主流数据库默认):
- 数据存叶子节点,叶子按键排序且链表相连。
- 查找 O(log n)——10 亿行约 30 次比较。
- 范围查询高效——叶子链表顺序访问。
- 排序高效——索引已排序,免 ORDER BY 排序。
对比全表扫描 O(n)——10 亿行要 10 亿次 IO。索引把 10 亿降到 30,是数量级提升。
复合索引与最左前缀
复合索引:多列组成一个索引,如 INDEX(a, b, c)。
最左前缀原则:复合索引从最左列开始匹配:
- WHERE a=? 用索引(a 前缀)。
- WHERE a=? AND b=? 用索引(a, b 前缀)。
- WHERE a=? AND b=? AND c=? 用索引(全部)。
- WHERE b=? AND c=? 不用索引(缺最左 a)。
- WHERE a=? AND c=? 用 a 部分(b 缺,c 用不上索引,但 a 能用)。
设计复合索引按查询模式——把最常用过滤列放最左,范围查询列放最后(范围后列不用索引)。
覆盖索引
覆盖索引:索引含查询所需所有列,无需回表(取数据行)。
例:SELECT id, name FROM users WHERE status=1,若 INDEX(status, name) 含 status 和 name,则索引覆盖——只查索引不回表,快很多(省 IO)。
设计:把 SELECT 的列加入复合索引,实现覆盖。但别过度——索引列多则索引大、写入慢。
选择性原则
选择性:不同值数 / 总行数。高选择性(接近 1)适合索引,低选择性(如性别 0.5)不适合。
- 高选择性列索引效果好——如 user_id(每行不同)。
- 低选择性列索引效果差——如 status(只有几个值),索引扫描大量行。
- 复合索引整体选择性——多列组合选择性高即可,单列可低。
设计:高选择性列建索引,低选择性列不单独建(可放复合索引)。
索引失效场景
索引可能"建了但不用"——常见失效:
1. 函数操作列
- WHERE YEAR(create_time)=2024 不用索引(函数操作列)。
- 改:WHERE create_time >= '2024-01-01' AND create_time < '2025-01-01' 用索引。
2. 隐式类型转换
- WHERE phone=13800138000(phone 是 varchar)不用索引(转数字)。
- 改:WHERE phone='13800138000' 用索引。
3. LIKE 前缀通配
- WHERE name LIKE '%张' 不用索引(前缀通配)。
- WHERE name LIKE '张%' 用索引(后缀通配)。
4. OR 连接非索引列
- WHERE a=1 OR b=2,若 b 无索引,整体不用索引(除非都索引)。
5. 不符合最左前缀
- 复合 INDEX(a,b,c),WHERE b=? 不用索引。
6. 优化器判断全表更快
- 小表或返回大量行时,优化器选全表(比索引回表快)。
索引的代价
索引不是免费的:
- 写入慢:INSERT/UPDATE/DELETE 要维护索引,索引多则写入慢。
- 存储:索引占空间,可能和数据相当。
- 维护:索引碎片化要定期重建。
原则:读多的表多索引,写多的表少索引。别建不用的索引——定期审计(如 MySQL 的 unused index 检测)。
⚠️ 常见误读:以为"索引越多越好"。索引有代价——写入慢、占空间、要维护。读多写少多索引,写多读少少索引,定期审计无用索引。
💡 关键直觉:索引是 B+树目录,O(log n) 查找 vs 全表 O(n)。复合索引最左前缀(最常用过滤列放最左,范围列放最后)。覆盖索引含查询所有列免回表。选择性高(接近 1)适合索引。失效场景:函数操作列、隐式类型转换、LIKE 前缀通配、OR 非索引列、不符合最左前缀、优化器判全表更快。代价:写入慢、存储、维护。读多写少多索引,反之少索引,审计无用索引。
本节要点回顾
- 索引原理:B+树,数据在叶子排序+链表,查找 O(log n),范围/排序高效,vs 全表 O(n)。
- 复合索引:多列 INDEX(a,b,c),最左前缀(a/a,b/a,b,c 用,b,c 不用缺最左),设计按查询模式(常用过滤列最左,范围列最后)。
- 覆盖索引:含查询所有列免回表(省 IO),SELECT 列加入复合索引,但别过度(索引大写入慢)。
- 选择性:不同值/总行数,高(接近 1,user_id)适合,低(性别)不适合单独建,复合整体选择性高即可。
- 失效场景:函数操作列(YEAR(create_time)→范围)、隐式类型转换(phone=数字→字符串)、LIKE 前缀通配('%张'不用/张%用)、OR 非索引列、不符合最左前缀、优化器判全表更快(小表/大返回)。
- 代价:写入慢(INSERT/UPDATE/DELETE 维护索引)、存储(可能和数据相当)、维护(碎片重建)。
- 原则:读多写少多索引,写多读少少索引,定期审计无用索引(MySQL unused index 检测)。
联合索引的设计推演(完整案例)
用一个真实风格的设计推演把索引知识串起来。场景:订单表三千万行,高频查询是"按用户查最近三十天的已完成订单,按时间倒序分页"。查询条件:用户号等值、状态等值、时间范围、排序分页。推演第一步,单列索引试探:只建用户号索引,扫描量降到该用户的几千行,再过滤状态与时间——可用但不优,排序还需要额外操作。第二步,等值列前置:建(用户号,状态,创建时间)联合索引——等值条件列放前面,范围与排序列放最后;这一步让过滤与排序都在索引内完成,回表只剩最终分页的几十行。第三步,覆盖索引评估:如果查询只取订单号、金额、时间三个字段,把它们也加入索引形成覆盖,连回表都省了;但要权衡——索引变宽、写入成本上升、每行索引占用的空间放大。第四步,写入侧核算:该表日增十万行,每个索引都让插入多一次排序写入,联合索引从两个砍到一个的决定由此而来。这个推演展示了索引设计的完整思路链:先分析查询模式(等值、范围、排序的字段分布),再设计列序(最左前缀与等值前置原则),最后核算写入代价(索引不是免费的)。日常工作中把这套推演写成注释放进建表脚本,半年后的维护者会感谢你。
常见索引陷阱速查表
| 陷阱 | 现象 | 根因 | 解法 |
|---|---|---|---|
| 隐式类型转换 | 字符串列传数字,索引失效 | 类型不匹配触发转换 | 统一类型与写法 |
| 前导模糊匹配 | like 百分号开头,索引失效 | B树无法前缀定位 | 改后缀匹配或搜索引擎 |
| 函数包裹列 | where date(时间)=…,索引失效 | 对列做运算 | 改区间比较 |
| 最左前缀缺失 | 联合索引第二列单独查,失效 | 跳过第一列无序可循 | 按查询模式调整列序或补索引 |
| 低选择性单列 | 性别列索引,优化器不用 | 区分度太低 | 换联合索引或干脆不建 |
| 冗余索引 | 单列被联合索引前缀覆盖 | 设计缺乏审查 | 定期清理冗余 |
这张表是慢查询排查的第一站:拿到一条"意外走了全表扫描"的 SQL,先对照六行陷阱扫一遍,八成的失效原因在这六类里。表格之外还有一类更隐蔽的——统计信息过期导致优化器误判(第 5 章展开),判断特征是"执行计划时好时坏",那是另一个故事的开头。
索引与写入的共生设计
索引章节的收官话题:把视角切到写入侧,做索引与写入的共生设计。写入成本模型:每 insert 或 update 索引列,都要在对应 B 树上做一次定位加可能的页分裂,索引数量与写入吞吐近似线性反比——十条索引的表,写入吞吐可能只有无索引时的三分之一。共生设计的三个动作:动作一,索引盘点——半年一次清理"从未被查询命中的索引"(多数库提供使用统计),僵尸索引是纯粹的写入税;动作二,索引合并——把(用户号)与(用户号,时间)两个索引合并为后者,单列被前缀覆盖时单独保留没有意义;动作三,写入路径审查——批量导入前评估临时禁用次要索引(导完重建)的收益,高频更新列尽量移出索引。平衡的量化直觉:读多写少的报表库可以慷慨建索引(十几个不算多),写入极热的日志表要吝啬(两三个是上限),交易库居中(核心查询命中即可)。索引设计的完整知识 = 查询侧的加速原理(前几节)加写入侧的成本模型(本节)——只懂前者是半吊子,两者兼修才能在评审桌上说服所有人。
索引优化的落地工作流
把索引知识组织成可执行的周度工作流。周一,清单日:导出上周慢查询按总耗时排序,取前二十条提取查询模式(表、条件列、排序列)。周二,设计日:对照现有索引逐模式设计(新索引、改列序、覆盖化),每条设计写推演注释(为什么这个列序、预期扫描量变化)。周三,评审日:与开发对齐(查询是否长期存在、写路径能否承受),写入预算表登记。周四,实施日:低峰上线新索引(在线方式),删除的索引先禁用一周再真删。周五,验证日:对比慢查询清单与新索引命中统计,确认收益、记录到优化台账。这套工作流每周两三个小时,一个月就能清完存量的八成慢查询;之后转为守势(新查询的门禁拦截),投入减半。索引优化的行业真相是:方法论不难、案例网上遍地,难的是把它变成雷打不动的例行流程——工作流的意义就是用节奏对抗惰性。
索引问答三则
问:两个查询模式冲突(一个按时间过滤、一个按用户过滤),索引怎么建? 答:先各自建(时间索引、用户索引各一),观察优化器的实际选择与两个查询的频率——若一个占九成流量,把它的列序排进联合索引首位、另一个保留单列;若五五开且表大,考虑两个联合索引并存并接受写入代价,或引入冗余时间字段收窄其中一方。问:函数索引值不值得用? 答:查询模式确实需要对列做函数(按月聚合)且改写无门时用——它把"改不掉的坏写法"救回来;但先花十分钟试改写(区间比较替代函数),改写永远是首选。问:索引建多了想清理,怎么判断哪个没用? 答:用使用统计(命中计数)观察一个完整的业务周期(覆盖月结、大促等低频场景),零命中的进入候选;删除走"先禁用观察一周再真删"的两步流程——索引删除的后悔药比创建贵。
收尾再送一个评估习惯:每次索引变更后,把"扫描行数的变化"记录在优化台账里——扫描行数是索引收益最诚实的度量(时延会受缓存与并发干扰,扫描量不会),三五个案例积累后,你对"什么样的查询模式能被索引救多少"会形成可靠的直觉,这个直觉是索引设计评审会上最值钱的发言依据。
一个数字帮住手感:核心表的索引数量以"查询模式数加一"为起点(每种高频模式一个最优索引,加一个主键),超出部分要能说出每一枚的存在理由;说不出的,就是下一轮盘点时的清理候选。索引与表的关系像书与目录,目录厚过书的书没人愿意写也没人愿意读。