2.3 执行计划分析与理解
2.3 执行计划分析与理解
本节摘要:EXPLAIN 是 DBA 的"X 光"。本节讲清楚 EXPLAIN 各字段(type/key/rows/Extra)、访问类型层级、常见问题判断,让你读懂执行计划定位慢查询根因。
EXPLAIN 是什么
EXPLAIN 显示优化器选择的执行计划——数据库怎么执行这条 SQL:用哪个索引、扫描多少行、是否临时表/排序。
用法:EXPLAIN SELECT ...,返回执行计划表。
不同数据库:
- MySQL:EXPLAIN + EXTENDED/FORMAT=JSON。
- PostgreSQL:EXPLAIN + ANALYZE(实际执行+统计)。
- Oracle:EXPLAIN PLAN + DBMS_XPLAN。
- SQL Server:SET SHOWPLAN_TEXT/GRAPHICAL。
读懂 EXPLAIN 是定位慢查询的核心技能。
MySQL EXPLAIN 关键字段
1. type(访问类型)——最重要
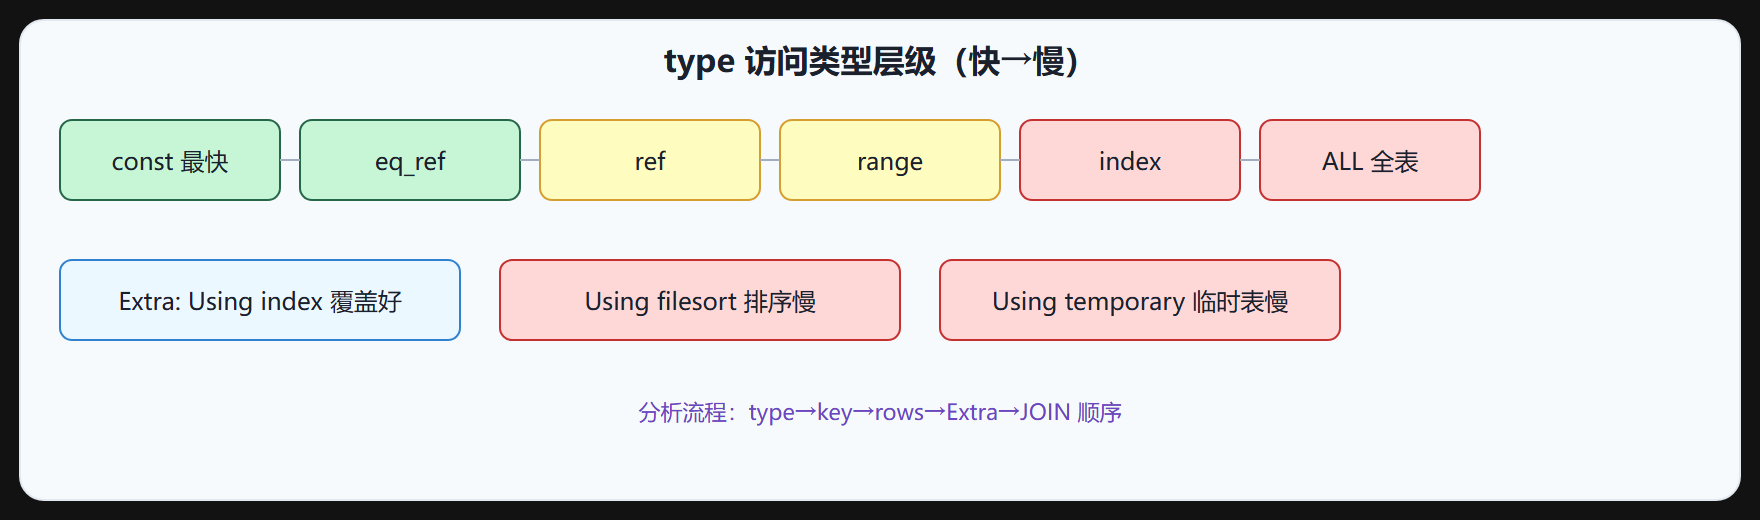
从快到慢层级:
- system:表只有一行(系统表)。
- const:主键/唯一索引等值查询,最多一行。最快。
- eq_ref:JOIN 用主键/唯一索引等值,一行。JOIN 中最快。
- ref:非唯一索引等值,多行。快。
- range:索引范围扫描(BETWEEN/>/IN)。较快。
- index:扫描整个索引(不回表)。中等——比全表快(索引小)。
- ALL:全表扫描。最慢——无索引或索引失效。
判断:type 是 ALL 或 index 通常要优化(加索引/改查询)。const/eq_ref/ref/range 是好的。
2. key(实际用索引)
- 显示实际使用的索引。NULL 表示没用索引(全表扫描)。
- 对比 possible_keys(可能用的)——若 possible_keys 多但 key 是 NULL,优化器没选索引,可能要 hint。
3. rows(预估扫描行数)
- 优化器预估扫描的行数。越小越好。
- 大 rows + ALL = 全表扫描大表,慢。
- 注意是预估值,可能不准(统计信息过期)。
4. Extra(额外信息)——重要
- Using index:覆盖索引,免回表。好。
- Using where:用 WHERE 过滤。常见。
- Using filesort:额外排序。慢——优化排序(索引列)。
- Using temporary:用临时表(GROUP BY/DISTINCT)。慢——优化分组。
- Using join buffer:JOIN 无索引用缓冲。慢——加 JOIN 索引。
- Impossible WHERE:WHERE 恒假,返回空。正常。
PostgreSQL EXPLAIN
PostgreSQL EXPLAIN ANALYZE 实际执行,给真实统计:
- Seq Scan:顺序全表扫描(= MySQL ALL)。
- Index Scan:索引扫描取数据(回表)。
- Index Only Scan:覆盖索引(= Using index)。
- Bitmap Index Scan + Bitmap Heap Scan:位图索引扫描,适合范围。
- Nested Loop / Hash Join / Merge Join:JOIN 算法。
- Nested Loop:小表驱动大表。
- Hash Join:大表 JOIN,哈希小表。
- Merge Join:两表都排序时。
- actual time/rows/loops:实际执行统计,比预估值准。
执行计划分析流程
1. 看 type/Seq Scan
- ALL/Seq Scan 要警惕——是否该用索引没用。
- 若该用索引但没用——查索引失效(函数列/隐式转换/最左前缀)。
2. 看 key/Index
- NULL/无索引——加索引。
- 用了索引但慢——查 rows,是否扫描太多行。
3. 看 rows
- 大 rows——是否过滤不够(加 WHERE)或索引选择性低。
- rows 远大于实际返回——索引不精准。
4. 看 Extra
- Using filesort——排序优化(索引列)。
- Using temporary——分组优化(GROUP BY 索引)。
- Using join buffer——JOIN 索引。
5. 看 JOIN 顺序
- 小表驱动大表——优化器通常自动选,但可 hint。
- JOIN 类型——Nested Loop 适合小表,Hash Join 适合大表。
常见问题判断
问题1:全表扫描(ALL/Seq Scan)
- 原因:无索引/索引失效/优化器选全表。
- 解决:加索引/改查询避免失效/查统计信息。
问题2:filesort
- 原因:排序不在索引。
- 解决:排序列加索引/方向一致/减少排序数据。
问题3:Using temporary
- 原因:GROUP BY/DISTINCT 无索引。
- 解决:分组列加索引/减少分组列。
问题4:rows 过大
- 原因:索引选择性低/过滤不够。
- 解决:加过滤条件/改复合索引提选择性。
问题5:JOIN 慢
- 原因:JOIN 列无索引/JOIN 顺序差。
- 解决:JOIN 列加索引/小驱大 hint。
统计信息与执行计划
执行计划依赖统计信息——优化器用统计估算成本选计划。
- 统计过期→优化器选错计划(如该用索引却全表)。
- 更新统计:MySQL ANALYZE TABLE、PostgreSQL ANALYZE、Oracle DBMS_STATS。
- 直方图:MySQL 8.0+/PostgreSQL 支持直方图,对非索引列选择性估算更准。
统计信息管理是第 5 章内容,但影响执行计划,这里关联。
⚠️ 常见误读:以为"rows 是实际行数"。rows 是优化器预估值,可能不准(统计过期)。PostgreSQL EXPLAIN ANALYZE 给实际值,更准。
💡 关键直觉:EXPLAIN 显示执行计划。MySQL type 从快到慢(const/eq_ref/ref/range/index/ALL,ALL 全表最慢),key 实际索引(NULL 没用),rows 预估扫描数(越小越好),Extra(Using index 覆盖好/filesort/temporary 慢)。PostgreSQL Seq Scan/Index Scan/Index Only Scan/JOIN 算法(Nested Loop/Hash/Merge),ANALYZE 给实际统计。分析流程 type→key→rows→Extra→JOIN 顺序。常见问题:全表扫描/filesort/temporary/rows 大/JOIN 慢。统计信息影响计划,过期选错,ANALYZE 更新。
执行计划读法要点
- EXPLAIN:显示优化器执行计划(用索引/扫描行数/临时表排序),MySQL EXPLAIN、PostgreSQL EXPLAIN ANALYZE(实际执行+统计)、Oracle EXPLAIN PLAN/DBMS_XPLAN、SQL Server SHOWPLAN。
- MySQL type:system/const(主键唯一等值,最快)→eq_ref(JOIN 主键唯一)→ref(非唯一等值)→range(范围)→index(扫整个索引)→ALL(全表,最慢)。ALL/index 通常要优化。
- key:实际用索引,NULL 表示没用索引(全表),对比 possible_keys 判断优化器选择。
- rows:预估扫描行数(越小越好),大 rows+ALL=全表大表慢,是预估值可能不准。
- Extra:Using index(覆盖免回表,好)、Using where(过滤)、Using filesort(额外排序,慢)、Using temporary(临时表,慢)、Using join buffer(JOIN 无索引,慢)、Impossible WHERE(恒假)。
- PostgreSQL:Seq Scan(全表)/Index Scan(回表)/Index Only Scan(覆盖)/Bitmap(范围)/JOIN 算法(Nested Loop 小驱大、Hash 大表、Merge 排序),actual time/rows/loops 实际统计。
- 分析流程:type(全表?)→key(用索引?)→rows(扫描多?)→Extra(filesort/temporary?)→JOIN 顺序(小驱大)。
- 常见问题:全表扫描(加索引/避免失效/更新统计)、filesort(索引列/方向一致)、Using temporary(GROUP BY 索引)、rows 大(加过滤/提选择性)、JOIN 慢(列索引/小驱大 hint)。
- 统计信息:影响计划,过期选错(该索引却全表),ANALYZE TABLE/ANALYZE/DBMS_STATS 更新,直方图(MySQL 8.0+/PG)对非索引列估算更准。
从执行计划到优化假设的完整推理链
读懂执行计划的关键不是认识每个算子的名字,而是建立"算子组合到性能假设"的推理链。给一个三步推理模板。第一步,找最贵的算子——代价占比最高的节点(通常是扫描、排序、大连接),它就是主攻方向;多个代价接近的节点说明问题分散,先解决上游。第二步,追问该算子的必要性——这个全表扫描有可用索引吗(有但没用上是统计或写法问题,没有是索引设计问题)?这个排序能被索引消除吗(排序列与过滤列能否进同一个索引)?这个大连接的驱动表选对了吗(小表驱动大表,还是优化器信息缺失)?第三步,验证假设——按第二步的答案改写或加索引,对比执行计划与实际时延,确认假设成立。三步循环两三轮,多数慢查询都能定位根因。另一个高价值习惯是保存"改写前后"的执行计划对——它们是团队最好的教学材料,也是下次类似问题出现时的检索库。执行计划是数据库给你看的底牌,会读的人调优,不会读的人调参。
优化器的三堵墙与绕行术
理解执行计划的进阶是理解优化器的三堵墙——它算不准、看不到、管不了的地方,也是人工介入的价值区。墙一,统计信息的粒度:优化器知道列的直方图,但不知道"状态等于已完成的行集中在最近三个月"这类跨列相关性——估算行数偏差导致 join 顺序错误;绕行术是手工hint或改写引导(它信不过估算时你给它确定性)。墙二,成本的盲区:代价模型对缓存命中、并发竞争、锁等待视而不见,"纸面最优"的计划在真实负载下未必快;绕行术是实测定夺——两个计划跑真实数据对比,而不是争论模型。墙三,搜索空间的放弃:多表连接的组合爆炸让优化器在十几张表后直接放弃穷举, join 顺序可能离最优很远;绕行术是把大查询拆成阶段性小查询(临时表固化中间结果),每段都在优化器的能力圈内。三堵墙解释了"为什么数据库不自己优化好"这个永恒问题——它已经很努力,但物理世界的信息不全与组合爆炸是数学事实。读懂执行计划的最高境界,就是看清墙在哪、然后优雅地递梯子。
各数据库执行计划的共性语言
执行计划的表面语法各家不同,但底层语言高度共通,掌握共通框架就能跨库迁移。算子的四大族:扫描族(全表、索引、区间——一切代价的起点)、连接族(嵌套循环适合小驱动、哈希适合大等值、归并适合有序——三者的选择逻辑全库一致)、排序聚合族(内存排序还是落盘、流式聚合还是哈希聚合——看内存预算与输入是否有序)、传数据(行数与宽度的估算贯穿全程)。读法的三个通用问题:实际行数与估算差几倍(统计质量)、最贵的算子占几成(主攻方向)、有没有"不该有的算子"(小结果集却排序、可用索引却在扫全表)。工具的对应关系:每家都有"看真实执行统计"的开关(执行后附实际行数与时间),这是比纯计划树更可靠的证据——估算骗人,实测不骗。共通框架的实践价值:学会一个库的执行计划分析,换库时的迁移成本只剩"查语法手册对照算子名"的一小时——性能分析能力的可迁移性,远高于具体命令的记忆。
执行计划的五个危险信号
执行计划里有一组"看到就要警惕"的危险信号,单独列出。信号一,大表全扫描出现在等值条件上——该有索引的位置没有索引行为,先查索引存在性与写法陷阱。信号二,估算行数与实际差一个量级以上——统计或相关性问题,计划的可信度归零,先修统计再看计划。信号三,排序落盘——内存工作区不足的标志,小结果集的排序落盘是配置问题,大结果集的排序落盘是设计问题(该问为什么排序这么多行)。信号四,嵌套循环的外层是大表——连接顺序反了(优化器误判或信息缺失),大表驱动小表是灾难公式。信号五,过滤条件出现在连接之后——本可以先过滤再连接(减少中间结果),优化器没下推或写法阻止了下推。五个信号都有明确的下一步动作,把它们背下来,执行计划的阅读就有了"异常优先"的雷达——先扫信号、再看代价、最后定方案。
再补一个练习建议:每周挑一条"看得懂但不明白为什么这么执行"的计划,花二十分钟把每个算子的选择理由写出来(为什么这个连接方式、为什么这个访问路径),写不出的地方查文档或做小实验验证。一个月四条,执行计划的"语感"就建立起来了——它和学外语的原理一样,靠的是高频小剂量的真实材料,不是突击背单词。
再补三个跨库通用的观察技巧:其一,先看计划树的"宽度"——同一层的分支越多,中间结果越可能膨胀,通常胖树不如瘦树健康;其二,看谓词的位置——过滤条件离数据源越近越好(下推到位),出现在连接之后的过滤是"先搬全量再扔大半"的浪费信号;其三,看分区裁剪信息(分区表上)——计划里是否明确显示只扫了目标分区,裁剪失效时分区表退化成慢速全扫。三个观察点都不依赖具体数据库的语法,是执行计划分析里"跨库通用的语感"——练成之后,任何一家新产品拿到手,看十分钟计划树就能大致判断它的执行健康度。
最后送一个工具层面的建议:给执行计划的采集建一个"计划标本库"——代表性查询的典型计划(好的坏的都收)加注释定期更新;新人培训用它的坏标本练诊断、排障时用它的好标本做对照、版本升级时用它做迁移对比。标本库是执行计划知识的物化形态,建库成本是每周十分钟,它是把个人经验变成团队资产的又一条廉价路径。