3.3 分区表与大数据管理
3.3 分区表与大数据管理
本节摘要:单表千万行级查询维护吃力,分区把大表拆小。本节讲清楚分区类型(范围/列表/哈希)、分区裁剪、分区维护、何时分区何时分片,让你管理大表不慌。
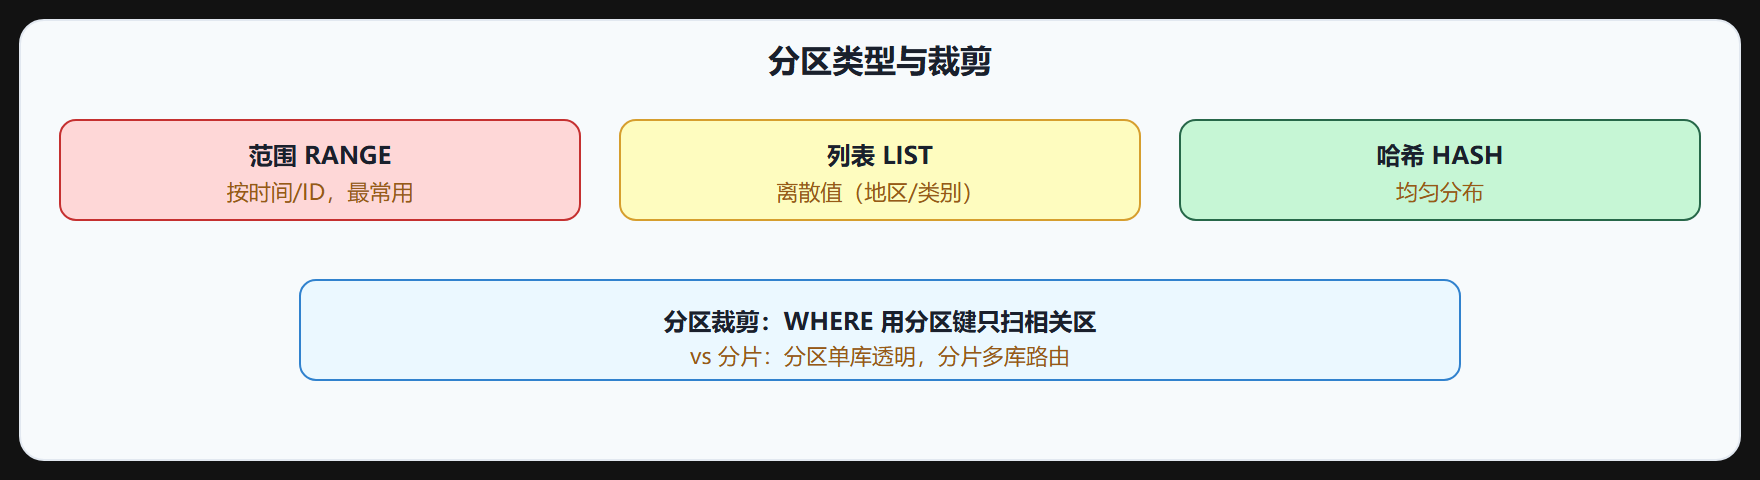
为什么分区
分区(Partitioning):把一个大表物理拆成多个小表(分区),逻辑上还是一个表。
好处:
- 分区裁剪:查询只扫相关分区,不扫全表。如按月分区,查 1 月只扫 1 月分区。
- 维护方便:归档/删除老数据删分区(DROP PARTITION)快,不用 DELETE。
- 并行 IO:不同分区可放不同磁盘,并行。
- 索引小:每分区独立索引,比全表索引小。
适用:大表(千万行+)、有时间维度(按月/年分区)、需要快速归档。
不适用:小表(分区开销大于收益)、无明显分区键、查询跨所有分区。
分区类型
1. 范围分区(RANGE)
- 按值范围分区,最常用。
- 适合时间、ID 范围。
- 例:订单按月分区。
-- MySQL 范围分区 CREATE TABLE orders ( id BIGINT, create_time DATETIME, ... ) PARTITION BY RANGE (TO_DAYS(create_time)) ( PARTITION p202401 VALUES LESS THAN (TO_DAYS('2024-02-01')), PARTITION p202402 VALUES LESS THAN (TO_DAYS('2024-03-01')), PARTITION pmax VALUES LESS THAN MAXVALUE );
2. 列表分区(LIST)
- 按离散值分区。
- 适合地区、类别。
- 例:按地区分区。
PARTITION BY LIST (region) ( PARTITION p_north VALUES IN ('北京','天津','河北'), PARTITION p_south VALUES IN ('广东','广西','海南') );
3. 哈希分区(HASH)
- 按哈希值分区,均匀分布。
- 适合无明显分区键、要均匀。
- 例:按 user_id 哈希分 8 区。
PARTITION BY HASH(user_id) PARTITIONS 8;
4. 键分区(KEY)
- 类似哈希,用数据库内置哈希。
- MySQL 支持,适合主键分区。
5. 复合分区(SUBPARTITION)
- 两级分区,如范围+哈希。
- 先按月范围,再每月按用户哈希。
- 复杂,谨慎用。
分区裁剪
分区裁剪(Partition Pruning):优化器根据 WHERE 条件只扫相关分区。
- 范围分区:WHERE create_time BETWEEN '2024-01-01' AND '2024-01-31' 只扫 p202401。
- 列表分区:WHERE region='北京' 只扫 p_north。
- 哈希分区:WHERE user_id=123 裁剪到某分区(但范围查询扫多区)。
裁剪条件:WHERE 用分区键。若 WHERE 不含分区键,扫所有分区(无裁剪)。
设计:查询常用过滤列作分区键,确保裁剪生效。
分区维护
1. 添加分区
- 新数据来前添加新分区。
- 范围分区:ADD PARTITION。
- 提前添加——避免数据落入 MAXVALUE 分区难拆。
2. 删除/归档分区
- 老数据归档:DROP PARTITION 删分区(快,不记 undo)。
- 归档:先 ALTER TABLE ... EXCHANGE PARTITION 换到归档表,再删。
- 比 DELETE 快——DELETE 逐行删记 undo/redo,DROP PARTITION 直接删文件。
3. 分区重组
- ALTER TABLE REORGANIZE PARTITION 合并/拆分分区。
- 大分区拆小、小分区合并。
4. 分区维护操作
- ANALYZE PARTITION:更新分区统计。
- CHECK PARTITION:检查分区完整性。
- OPTIMIZE PARTITION:重建分区回收空间。
- REBUILD PARTITION:重建分区。
5. 自动化
- 用脚本/事件定期添加分区(如每月加下月分区)。
- 监控分区数据量,不均时重组。
分区 vs 分片
分区:单库内拆表,DB 透明管理,应用无感。
分片(Sharding):跨多库拆表,应用或中间件路由。
分区适合:
- 单库能扛(CPU/IO/内存够)。
- 数据量大但单库可处理。
- 简化大表管理。
分片适合:
- 单库扛不住(CPU/IO/内存/连接瓶颈)。
- 数据量超大(亿级+)。
- 需要水平扩展。
路径:先分区(简单),单库瓶颈再分片(复杂)。分片要应用改造(路由),分区不用。
分区的坑
1. 分区键约束
- MySQL:分区键必须是主键/唯一键的一部分(或主键含分区键)。
- 否则报错。设计主键要考虑分区键。
2. 跨分区查询
- 查询跨多分区——并行但总数据量不变。
- 聚合跨分区——要合并各分区结果,慢。
- JOIN 跨分区——复杂,尽量同分区键。
3. 分区不均
- 哈希分区均匀,范围/列表可能不均(如某月数据多)。
- 不均导致某分区热点。监控各分区大小。
4. 全局索引
- MySQL 分区无全局索引(每分区独立索引)。
- 非分区键查询扫所有分区索引。Oracle 支持全局索引。
5. 外键
- MySQL 分区表不支持外键。
- 应用层保证一致性。
⚠️ 常见误读:以为"分区总是提性能"。分区只在分区裁剪生效时提性能,非分区键查询扫所有分区可能更慢(多分区开销)。要按查询模式选分区键。
💡 关键直觉:分区把大表物理拆小逻辑统一。类型——范围(时间/ID 最常用)、列表(地区/类别离散值)、哈希(均匀分布)、键(内置哈希)、复合(两级)。分区裁剪(WHERE 分区键只扫相关区,非分区键扫全表)。维护——添加(提前加避免 MAXVALUE)、删除归档(DROP PARTITION 比 DELETE 快,EXCHANGE 换归档表)、重组(合并/拆分)、统计/检查/优化/重建、自动化定期加分区。vs 分片——分区单库透明应用无感,分片多库应用路由,先分区单库扛再分片。坑——分区键必须主键一部分、跨分区查询慢、分区不均热点、MySQL 无全局索引(非分区键扫所有区)、分区表无外键。
分区要点小结
- 分区价值:大表物理拆小逻辑统一,分区裁剪(只扫相关区)、维护方便(DROP PARTITION 归档快)、并行 IO、索引小。适用千万+大表有时间维度需归档,不适用小表无分区键。
- 分区类型:范围(RANGE 时间/ID 最常用,TO_DAYS)、列表(LIST 地区/类别离散值 IN)、哈希(HASH 均匀分布 PARTITIONS N)、键(KEY 内置哈希)、复合(两级 SUBPARTITION)。
- 分区裁剪:WHERE 用分区键只扫相关分区,不用扫全表。设计查询常用过滤列作分区键。哈希范围查询扫多区。
- 维护:添加(提前加避免 MAXVALUE)、删除归档(DROP PARTITION 比 DELETE 快不记 undo,EXCHANGE PARTITION 换归档表再删)、重组(REORGANIZE 合并/拆分)、ANALYZE/CHECK/OPTIMIZE/REBUILD、自动化定期加。
- vs 分片:分区单库透明应用无感,分片跨库应用/中间件路由。分区单库能扛简化管理,分片单库扛不住亿级+水平扩展。先分区再分片。
- 坑:分区键必须主键/唯一键一部分(MySQL 约束)、跨分区查询慢(聚合合并/JOIN 复杂)、分区不均热点(哈希均匀范围/列表可能不均)、MySQL 无全局索引(非分区键扫所有区索引)、分区表无外键(应用层保证)。
分区键选择的决策树
分区的成败几乎全系于分区键的选择,给一棵决策树。第一问,查询是否带分区键? 大部分高频查询必须包含分区键,否则分区表退化为"每次查所有分区的联合"反而更慢——按时间查询为主的表选时间分区,按租户隔离为主的表选租户分区。第二问,数据是否有天然的生命周期? 有(如日志、订单按月归档)则时间分区一举两得:查询裁剪与归档删除都变成分区级操作,删一个月数据从"逐行删除加日志膨胀"变成"直接摘除分区",这是分区最大的红利之一。第三问,分布是否均匀? 分区键的数据倾斜会导致个别分区成为热点(某大租户的分区比其他所有分区加起来还大),倾斜超过三倍就要考虑二级拆分或哈希重分布。第四问,单分区规模是否可控? 每个分区的行数与索引高度维持在舒适区(千万级以内大多数引擎表现稳定),超过就细分。四问走完,分区方案的基本盘就定了。最后补一个反直觉提醒:分区不是"大表优化"的默认答案——很多大表的正确解法是索引与查询优化,分区只在"查询可裁剪、数据有生命周期、分布可控"三条件齐备时才是主力,为分区而分区是常见的过度设计。
分区运维的三项纪律
分区表的日常运维有三项纪律,缺一项就会在某个深夜兑现代价。纪律一,分区预建:时间分区要保证"未来分区已建好"——按月分区的表每月检查未来三个月的分区存在,自动建分区的脚本加失败告警;"插入时发现分区不存在"的报错在月底流量高峰出现,是最冤的故障。纪律二,分区统计独立维护:每个分区的统计信息独立收集(尤其刚建的新分区),优化器对空分区与满分区的估算策略不同——分区级统计是大表统计策略的必修组成部分(与第 5 章呼应)。纪律三,分区操作窗口化:摘除、交换、合并分区虽是元数据级操作,但伴随的缓存失效与计划重编译会造成短暂抖动——放低峰窗口执行,并知会应用侧。三项纪律的共同点是把"分区的好处"与"分区的义务"一起接收:分区让归档变成秒级操作,前提是你记得提前把明天的房间打扫好。
分区的监控与预案
分区章收官补两份运维文档的模板。监控模板:分区数量与大小分布(倾斜告警)、未来分区预建状态(缺失即告警)、单分区行数接近舒适上限的预警、分区级查询命中统计(裁剪失效的早期发现)。预案模板:分区缺失的自动补建与人工兜底流程、热点分区的紧急再平衡步骤(含业务影响评估)、分区维护操作的窗口与回滚方法、跨分区查询劣化的临时限流方案。两份模板的深层意义:分区是"结构化的承诺"——你向优化器承诺了查询模式(都带分区键)、向运维承诺了生命周期管理(预建与归档)——监控与预案就是承诺的对账单。没这两份文档的分区表,是把承诺只写在了建表语句里,而兑现全靠运气——运气总有用完的一天,文档比运气便宜。
分区问答两则
问:已有的大表能在线转成分区表吗? 答:能但工程量大——主流路径是新建分区表加双写迁移加切换(影子表方案的分区版),窗口期长、协调成本高;因此分区的最佳时机是建表前(预测会大就先分区),次佳是"还不够大但趋势明确"时(迁移对象还小)。问:分区数有没有上限的实践经验? 答:单表分区数在几百以内时管理成本平缓,上千后元数据操作(优化器裁剪、统计收集)的开销开始可感——按月分区撑十年就是一百二,安全;按天分区撑十年就三千多,要改按周或按月。两问的共同答案指向同一个时间观:分区决策的输入是"这张表三年后的样子"——设计时把时间望远镜拿出来看一眼,比三年后拿工程队来改造便宜一个数量级。
最后补一个与查询模式的联动提醒:分区表的索引策略要跟着分区键走——全局索引与分区索引的取舍(全局索引支持跨分区唯一性但维护贵、分区索引便宜但要分区键配合)是分区表的最后一道选择题;经验起点是"唯一约束包含分区键就用分区索引,否则权衡全局",把这个选择题做在设计期,别留给故障期。
补一个真实的教训作注脚:某系统按天分区跑了一年多,某天凌晨批量任务报"分区不存在"——维护脚本的人换了、新一天的分区没建、告警发到了没人看的邮箱;故障本身十分钟修复,但它揭示的三个薄弱点(分区预建的自动化、告警的责任人、交接文档)值得每个用分区的系统自查。分区把大表的运维变成了"日程管理",日程管理的第一课就是:闹钟要有人听。