4.1 内存参数调优
4.1 内存参数调优
本节摘要:内存是数据库性能第一利器——数据在内存不用读盘。本节讲清楚缓冲池、查询缓存、排序区、连接缓冲等内存参数调优,让数据库尽量在内存操作。
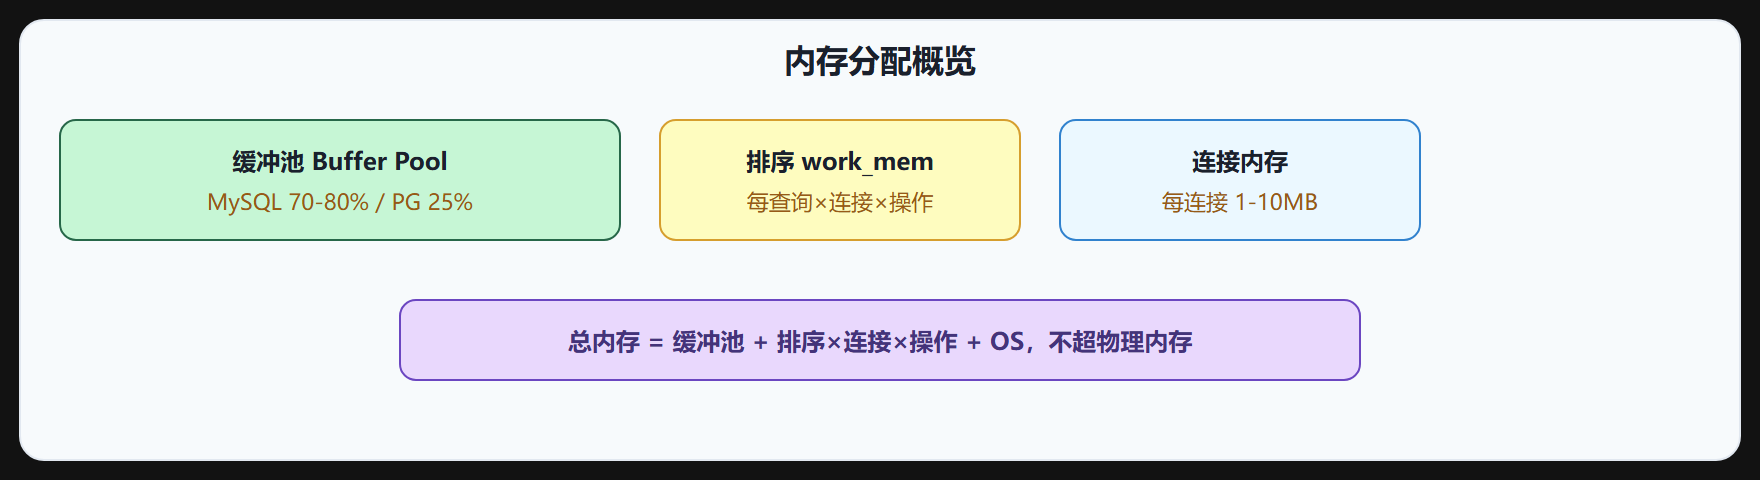
为什么内存最重要
数据库性能瓶颈通常是 IO(磁盘慢)。内存缓存数据避免读盘——内存访问纳秒级,磁盘毫秒级,差 10 万倍。
内存参数调优目标:
- 尽量多数据放内存(缓冲池大)。
- 排序/聚合在内存完成(不落盘)。
- 减少读盘 IO。
前提:内存够大。内存不够则参数再大也用不上(或 swap 更慢)。
InnoDB 缓冲池(Buffer Pool)
innodb_buffer_pool_size——InnoDB 最重要的参数。
作用:缓存数据页和索引页。数据在缓冲池则内存访问,否则读盘。
调优:
- 大小:专用 DB 服务器设 70-80% 物理内存。如 64GB 内存设 48-52GB。
- 多实例:innodb_buffer_pool_instances,大缓冲池分多实例减少锁竞争(>1GB 时设 8-16)。
- 预热:重启后缓冲池空,慢。MySQL 5.6+ 支持缓冲池预热(保存/加载)。
- 监控:InnoDB Buffer Pool Hit Rate(命中率),应 > 99%。低则缓冲池不够。
其他 InnoDB 内存参数:
- innodb_log_buffer_size:redo log 缓冲,大事务调大(如 16-64MB)。
- innodb_additional_mem_pool_size:8.0 移除(内存池自动管理)。
PostgreSQL 内存参数
shared_buffers——PG 最重要的参数。
作用:共享缓冲池缓存数据页。
调优:
- 大小:专用 DB 设 25% 物理内存(PG 推荐值,因 PG 还用 OS 缓存)。
- 如 64GB 内存设 16GB。
- 监控:pg_stat_bgwriter 的 buffers_hit/buffers_alloc,命中率应 > 99%。
work_mem:排序/聚合内存区。
- 每查询每操作分配——如 ORDER BY 用 work_mem,不够则落盘。
- 调大避免落盘——但注意每查询多操作,总内存 = work_mem × 连接数 × 操作数,过大 OOM。
- 默认 4MB,调到 16-64MB(按内存和连接数算)。
maintenance_work_mem:维护操作(VACUUM/CREATE INDEX)内存。
- 调大加速 VACUUM/建索引——如 1-2GB。
- 只维护操作用,不影响查询。
effective_cache_size:告诉优化器 OS 缓存大小,影响执行计划选择。
- 设为 OS 可用缓存(通常物理内存 - shared_buffers)。
- 如 64GB 内存,shared_buffers 16GB,effective_cache_size 48GB。
- 不分配内存,只是优化器参考。
MySQL 查询缓存(Query Cache)
query_cache_size——MySQL 查询缓存。
注意:MySQL 8.0 已移除查询缓存,因:
- 失效开销大——表更新失效所有相关缓存。
- 高并发锁竞争——查询缓存全局锁。
- 命中率低——多数场景 miss 多。
8.0 前:读多写少且结果稳定可用,但通常弊大于利。替代:应用层缓存(Redis)。
排序与连接缓冲
MySQL:
- sort_buffer_size:每连接排序缓冲。默认 256KB,大排序调到 1-4MB。过大每连接占多,OOM。
- join_buffer_size:JOIN 无索引时缓冲。调大减少扫描次数,但应加索引而非靠缓冲。
- read_buffer_size/read_rnd_buffer_size:表扫描缓冲。
- tmp_table_size/max_heap_table_size:临时表内存大小,超过则落盘。调大避免落盘。
PostgreSQL:
- work_mem 覆盖排序/聚合/临时表。
原则:排序/聚合缓冲调大到不落盘即可,不是越大越好(每连接/每操作分配,总内存爆炸)。
内存调优流程
1. 看内存使用
- free -g / vmstat——系统内存。
- 数据库内存指标——缓冲池命中率、内存使用。
2. 调缓冲池
- 命中率 < 99%——加大缓冲池(如内存够)。
- 加到物理内存上限的 70-80%(MySQL)/25%(PG)。
3. 调排序/临时
- 慢查询有 filesort/Using temporary——调大 sort_buffer/tmp_table_size/work_mem。
- 监控落盘——show status like 'Created_tmp_disk_tables',高则调大。
4. 算总内存
- 总内存 = 缓冲池 + (排序/连接缓冲 × 连接数 × 每查询操作数)。
- 确保不超物理内存,留余量给 OS 和其他。
5. 监控 swap
- swap 使用高——内存不够,调小参数或加内存。
- swap 比读盘还慢,要避免。
内存监控指标
- 缓冲池命中率:> 99% 为好。低则缓冲池不够或热数据超内存。
- 缓冲池等待:等待空闲页——缓冲池不够。
- 排序落盘:sort_merge_passes(MySQL)/ external merge(PG)——排序缓冲不够。
- 临时表落盘:Created_tmp_disk_tables——临时表缓冲不够。
- swap 使用:应接近 0。
⚠️ 常见误读:以为"缓冲越大越好"。缓冲池受物理内存限制,且要留 OS 和其他。排序缓冲每连接每操作分配,过大 × 连接数 OOM。要算总内存。
💡 关键直觉:内存最重要——内存访问纳秒 vs 磁盘毫秒差 10 万倍。InnoDB buffer_pool_size(专用 DB 70-80% 物理内存,多实例减锁,预热,命中率 >99%)、log_buffer(大事务调大)。PG shared_buffers(25% 物理内存,PG 还用 OS 缓存)、work_mem(排序/聚合每查询每操作,默认 4MB 调 16-64MB,总=work_mem×连接×操作算 OOM)、maintenance_work_mem(VACUUM/建索引 1-2GB)、effective_cache_size(优化器参考不分配)。MySQL 查询缓存 8.0 移除(失效开销大/锁竞争/命中率低,用 Redis 替代)。排序/连接缓冲(sort_buffer/join_buffer/tmp_table_size 调大避免落盘,每连接分配算总内存)。流程:看内存使用→调缓冲池(命中率 <99% 加大)→调排序/临时(监控 filesort/Using temporary)→算总内存→监控 swap 接近 0。
内存调优要点
- 内存最重要:内存纳秒 vs 磁盘毫秒差 10 万倍,内存缓存数据避免读盘。目标:多数据放内存、排序/聚合内存完成、减读盘。前提内存够。
- InnoDB 缓冲池:innodb_buffer_pool_size 专用 DB 70-80% 物理内存,多实例(>1GB 设 8-16 减锁),预热(5.6+ 保存/加载),监控命中率 >99% 低则不够。log_buffer 大事务 16-64MB。
- PG 内存:shared_buffers 25% 物理内存(PG 还用 OS 缓存),命中率 >99%。work_mem 排序/聚合每查询每操作分配,默认 4MB 调 16-64MB,总=work_mem×连接×操作算 OOM。maintenance_work_mem VACUUM/建索引 1-2GB。effective_cache_size 优化器参考不分配(物理内存-shared_buffers)。
- MySQL 查询缓存:8.0 移除(失效开销大/全局锁/命中率低),8.0 前读多写少稳定可用但通常弊大于利,用 Redis 替代。
- 排序/连接缓冲:MySQL sort_buffer_size(256KB 调 1-4MB)、join_buffer_size(应加索引非靠缓冲)、tmp_table_size/max_heap_table_size(临时表内存超则落盘调大避免)。PG work_mem 覆盖。原则调大到不落盘即可,不是越大越好。
- 调优流程:看内存使用(free/vmstat/数据库指标)→调缓冲池(命中率 <99% 加大到 70-80%/25%)→调排序/临时(监控 filesort/Created_tmp_disk_tables 调大)→算总内存(缓冲池+缓冲×连接×操作不超物理内存)→监控 swap 接近 0。
- 监控指标:缓冲池命中率 >99%、缓冲池等待空闲页、排序落盘(sort_merge_passes/external merge)、临时表落盘(Created_tmp_disk_tables)、swap 使用接近 0。
内存分配的全局观
内存参数不是孤立的旋钮,而是一份预算的分配方案,调优前先建立全局观。一台数据库服务器的内存切成几块:操作系统与文件系统缓存(要留,别全给数据库)、数据库进程自身(代码与连接内存,随连接数增长)、缓冲池(最大头,数据页的居住地)、各类工作区(排序、哈希、连接的临时空间)。分配的次序原则:先保操作系统的底线(通常几个点到一成),再按"独享工作区乘以最大并发"预留工作区上限,剩余的大头给缓冲池——颠倒了次序(先设大缓冲池再算工作区)就会出现高并发时内存不足、临时落盘的隐性劣化。调整的观察指标:缓冲池命中率与脏页比例(缓冲池是否够)、临时表落盘次数(工作区是否够)、交换区活动(总预算是否超了物理内存——一旦开始换页,所有优化清零)。内存调优的终点状态是三条曲线的稳态:命中率高位平稳、脏页在刷写能力内、零换页。达到这个状态后,继续加内存的边际收益递减——钱该花去第 6 章的层了。
缓冲池命中的三层分析
内存章的收官给缓冲池命中率的深度分析方法——这个指标看似简单(命中率九成九很好),其实分层才有信息量。层一,全局命中率的陷阱:全局九成九的命中率下可能藏着一类查询命中率只有七成(热表近百分百拉高了平均)——全局指标是遮羞布,按表或按页类型分解才见真相。层二,命中与年龄的关系:新加载的页天然未命中,批量任务(报表、导出)会短暂拉低命中率——把命中率按时间切片与任务对齐,区分"结构性的缓存不足"与"任务性的正常抖动"。层三,工作集的变迁:业务形态变化(新模块上线、数据量增长)让热数据慢慢超过缓冲池容量,命中率以每月零点几个百分点的速度阴跌——这种慢性病用月度趋势图才能看见,日视图里它就是噪音。三层分析做完,"要不要加内存"就不再是感觉题:结构性不足(分解后仍低且与任务无关、趋势阴跌)加内存立竿见影;任务性抖动加内存是浪费,限流任务或错峰才是解。指标分析的功力,全在这种"从单一数字到分层证据"的展开里。
内存参数的压测校准法
内存章给一个压测校准的操作模板,让参数设置摆脱文档抄作业。第一步,负载画像:用生产流量录制或回放工具,准备能代表峰值形态的压测脚本(读写比、数据访问分布要与真实接近——随机均匀的压测会得出误导性的缓存结论)。第二步,阶梯实验:缓冲池从小到大取五档,每档跑同负载,记录命中率、时延、IO 量——画出"命中率与缓冲池大小"的关系曲线,找到拐点。第三步,定点验证:拐点后的下一档做七十二小时长稳(防慢性泄漏与碎片化侵蚀),确认稳定。第四步,登记入册:参数值、曲线图、实验条件写入参数台账,下次升级数据库版本时重跑。这套方法每次一个周末的工作量,换来的不是"最优参数"(它不存在)而是"有据可依的参数"——台账里的曲线比任何论坛帖子的推荐值都更属于你的系统。参数调优的成熟标志,就是团队讨论参数时引用自己的实验曲线,而不是别人的博客。
内存问答两则
问:缓冲池到底设多大,有没有一步到位的公式? 答:物理内存减系统预留减连接工作区上限后全给缓冲池——但"一步到位"的心态要不得:先按公式起步,跑两周命中率曲线,再按拐点微调;内存参数是"先算后测再定"的三段式,不是一锤子买卖。问:加内存后命中率没升反降,怎么回事? 答:三个常见原因——工作集被新业务扩大(加的量被新流量吃掉,看分表命中率定位)、批量任务污染缓冲(新内存让大扫描跑得更欢、冲掉的页更多,给批量限流或独立实例)、统计口径变化(监控的重启计数器没清零)。内存问题的排查口诀:先看分解(哪类命中率降)、再看时间线(与什么变更对齐)、最后看任务(谁在污染)——顺序对了,怪事不怪。
补最后一个细节:内存参数变更后的观察期里,除了命中率与等待,还要看"数据库启动后的预热时长"——重启后缓存从冷到热的爬坡时间会随缓冲池变大而拉长(几十GB的池预热可能以小时计),主从切换频繁的系统要为预热期留缓冲(比如提高预热优先级或错峰切换),这是大内存配置的隐性代价,账要算全。
补一个容量弹性场景的提醒:云上或资源池化的环境里,内存参数要为"弹性伸缩"预留设计——动态调整内存的数据库(部分新版本支持在线调缓冲池)在缩容时的脏页回刷要时间,缩容操作的编排要留这个窗口;固定内存的环境里,超卖(多实例内存配额之和超过物理内存)是常见的隐性雷区,部署表上永远要有一列"物理机内存与已分配总和"的对账——内存这个资源,超卖的那一刻就已经开始收费(以换页的形式)。